概要
MPPI(Model Predictive Path Integral 制御)は、入力列の計画のまわりに乱数で多数の入力列を作り、それぞれの未来をモデルで計算して、コストの小さいものほど重く平均して計画を直すことを、毎時刻くり返すモデル予測制御である。
このページの数値例で使う形(基準の分布を今の計画のまわりの分布にとる形)では、各入力列の重みは、その入力列のコストを、温度と呼ぶ正の定数で割った値の符号を変えて指数をとったものに比例する。基準の分布を別に置く一般の形では、2つの分布の密度の比も重みに掛かる(基準の分布の選び方)。重みの形は経験則ではなく、「入力列の分布についてのコストの期待値」と「その分布が基準の分布からどれだけ離れているか(KL ダイバージェンス)の温度倍」の和を最小にする分布から導かれる。モデルとコストの微分を使わず、コストの値だけを使うので、不連続なコストや微分できないモデルにも使える。入力列ごとの計算は互いに独立なので、並列に計算できる。
名前の Path Integral(経路積分)は、MPPI のもとになった経路積分制御から来ている。経路積分制御は、入力について系がアフィン(入力の1次式)で、さらに雑音の共分散行列が「入力の係数行列・入力の2次コストの重み行列の逆行列・入力の係数行列の転置」の積に比例する(Kappen 2005 の式(12)。入力と状態の次元が同じで入力の係数行列が単位行列なら、入力の2次コストの重み行列が雑音の共分散行列の逆行列に比例する)ときに、最適制御の価値関数の指数をとって Hamilton–Jacobi–Bellman 方程式を線形にし、その解をすべての経路についての期待値(経路積分)で表す(Kappen 2005、Williams ほか ICRA 2017 の第 II 節)。このページの導出はその条件を使わず、Williams ほか(ICRA 2017)の、KL ダイバージェンスと自由エネルギーによる導き方に従う。
読者は、状態方程式・評価関数・モデル予測制御の考え方を知っているが、確率分布の KL ダイバージェンス・重点サンプリング・自由エネルギーは知らない人を想定する。これらはこのページの中で定義してから使う。
読む順路は次のとおり。
- MPPI で何ができるか:使える条件、使われている例、よくある誤解。
- 記号:系・コスト・入力列・乱数・確率分布の記号と、KL ダイバージェンス。
- 問題の設定:有限ホライズンの最適制御と、それを毎時刻解き直すモデル予測制御。勾配を使う方法と比べた位置づけ。
- MPPI の導出:自由エネルギーの不等式、最適な分布、正規分布での近似、重点サンプリングによる重みと更新の式。
- アルゴリズム:手順と、温度・乱数の共分散・サンプル数・ホライズンの効き方。
- 数値例:障害物を避けて目標へ向かう平面上の点ロボットで、実際に計算した結果。
- ほかの方法との比較:ランダムシューティング・交差エントロピー法・iLQR/DDP。
- 限界と改良。
- 確かめ問題、確認できていない点、参考。
MPPI で何ができるか
この章では、MPPI に何が要り、何が得られるかを、式を使わずに示す。式による定義は記号の章から始める。
使える条件
MPPI に要るものは次の3つである。
- 状態と入力から次の時刻の状態を計算するモデル。関数の形に制限は無く、微分も要らない。物理シミュレータやニューラルネットワークでもよい。
- 未来の軌道に付けるコスト。軌道の関数であれば何でもよく、障害物に入ったら一定の値を足すような不連続な項を含んでよい。
- 1制御周期の間に、モデルを「サンプル数 × ホライズンのステップ数」回計算できる計算資源。入力列ごとの計算は互いに独立なので、GPU やベクトル演算で並列に計算できる。
得られるのは、毎時刻の入力である。MPPI は、毎時刻、今の状態から先の入力列の計画を1回(または数回)直し、その先頭を系に加える。
使われている例
この節では、MPPI を提案した論文と、使われているソフトウェアを挙げる。いずれも題名・著者・概要を確かめたもの(2026-10-22)で、本文を読んだ範囲は確認できていない点に書いた。
論文とソフトウェア
- Williams, Drews, Goldfain, Rehg, Theodorou「Aggressive Driving with Model Predictive Path Integral Control」(ICRA 2016)。自由エネルギーと相対エントロピー(KL ダイバージェンス)による確率的最適制御の枠組みから、最適な入力を経路積分の形で表し、効率のよい重点サンプリングで近似する。GPU に実装し、5分の1の大きさの自動車(AutoRally)の攻撃的な走行(aggressive driving)の課題に使った。
- Williams, Wagener, Goldfain, Drews, Rehg, Boots, Theodorou「Information Theoretic MPC for Model-Based Reinforcement Learning」(ICRA 2017)。それまでの MPPI が必要としていた「入力について系がアフィン」という条件を外し、このページの導出と同じ形で更新の式を導いた。モデルを学習したニューラルネットワークにして、台車倒立振子の振り上げ・クアッドロータの障害物回避(シミュレーション)と AutoRally の走行(実機)を行った。実機では、ホライズン 2.5 秒、制御周期 40 Hz、1時刻あたり 1200 本のサンプルを、GPU(GTX 750 Ti)で計算した。
- Williams, Drews, Goldfain, Rehg, Theodorou「Information-Theoretic Model Predictive Control: Theory and Applications to Autonomous Driving」(IEEE Transactions on Robotics、2018)。同じ枠組みを詳しく述べ、交差エントロピー法をモデル予測制御にしたもの(このページの交差エントロピー法)と実機で比べた。基準の分布の平均を今の計画に寄せる変更(このページの基準の分布の選び方)もこの論文にある。
- ROS 2 の移動ロボット用ナビゲーションのソフトウェア Nav2 の
nav2_mppi_controller。README によれば、経路に沿って障害物を避けながら走る局所的な計画に MPPI を使い、差動二輪・全方向移動・アッカーマン(自動車型)の移動ロボットに対応し、第4世代 Core i5 の CPU で 50 Hz 以上で動く。サンプル数の既定値は 1000、ホライズンの既定値は 56 ステップ(0.05 秒刻み)である。
よくある誤解
この節では、MPPI について持たれやすい誤解を先に挙げる。中央の列の内容は、右の列の節で式や数値で確かめる。
| 誤解 | 実際 | 確かめる節 |
|---|---|---|
| サンプルした入力列の中から、コストが最も小さい1本を選ぶ | 全サンプルの重み付き平均をとる。最も小さい1本を選ぶのは、温度を 0 に近づけた極限である | 温度の極限 |
| 入力に雑音が乗る系でなければ使えない | 原論文は、指令した入力に正規分布の雑音が乗って系に入る、として導いた。ただし導出は、コストが入力列の関数であることしか使わないので、乱数を探索のために計画に足すものと読み替えても成り立つ。このページはそう読み替え、モデルは決定的とする | 入力列と乱数 |
| 重みの は、良いものを重くするための経験則である | コストの期待値と KL ダイバージェンスの和を最小にする分布から導かれる | 自由エネルギーと最適な分布 |
| 温度は小さいほど良い | 数値例では、温度を小さくすると閉ループのコストはほとんど変わらないまま、入力の時間変化が大きくなった。温度の効き方は、コストの値の広がりに対する相対的な大きさで決まる | 温度の極限、サンプル数と温度を変えたとき |
| 勾配を使わないので、局所的な最小に止まらない | サンプルは今の計画のまわりに作るので、探すのは今の計画の近くである | 今の計画のまわりしか探さない |
| GPU が無いと使えない | このページの数値例では、CPU の numpy で、1024 本・30 ステップの1回の更新が約 6.7 ミリ秒で、制御周期 100 ミリ秒に収まった。Nav2 の README も、CPU で 50 Hz 以上で動くと書いている | 計算時間 |
記号
この章では、このページ全体で使う記号と、確率分布の離れ具合を表す KL ダイバージェンスを決める。章の途中で新しい記号を足すときは、その場で定義する。
系とコスト
- 時刻は整数 で数える。状態を 、モデルに入れる入力を とし、系のモデルを関数 で表す。
- 式(1) は決定的である。 と入力 が決まれば が1通りに決まる。(正の整数)をホライズンと呼ぶ。
- 入力列を と書く。 は 個の実数を並べたものである。
- ステージコストを 、終端コストを とし、 から入力列 で動かしたときの軌道のコストを次で定義する。以下、単に「コスト」と書いたら軌道のコスト を指す。
ここで は、式(1) で と から計算したものである。以下の導出は、 が の関数であることしか使わない。入力にコストを付けたいときは を のように入力も含む関数にしてよく、導出は変わらない。 は下に有界(ある定数より小さくならない)と仮定する。
入力列と乱数
- 入力列の計画を ()と書く。 は導出の中で動かす変数で、MPPI が今持っている計画は 、直した後の計画は と書いて区別する。
- 乱数を とし、 は互いに独立で、平均 0・共分散行列 の正規分布に従うとする。 は の正定値対称行列である。このページで は共分散行列だけを表し、和の記号 とは別の記号である。
- モデルに入れる入力を とする。つまり である。MPPI は、計画そのものではなく、計画に乱数を足した入力列をモデルに入れて軌道を調べる。系に実際に加えるのは、乱数を足していない計画の先頭である(手順)。
- 原論文(Williams ほか ICRA 2017 の第 III-A 節)は、入力 を指令すると系には が入る、つまり入力に雑音が乗る系として導いている。このページは、 を探索のために足す乱数と読み替える。導出は が の関数であることしか使わないので、どちらの読み方でも同じ式になる。
- 乱数を 組作るときは、 組目()を上付きの で 、そのときの入力を 、入力列を 、それを 式(1) に入れたときの状態を と書き、 とする。入力列 を 番目のサンプル、 をサンプル数と呼ぶ。サンプルの番号 は、時刻の添字 を持つ量(、、)とそれを並べた列(、)では上付きに、時刻の添字を持たない数( など)では下付きに書く。上付きの はべき乗ではない。
- 実際に系を動かす時刻(制御周期の番号)は で数え、ホライズンの中の時刻 と区別する。時刻 に測った状態を 、系に加えた入力を と書く。
- 温度 は正の定数である。役割は自由エネルギーと最適な分布で決まる。
確率分布
- の確率密度関数(以下、密度) について、関数 の期待値を と書く。積分は 全体でとる。このページの密度は、どれも のすべての点で正であるものだけを考える。
- 平均 ・共分散行列 の正規分布の密度を
と書く。
- 計画 に乱数を足した入力列 の密度を と書く。 が独立なので、各時刻の密度の積である。
- 基準の分布の密度 を、ある入力列 を平均とする同じ形の分布として決める。 の選び方は基準の分布の選び方で決める( か、今の計画 )。
- は自然対数である。
KL ダイバージェンス
この節では、2つの分布の離れ具合を表す量を定義し、正規分布どうしの値を求める。密度 と について、 の からの KL ダイバージェンス(Kullback–Leibler ダイバージェンス、相対エントロピーとも呼ぶ)を次で定義する。
で、等号は と がほとんど至るところで(体積 0 の集合を除いて)等しいときだけ成り立つ。証明は次の折りたたみにある。 と を入れかえると一般に値が変わるので、距離ではない。
詳しくはこちら(KL ダイバージェンスが 0 以上であることの証明)
イェンセンの不等式を使う。イェンセンの不等式は、凸関数 と確率変数 について が成り立ち、 が狭義の凸関数なら、等号は が確率 1 で定数のときだけ成り立つ、という定理である。
( で狭義の凸関数)と ( は に従う)に当てはめ、 を使うと、
である。等号は が確率 1 で定数のときだけで、 と はどちらも積分が 1 なのでその定数は 1、つまり と はほとんど至るところで等しい。
共分散が同じで平均だけが違う2つの正規分布 式(4) と 式(5) の比は、次の形になる。()と書き、計画と基準の差を とすると、
である。これの符号を変えて について期待値をとる。 は定数なので、期待値の線形性から となり、
となる。式(8) の導出は次の折りたたみにある。
詳しくはこちら(式(8) の導出)
式(4) と 式(5) はどちらも時刻ごとの密度の積なので、比の対数は時刻ごとの比の対数の和 になる。式(3) の前の定数( の逆数)は2つの密度で同じなので、比をとると消え、時刻 の項は
である。、 を入れて第1項を展開すると で、 が対称なので である。第2項の と打ち消し合う項をまとめると、
となる。 について足すと 式(8) である。
色
式の中と文中の色は次の量に付け、同じ量にはいつも同じ色を使う。軌道のコスト は青、温度 は橙、サンプルの重み(重点サンプリングで定義する)は緑である。図の色は数値例の設定で決める。
問題の設定
この章では、MPPI が解こうとする問題を決め、それを勾配を使う方法と比べてどう解くのかを示す。
有限ホライズンの最適制御
この節では、1つの時刻で解く問題を決める。今の状態 が与えられたとき、式(2) を最小にする入力列を求める問題である。
や が凸でない(例えば障害物を表す項がある)とき、式(12) には局所的な最小がいくつもありうる。 に「障害物の内側なら 1、外側なら 0」となる関数(指示関数)の定数倍があるとき、その項の についての微分は、障害物の境界にちょうど乗る場合を除いて 0 である(内側でも外側でも、少し動かしただけでは値が変わらないから)。
モデル予測制御
この節では、式(12) を毎時刻解き直す使い方を決める。モデル予測制御は、各時刻 で次をくり返す。
- 状態 を測り、 とする。
- 式(12) を(近似的に)解き、その解を入力列の計画 とする。乱数を使わない通常のモデル予測制御では、計画をそのままモデルに入れる()ので、式(12) の解がそのまま計画になる。MPPI は、2 の代わりに MPPI の導出の更新で計画を直す。
- を系に加える。
- 次の時刻のために計画を1つずらす(、最後の には決めておいた初期値を入れる)。
4 でずらした計画は、状態がモデルどおりに動いたなら、前の時刻に求めた計画のうちまだ使っていない部分そのものである。そのため、次の時刻の 2 では、何も無いところから解き直す代わりに、この計画を出発点にできる。MPPI は 2 を「ずらした計画を出発点にした1回(または数回)のサンプリングによる更新」で行う。1回の更新で 式(12) が解けるとは限らないが、時刻をまたいで更新が重なる。
勾配を使う方法との違い
この節では、MPPI が 式(12) をどういう形に置きかえて解くのかを、勾配を使う方法と比べて示す。
勾配を使う方法の代表である iLQR(iterative Linear Quadratic Regulator)は、今の計画のまわりで を1次式で、 と を2次式で近似し、近似した問題(線形のモデルと2次のコスト)を時刻の後ろから前へ順に解いて計画を直すことをくり返す。DDP(Differential Dynamic Programming)は同じ手順で、 をさらに2次式で近似する( の2階の微分も使う)。どちらも ・・ の微分が要り、上の指示関数のように、境界の上では微分できず、それ以外では微分が 0 になる項は、計画の直し方に影響しない。
MPPI は、入力列 そのものではなく、 の分布 を選ぶ問題に置きかえる。KL ダイバージェンス 式(6) と温度 を使って、
を小さくする分布を探す。第1項は、分布 に従って入力列を選んだときのコストの期待値、第2項は が基準の分布 からどれだけ離れているかの 倍である。次の章で示すとおり、式(13) を最小にする分布は式で書け、その平均は の値だけから(微分を使わずに)推定できる。
MPPI の導出
この章では、式(13) から MPPI の更新の式を導く。式(13) の最小値と最小にする分布 を求め、 に近い正規分布を選び、その平均をサンプルで推定する式を作る。最後に、基準の平均 の2つの選び方を比べる。
自由エネルギーと最適な分布
この節では、式(13) がどの分布 に対しても下回れない値(下界)と、それに届く唯一の分布 を求める。自由エネルギーを次で定義する。
は下に有界と仮定した(系とコスト)ので、 は有界で正、その期待値は正の有限の値になり、式(14) は定義できる。この期待値を と書く。
さらに、密度 を次で定義する。式(15) で割っているので、 で、 は密度である。
は、基準の分布 のうち、コストの小さい入力列ほど重くした分布である。コストに下界があり ( は定数)とすると、 が で有界であることから は の定数倍で抑えられ、 と はどちらも有限である。このとき、 と がどちらも有限な任意の密度 について、次の等式が成り立つ( の では 式(13) が になるので、そのような は最小を与える候補にならない)。
式(17) は次のように示せる。式(16) の対数をとると なので、
である。式(18) の両辺の についての期待値をとり(右辺の各項の期待値は、仮定と 式(16) から有限である)、式(6) を使うと となる。両辺に を掛けて を足し、式(13) と 式(15) を使うと 式(17) になる。
式(17) と、KL ダイバージェンスが 0 以上で、2つの密度がほとんど至るところで等しいときだけ 0 であること(KL ダイバージェンス)から、
が成り立つ。つまり は 式(13) の下界で、それに届く分布は だけである。Williams ほか(ICRA 2017)は、式(14) の期待値を についての期待値に書きかえ、イェンセンの不等式で 式(19) の不等号を示している。式(17) はさらに、両辺の差が であることまで示したものである。
名前の由来。 式(14) は、統計力学のヘルムホルツの自由エネルギー(エネルギー の状態の重みを とし、その和の対数に を掛けたもの。 はボルツマン定数、 は絶対温度)と同じ形で、コスト がエネルギーに、 が にあたる。 を「温度」と呼ぶのはこの対応による。Williams ほか(ICRA 2017)は を温度(temperature)、Williams ほか(T-RO 2018)は逆温度(inverse temperature)と呼んでいる。このページでは温度と呼ぶ。
正規分布に限ったときの目的関数
この節では、式(13) の を正規分布 に限ると何を最小にすることになるかを、式(9) で確かめる。式(13) に を入れ、式(9) を使うと
である。第1項は、計画 に乱数を足して動かしたときのコストの期待値、第2項は計画 を基準 から離したことへの2次のコスト(重みの行列は )である。つまり 式(13) は、「乱数を足して動かしたときのコストの期待値+基準からのずれの2次のコスト」を、正規分布に限らずすべての分布に広げたもので、その最小を与えるのが である。
は 式(16) で書けるが、一般に正規分布ではなく、 の 次元の空間での積分を含むので、平均を直接計算することはできない。次の節で、 に近い正規分布を選び、その平均をサンプルで推定する。
正規分布での近似
この節では、 に最も近い を、KL ダイバージェンスで測って選ぶ。Williams ほか(ICRA 2017)にならい、 の平均 を次で決める。
式(21) の解は、 の下での入力の平均である。
式(22) の期待値は有限である。( は下界の定数)とすると、式(16) から で、正規分布 の1次と2次のモーメントは有限だからである。式(22) は次のように示せる。式(6) から で、第1項は によらない。式(3) と 式(4) から なので、 について最小にするのは
である。式(23) の各項は と展開できる( が対称なので交差項は2つ等しい)。これを で微分して を掛けると 、2階の微分は正定値の なので、式(23) は について狭義の凸関数で、微分が 0 になる 式(22) が唯一の最小である。
KL ダイバージェンスの向き。 式(21) は を左に置いている。左右を逆にした を について最小にすることは、式(17) から 、つまり 式(20) を最小にすることと同じだが、その解は一般に閉じた形に書けず、 の関数 式(20)(一般に凸でない)を、例えば についての勾配で反復して小さくする必要がある。式(21) の向きなら、解は の平均という閉じた形 式(22) になり、次の節のとおり1回の期待値の推定で、サンプルの の値だけから求められる。代わりに、2つの向きの解は一般に一致しない。例えば 、、、、 で、 のとき 、それ以外で 0 とすると、式(20) を最小にする は 1.63、 の平均 式(22) は 1.46 で(数値積分で計算した)、一致しない。 では、どちらも で一致する。式(20) は (、)で、 で微分して 0 とおくと 、 である。 の平均が であることは、次の節の折りたたみで平方完成により示す。
重点サンプリング
この節では、式(22) の期待値を、今の計画 のまわりに作ったサンプルで推定する式を導く。これが MPPI の重みと更新の式である。
から直接サンプルを作ることはできないが、 からは作れる(正規分布の乱数を に足せばよい)。一般に、密度 についての期待値は、別の密度 (すべての点で正)についての期待値に、比 を掛けて書きかえられる。
から作ったサンプルで についての期待値を推定するこの方法を、重点サンプリングと呼び、 を提案分布と呼ぶ。比を
と置くと、式(16) から である。式(24) を 、、 に当てはめると
である。また 式(24) を 、、 に当てはめると、式(15) から なので、
となる。 は 次元の積分で計算できないが、式(27) では分子と分母に同じ形で入るので、両方を同じサンプルで推定すればよい。
から 個のサンプル を作り、式(27) の分子と分母の期待値を、それぞれサンプルの平均で置きかえると、推定値は
である( は分子と分母で約分した)。今の計画と基準の差を とし、
と置く。 を 式(25) と 式(8)( なので 、)で書いて、2つの の指数をまとめると、
である。式(30) の2つ目の は によらないので、式(28) の分子と分母で消える。さらに として分子と分母に を掛けても値は変わらない。こうしてできる重みを
と定義すると、、 で、式(28) の推定値は である。これを直した後の計画にする。
式(32) が MPPI の更新の式である。各サンプルについて必要なのは の値(モデル 式(1) で軌道を計算してコスト 式(2) を足すこと)と、乱数 だけで、・・ の微分は使わない。
を引く理由は、計算機の浮動小数点数で が 0 になることを避けるためである。倍精度の浮動小数点数では、 は 0 になる。例えば 、 なら、すべての で は 0 になり、 を引かないと 式(31) の分母が 0 になる(1回の更新の最初の時刻は、ほぼこの場合にあたる)。 を引くと、最も小さい の項が になるので、分母は 1 以上になる。
では、大数の法則により、式(27) の分子と分母のサンプルの平均はそれぞれの期待値に確率 1 で収束する(その期待値が有限であることを仮定する)。分母の極限 は正なので、比も期待値の比 式(27) に確率 1 で収束し、式(32) の右辺は 式(22) の に収束する。 が有限のとき、推定値は一般に と一致せず、その差は乱数によって変わる。
詳しくはこちら(基準の平均が 0 の1次元の例で式(32) を確かめる)
、、、基準の平均 、、 とする。式(16) は で、指数を平方完成すると なので、 は平均 、分散 の正規分布であり、式(22) は である。今の計画を ()として、 個の乱数(種 1)で 式(29)〜式(32) を計算すると 1.3313 になった(参考のプログラムの is_check)。
基準の分布の選び方
この節では、式(5) の基準の平均 の2つの選び方と、それぞれの重みと 式(20) の意味を示す。どちらも 式(32) の形は同じで、式(29) の だけが違う。
基準の平均を 0 にする()。 Williams ほか(ICRA 2017)の形である。 なので
で、式(20) の第2項は 、つまり入力の大きさへの2次のコストである。 は、式(31) で重みの偏り方を決めると同時に、入力のコストの重みも決める。この2つを 1つで決めることになる点は、Williams ほか(T-RO 2018)も問題として挙げている。
この場合、基準の分布と は今の計画 によらないので、同じ で 式(32) をくり返しても、目標の は変わらない。Williams ほか(ICRA 2017)は、くり返しは推定の精度を上げるためだけにあると述べている。くり返すと提案分布 の平均が に近づき、 が に近いほど比 のばらつきが小さく、推定の精度が上がるからである。
基準の平均を今の計画にする()。 なので
で、重みは だけで決まる。この場合は で、サンプルは基準の分布そのものから作っている。式(20) の第2項は で、直した後の計画を今の計画から離すことへのコストになる。 は、1回の更新でどれだけ計画を動かすかを決める。Williams ほか(T-RO 2018)は、基準の平均を とした。このとき なので、式(29) は 、 となり、論文はこの を入力のコストの係数として扱っている(論文の式は の代わりに を使うが、差の は によらず重みを変えない)。論文は と書き、両端の (前の選び方)と (この選び方)の場合も説明している。
この場合、更新するたびに基準の分布が直した後の計画に移るので、同じ でくり返すと 式(16) の も変わる。 でくり返しても計画が動かない点 (固定点)は、式(22) が に等しい点である。 なので 式(25) は で、式(27) に を入れると である。これが に等しいのは、分母が正なので
のときである。今の計画のまわりの乱数に で重みを付けて平均すると 0 になる、つまり重み付きの平均が今の計画を動かさない点である。
このページの数値例は、主に (式(34))で計算し、(式(33))の結果は基準の分布を変えたときで比べる。
アルゴリズム
この章では、前の章の式をモデル予測制御の手順にまとめ、各定数の効き方を式から示す。
手順
この節では、MPPI で毎時刻行う計算を番号付きで示す。前もって決めておくものは、モデル 、ステージコスト 、終端コスト 、ホライズン 、サンプル数 、温度 、共分散 、基準の平均の選び方(式(33) か 式(34) か)、計画の初期値(例えば全部 0)である。
各時刻 で次を行う。
- 状態 を測り、 とする。
- について、乱数 を平均 0・共分散 の正規分布から独立に作り、 で 式(1) を と計算して を求め、式(2) で を、式(33) か 式(34) で を計算する。
- とし、式(31) で を計算する。
- 式(32) で直した後の計画 を求め、 とする。
- を系に加える。
- 計画を1つずらす: について とし、 には初期値を入れる。
手順 2〜4 を同じ時刻に何回かくり返すこともできる。Nav2 の README は、くり返しの回数(iteration_count)の既定値を 1 とし、1 のままにしてサンプル数を増やすことを勧めている。このページの数値例も1回である。1時刻あたりの計算は、式(1) と をそれぞれ 回で、手順 2 の 本の計算は互いに独立なので並列にできる。 の方向は、 が を使うので順に計算する必要がある(GPU にこの点の見積もりがある)。
温度の極限
この節では、温度 を 0 に近づけたときと大きくしたときに、式(32) の更新が何になるかを式で示す。どちらも、サンプル( と )を固定したまま を動かす極限である。
。 式(34) の場合、 が最小になる がただ1つ( とする)なら、 では なので 、 では である。よって 式(31) は 、ほかは 0 に近づき、式(32) は
になる。コストが最小のサンプルをそのまま直した後の計画にする更新である。式(33) の場合も、 の第2項は によらないので、 で第1項の差が支配し、同じ 式(36) になる。
。 式(34) の場合、 なので、すべての で となり、式(32) は
になる。右辺の第2項は乱数の平均で、期待値は 0、共分散は なので、計画は平均としては動かない。式(20) で第2項(今の計画からのずれのコスト)が支配する場合にあたる。
式(33) の場合、 なので、重みは に比例するものに近づき、全部が等しくはならない。この極限の重みを使った推定で、さらに とすると、式(25) の を 1 に置きかえた 式(27)、つまり に収束し、式(24) から である。つまり、計画は 0(入力を加えない)に引き寄せられる。式(20) で、入力の大きさへのコストが支配する場合にあたる。
とコストの大きさ。 全部のコスト ・ を正の定数 倍し、同時に も 倍すると、式(33)・式(34) のどちらでも と は 倍になり、式(31) の は変わらないので、重みも更新も変わらない。式(34) では、 の値そのものではなく、 の広がりに対する の大きさが重みの偏り方を決める(式(33) では、さらに の広がりも重みの偏りに効く。基準の分布を変えたとき)。
有効サンプル数
この節では、重みがどれだけ少数のサンプルに偏っているかを1つの数で表す。重み 式(31) について、有効サンプル数を
と定義する。 で、 は1つのサンプルだけが重み 1 を持つとき、 は全部の重みが のときである。例えば、 個のサンプルだけが重み を持ち残りが 0 なら である。
詳しくはこちら(1 ≤ K_eff ≤ K の証明)
、 である。上の不等号は、コーシー–シュワルツの不等式 から で、等号は がすべて等しいとき。下の不等号は、 から なので で、等号は 、つまり1つだけが 1 のとき。
共分散・サンプル数・ホライズン
この節では、温度以外の3つの定数が、ここまでの式のどこに入るかを示す。数値での効き方は数値例の表に示す。
- 共分散 。 サンプル が今の計画からどれだけ離れるか(探す範囲)を決める。式(32) の更新は乱数 の重み付き平均なので、1回の更新で計画が動く量も の大きさで変わる。 のときは、式(20) の入力のコストの重みも で に依存する。
- サンプル数 。 式(27) の期待値を推定するサンプルの数で、 で推定値は に収束する(重点サンプリング)。計算量は に比例する。
- ホライズン 。 先を見る長さで、式(2) で足すステージコストの数と、乱数の次元 を決める。計算量は に比例する。障害物を表す項は、 ステップ先までに障害物に入る軌道のコストにしか入らないので、 が短いと、障害物の近くまで来てから避け始めることになる。
数値例
この章では、MPPI を実際に計算し、1回の更新・閉ループ・定数を変えたときの結果と計算時間を示す。数値はすべて参考のプログラムで計算した。
設定
この節では、例題の系・コスト・定数を決める。平面上の点ロボットを、3つの円形の障害物を避けて、原点から目標の位置まで動かす。
- 状態は位置 と速度 を並べた ()、入力 は加速度(、単位は m/s²)である。時間刻みを 秒とし、モデル 式(1) を次とする。
- 目標の位置を とする(長さの単位はメートル)。障害物は中心 ・半径 の円で()、、、 とする。位置 が障害物 の内側(、 はユークリッドの長さ)にあるとき 1、それ以外で 0 となる関数を とする。
- ステージコストと終端コストは次とする。 は3つの障害物についての最大で、どれか1つの内側なら 1 である。
式(40) の障害物の項は、有限ホライズンの最適制御で述べた指示関数の定数倍で、境界の上では微分できず、それ以外では微分が 0 である。
式(2) の和は までとってあるので、最後の時刻の状態 には 、つまり障害物の項と が入る(このページはこの定義で計算した)。また 式(39) では は で決まるので、位置 は入力 だけで決まり、最後の入力 は を通して の速度の項にだけ効く。モデル 式(39) は線形だが、式(40) が凸でないので、式(12) は凸な問題ではない。
- 定数:ホライズン (3 秒)、( は 2×2 の単位行列、 は乱数の各成分の標準偏差)で 、基準の平均は (式(34))、1時刻の更新は1回、計画の初期値と手順 6 で入れる値は 0 とする。 と は節ごとに書く。
- 閉ループ:(原点に止まっている)から、 の 80 回(8 秒)手順をくり返す。系はモデル 式(39) と同じとする(モデルの誤差は無い)。
- 評価:閉ループのコスト (軌道のコスト とは別の量で、実際に通った状態のステージコストの和)、入力の変化の大きさ (単位は (m/s²)²)、時刻ごとの (式(38))の 80 回の平均を使う。目標から 0.2 m 以内に入った時刻があれば「到達した」、障害物の内側に入った時刻があれば「衝突した」と数える。乱数の種を 0〜19 に変えた 20 回(以下、1回を1試行と呼ぶ)の平均で比べる。表の は小数第1位、 は有効数字3桁、 は小数第2位に四捨五入した。
- 図の色:重みの大きいサンプルは緑で描く。温度の値ごとに、 は桃、 は紫、 は水色、 は黒、 は薄い灰色を、全部の図で使う。サンプル数の違いは、灰色の濃さと点の形で描く。
1回の更新
この節では、サンプルの軌道と重みが実際にどうなるかを、1時刻分の更新で示す。
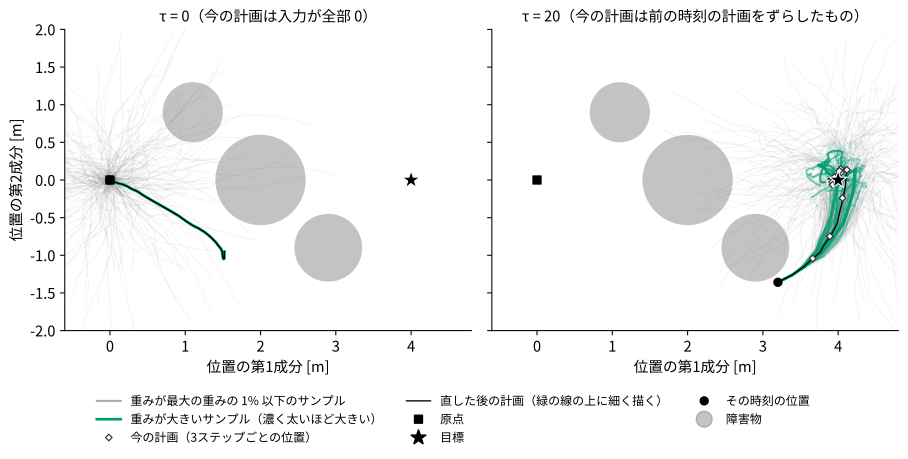
図1 、 での1回の更新。黒い四角が原点、星が目標、灰色の円が障害物、黒い丸がその時刻の位置 (状態 の位置の成分)である。細い線が 個のサンプルの軌道(位置)で、重みが最大の重みの 1% を超えるものを緑で描き、重みが大きいほど濃く太くした(1% 以下のものは薄い灰色)。白抜きのひし形が今の計画 の軌道の位置(3ステップごと)、黒い細い線が 式(32) で直した後の計画 の軌道で、緑の線の上に重ねて描いた。表示範囲の外へ出たサンプルの線は途中で切れている(左で 77 本、右で 53 本)。左は (計画は全部 0 なので、今の計画の軌道は原点から動かない1点で、ひし形は原点の四角に隠れる)、右は種 0 の閉ループの (位置 )である。右の閉ループは、この図と同じ で計算したもので、 の図3 とは別の試行である。左では緑の線が1本だけで、直した後の計画はその1本と重なっている。右では緑の線が 35 本あり、直した後の計画はそれらの間を通り、今の計画(ひし形)とほぼ同じ所を通る。
左()の は 384.1〜12306.6(中央値 699.0)に広がっており、 に比べて差が大きいので、最小の1本の重みが 0.99999997 になった()。256 個のうち 29 個は障害物の内側を通り、障害物の項 1000 が入ったので重みはほぼ 0 である。右()では目標に近く、 の最小は 12.6 で、重みの最大は 0.110、 だった。同じ でも、 の広がりが時刻によって違うので、重みの偏り方も変わる(温度の極限の最後の段落)。
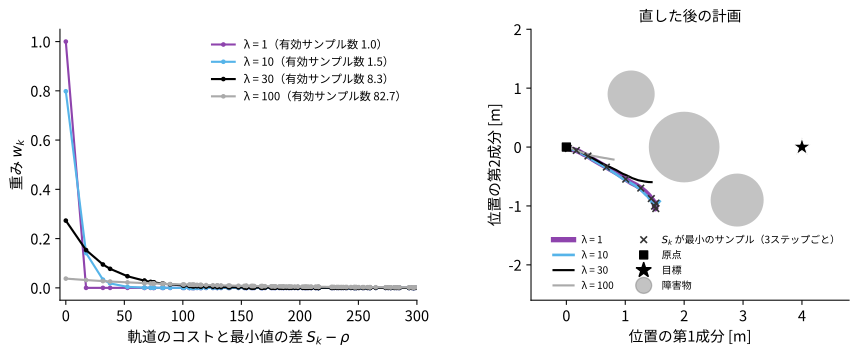
図2 図1 の左と同じ 256 個のサンプル()で、 を変えたときの重みと直した後の計画。色は色の節の決まりのとおり( 紫、 水色、 黒、 薄い灰色)。左は横軸を 、縦軸を重み (式(31))として、 の小さい順に点を結んだもので、凡例の括弧の中が である。横軸は 300 までを表示した。 のサンプルの重みは、 でも最大 0.0019 で、ほかの ではさらに小さい。 が小さいほど、左端の1点( が最小のサンプル)に重みが集まる。右は、それぞれの で 式(32) により直した後の計画の軌道で、× 印が が最小のサンプルの軌道(3ステップごと)である。 の太い紫の線は、 の線と × 印の下にほぼ重なっている。
では重みがほぼ最小の1本に集まり()、直した後の計画は が最小のサンプル(× 印)と重なった(直した後の計画のコストは 384.06 で、最小のサンプルの 384.06 と同じ)。 を 10、30、100 と大きくすると、 は 1.5、8.3、82.7 と増え、直した後の計画のコストは 385.9、417.0、512.1 になった。今の計画(入力が全部 0)のコストは 640.0 で、どの でも1回の更新でコストは下がった。 の計画の終点は で、ほかの より原点(今の計画の位置)に近い。 が大きいほど重みが多くのサンプルに分かれ、更新が乱数の平均(式(37))に近づいて、計画が動く量が小さくなる。
閉ループ
この節では、手順を 80 回くり返したときの状態と入力の時間変化を、 を変えて比べる。
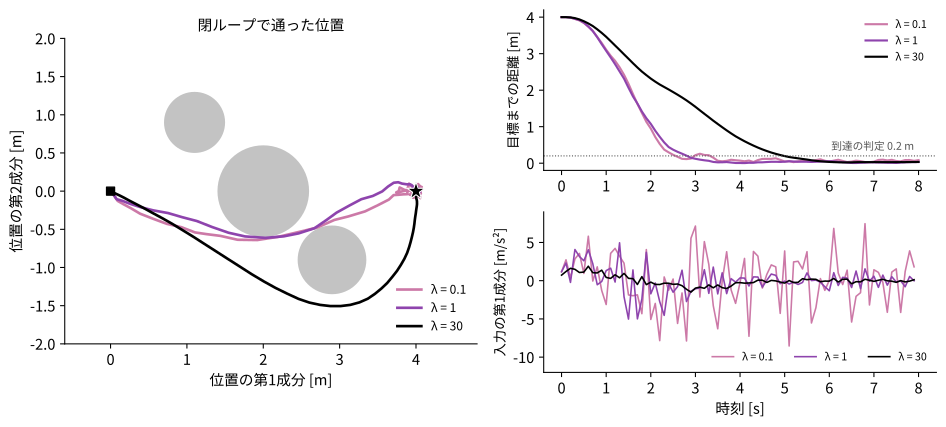
図3 、種 0 の閉ループを、(桃)、(紫)、(黒)で比べたもの。左は通った位置 (黒い四角が出発点、星が目標、灰色の円が障害物)、右上は目標までの距離 の時間変化(灰色の点線が到達の判定に使う 0.2 m)、右下は系に加えた入力 の第1成分(m/s²)の時間変化である。左を見ると、 と は大きい障害物と右下の障害物の間を通り、 は右下の障害物の下を回っている。右下を見ると、 が小さいほど入力が細かく大きく振れている。
数値は次の表のとおりである(列は左から、、閉ループのコスト 、入力の変化の大きさ 、到達した時刻、入力 の第1成分の範囲、 の平均)。どの でも衝突は無かった。
| 温度 | 閉ループのコスト | 入力の変化の大きさ | 到達した時刻 | 入力の第1成分の範囲 | 有効サンプル数の平均 |
|---|---|---|---|---|---|
| 0.1 | 192.2 | 53.5 | 2.6 秒 | −8.54〜7.45 | 2.27 |
| 1 | 189.2 | 9.32 | 2.9 秒 | −5.02〜4.95 | 42.08 |
| 30 | 282.0 | 0.266 | 5.0 秒 | −1.50〜1.89 | 607.37 |
と の はほぼ同じだが、 は が約 5.7 倍である。 では の平均が 2.27 で、毎時刻ほぼ1個のサンプルをそのまま計画にしているので(式(36) に近い)、そのサンプルの乱数がそのまま入力に出る。 は入力が小さくなめらかだが、到達が 5.0 秒と遅く、 が大きい。 の平均は 607.4( のうち)で、式(37) の極限()ではないが、重みが多くのサンプルに分かれて更新が乱数の平均に近くなり、1回の更新で計画が動く量が小さくなっている。
サンプル数と温度を変えたとき
この節では、 と を変えたときの と を、20 試行の平均で示す。
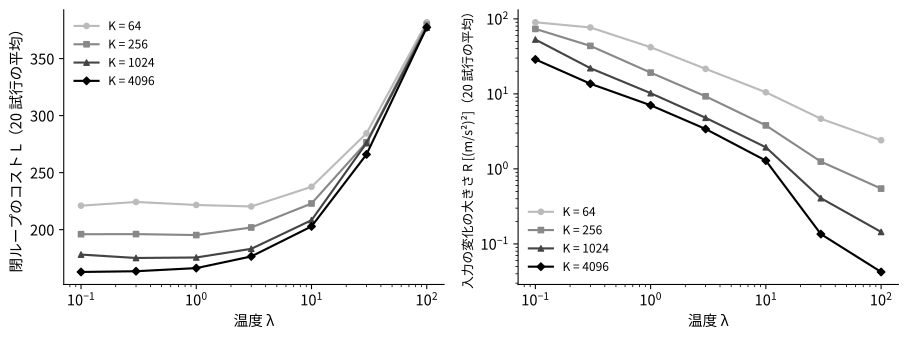
図4 (薄い灰色・丸)、(灰色・四角)、(濃い灰色・三角)、(黒・ひし形)で、 を 0.1・0.3・1・3・10・30・100 と変えたときの、閉ループのコスト の平均(左)と、入力の変化の大きさ の平均(右、縦軸は対数)。左を見ると、 は の範囲ではほぼ平らで、 をそれより大きくすると増える。 を増やすと、平らな部分が下がる。右を見ると、 は を大きくするほど、また を増やすほど小さくなる。
表は、 での値である(列は左から、、、、 の平均、到達した試行の数)。20 試行のどれも、時刻の点が障害物の内側に入らなかった(時刻と時刻の間の線分は判定していない)。・ のほかの組の値は、参考のプログラムの出力 sweep にある。
| 温度 | 閉ループのコスト | 入力の変化の大きさ | 有効サンプル数の平均 | 到達した試行の数 |
|---|---|---|---|---|
| 0.1 | 178.1 | 53.0 | 2.21 | 20 |
| 0.3 | 175.2 | 22.0 | 8.27 | 20 |
| 1 | 175.6 | 10.2 | 43.65 | 20 |
| 3 | 183.2 | 4.79 | 144.12 | 20 |
| 10 | 208.3 | 1.94 | 376.39 | 20 |
| 30 | 275.9 | 0.407 | 611.64 | 20 |
| 100 | 377.2 | 0.144 | 795.34 | 19 |
この例では、 を 0.1 から 1 まで大きくしても はほとんど増えず、 は 5 分の1以下になった。 をさらに大きくすると、 は小さくなるが が増える。
共分散とホライズンを変えたとき
この節では、、 に固定して、 と を変えた結果を示す(ほかの設定は設定のとおり、20 試行の平均)。
を変えた結果は次の表のとおりである(列は左から、、、、 の平均、到達した試行の数)。
| 標準偏差 | 閉ループのコスト | 入力の変化の大きさ | 有効サンプル数の平均 | 到達した試行の数 |
|---|---|---|---|---|
| 0.25 | 282.5 | 0.755 | 422.39 | 20 |
| 0.5 | 228.3 | 2.82 | 168.88 | 20 |
| 1 | 175.6 | 10.2 | 43.65 | 20 |
| 2 | 149.8 | 84.7 | 6.83 | 20 |
を大きくすると、 は下がり、 は大きくなり、 は小さくなった。 の広がりは、この表の条件では測っていない。
を変えた結果は次の表のとおりである(列は左から、、、、 の平均、衝突した試行の数)。
| ホライズン | 閉ループのコスト | 入力の変化の大きさ | 有効サンプル数の平均 | 衝突した試行の数 |
|---|---|---|---|---|
| 5 | 2760.2 | 0.941 | 767.77 | 13 |
| 10 | 154.7 | 2.26 | 645.67 | 0 |
| 20 | 168.9 | 4.91 | 175.83 | 0 |
| 30 | 175.6 | 10.2 | 43.65 | 0 |
| 50 | 203.8 | 50.6 | 4.06 | 0 |
(0.5 秒)では 20 試行のうち 13 試行で障害物の内側に入り、 は障害物の項のために大きくなった。 以上では時刻の点が障害物の内側に入った試行は無く、 は で最も小さかった(154.7)。 を長くすると が小さくなり、 が大きくなった。 が小さくなる理由はホライズンと重みの偏りで調べる。 で が最も小さくなった理由は調べていない。
基準の分布を変えたとき
この節では、基準の平均を 0 にした 式(33) で、 として同じ例を計算し、式(34) と比べる(列は左から、、、、 の平均、最後の時刻の目標までの距離の平均、到達した試行の数)。
| 温度 | 閉ループのコスト | 入力の変化の大きさ | 有効サンプル数の平均 | 最後の距離 | 到達した試行の数 |
|---|---|---|---|---|---|
| 0.1 | 183.5 | 12.3 | 1.27 | 0.15 m | 20 |
| 1 | 210.7 | 5.68 | 1.81 | 0.24 m | 20 |
| 10 | 292.4 | 2.33 | 129.40 | 0.27 m | 19 |
| 100 | 660.1 | 0.00745 | 597.17 | 1.63 m | 0 |
式(33) では、 で 20 試行のどれも目標に到達しなかった。温度の極限で示したとおり、 が大きいと計画は 0 に引き寄せられる(式(20) の入力のコスト が大きい)からである。
の の平均は、式(34) では 43.7 だったが、式(33) では 1.81 だった。違いは 式(33) の第2項 にある。式(31) の指数 では、この項は で割られて になり、 によらない。重みには が掛かるので、 が 1 違うと重みは 倍違う。種 0 の閉ループ()の各時刻で、サンプルの間の の標準偏差を測ると、80 時刻の中央値は 8.1 だった。同じ各時刻のサンプルで、重みを だけで計算した場合の の中央値は 33.96 だったが、 を足した重みでは 1.54 で、重みが少数のサンプルに集まった。この例では、式(33) で が十分大きくなる では入力のコストが大きくなりすぎ、温度と入力のコストを1つの で決めることの問題(基準の分布の選び方)が数値に出ている。
計算時間
この節では、このページのプログラム(numpy、CPU だけ)で、1回の更新(手順の 2〜4)にかかる時間を示す。、 の状態で 50 回測った中央値は、 で 6.7 ミリ秒、 で 18.3 ミリ秒だった(CPU は 11th Gen Intel(R) Core(TM) i9-11900K @ 3.50GHz、1スレッドで測ったかどうかは制御していない)。制御周期は ミリ秒なので、 の更新は1周期に収まる。この例はモデル 式(39) が小さいので、モデルの計算が重い場合(ニューラルネットワークなど)は、この時間は当てはまらない。
ほかの方法との比較
この章では、MPPI と、同じ問題 式(12) をモデル予測制御で解くほかの方法を、定義した後で比べる。
ランダムシューティング
この節では、サンプルを作って最もコストの小さいものを選ぶ方法を定義する。このページでは、MPPI と同じく今の計画のまわりに 個のサンプル を作り、 が最小のものを直した後の計画にする方法をランダムシューティングと呼ぶ。この名前は、このページの中での呼び方として決めるもので、今の計画によらない固定した分布からサンプルを作る方法とは区別する。これは 式(36)、つまり 式(34) の MPPI で とした極限と同じ更新である。
交差エントロピー法
この節では、交差エントロピー法(Cross-Entropy Method、CEM)をモデル予測制御に使う形を定義する。 個のサンプルのうち が小さい順に 個(エリートと呼ぶ。)を選び、エリートには重み 、ほかには 0 を付けて 式(32) で計画を直す。元の CEM はエリートから共分散も推定し直すが、Williams ほか(T-RO 2018)のモデル予測制御版は、共分散を推定し直すと急に小さくなり、時刻とともに変わる状況に対応できなくなるという理由で、共分散を固定した。このページもそれにならい、共分散を固定し、(四捨五入。 で 26 個、 で 102 個)とする。
MPPI との違いは重みの付け方だけである。MPPI の重み 式(31) は の値の差に応じて連続的に変わるが、CEM の重みはエリートの中で に差があっても等しい。
iLQR と DDP
この節では、勾配を使う方法との違いで述べた iLQR と DDP の、比較に使う性質をまとめる。どちらも、今の計画のまわりで の1階の微分(DDP は2階も)と ・ の1階・2階の微分を計算し、時刻 から へ向かう再帰(各時刻の計算が1つ後の時刻の結果を使う)で計画の修正量とフィードバックの係数を求め、軌道を計算し直すことをくり返す。微分を使うので、式(40) の障害物の項のように、境界の上では微分できず、それ以外では微分が 0 の項は、修正量に入らない。
性質の比較
この節では、ここまでの4つの方法を、式から言える性質で比べる。
| 方法 | 直した後の計画の決め方 | モデルとコストの微分 | 境界の外では微分が 0 の不連続な項 | 1回の更新で並列にできる計算と、逐次になる計算 |
|---|---|---|---|---|
| MPPI | 全サンプルの重み付き平均。重みは 式(31) | 使わない | コストの値の差として重みに入る | サンプルごとの軌道の計算は並列。各サンプルの中の時刻の方向は逐次(式(1)) |
| ランダムシューティング | コスト最小の1つ(式(36)) | 使わない | どのサンプルが最小になるかに入る | サンプルごとの軌道の計算は並列。各サンプルの中の時刻の方向は逐次 |
| 交差エントロピー法 | コストが小さい上位の個数の、等しい重みの平均 | 使わない | 上位に入るかどうかに入る | サンプルごとの軌道の計算は並列。各サンプルの中の時刻の方向は逐次 |
| iLQR・DDP | 線形化・2次近似した問題の解 | 使う(DDP はモデルの2階も) | 修正量に入らない | 時刻の方向は逐次(後ろ向きの再帰と、軌道の計算し直し) |
数値例での比較
この節では、数値例と同じ設定で、ランダムシューティング・交差エントロピー法・MPPI(式(34)、 と )を比べる。iLQR・DDP は、式(40) の障害物の項の微分が境界の外では 0(境界の上では微分できない)で、障害物を避ける修正量が出ないので、比べていない。列は左から、方法、、、、 の平均で、どれも 20 試行の平均である。20 試行のすべてで、どの方法も到達し、衝突しなかった。
| 方法 | サンプル数 | 閉ループのコスト | 入力の変化の大きさ | 有効サンプル数の平均 |
|---|---|---|---|---|
| ランダムシューティング | 256 | 196.8 | 94.8 | 1.00 |
| 交差エントロピー法(上位 10%) | 256 | 281.2 | 3.65 | 26.00 |
| MPPI(温度 1) | 256 | 195.3 | 19.2 | 11.00 |
| MPPI(温度 3) | 256 | 201.9 | 9.26 | 35.01 |
| ランダムシューティング | 1024 | 179.2 | 85.8 | 1.00 |
| 交差エントロピー法(上位 10%) | 1024 | 277.6 | 0.965 | 102.00 |
| MPPI(温度 1) | 1024 | 175.6 | 10.2 | 43.65 |
| MPPI(温度 3) | 1024 | 183.2 | 4.79 | 144.12 |
この例では、ランダムシューティングは MPPI()とほぼ同じ で、 が大きかった。交差エントロピー法は が小さく、 が大きかった。 の交差エントロピー法の は、図4 の MPPI の ( 275.9、 0.407、 の平均 611.64)に近いが、 は 102(式(38) で の場合)で、MPPI の より小さい。 が同じ程度の MPPI(、 の平均 144.12)は 183.2 で、交差エントロピー法より小さい。この違いの理由は調べていない。これは1つの例題での結果で、どの方法が一般に良いかを示すものではない。
限界と改良
この章では、MPPI の限界を、ここまでの式と数値例で示し、それに対する改良のうち出典を確かめたものを挙げる。
ホライズンと重みの偏り
式(34) では、重みは だけで決まる(温度の極限の最後の段落)。ホライズン を長くすると、式(2) で足すステージコストの数が増え、サンプルの間の の差も大きくなりうる。(計画は全部 0)、、種 0 のサンプルで、コストが最小のものと小さい方から 10 番目・100 番目のものとの差を測ると、次の表のとおりだった(列は左から、、最小のコスト、10 番目との差、100 番目との差、 での )。
| ホライズン | 最小のコスト | 10 番目との差 | 100 番目との差 | 有効サンプル数 |
|---|---|---|---|---|
| 5 | 225.4 | 1.8 | 8.0 | 10.75 |
| 10 | 265.3 | 12.2 | 31.8 | 1.13 |
| 20 | 315.5 | 32.0 | 85.8 | 1.01 |
| 30 | 355.7 | 54.3 | 157.8 | 1.00 |
| 50 | 424.1 | 112.0 | 322.4 | 1.00 |
を長くすると、小さい側のコストの差が大きくなり、同じ では重みが少数のサンプルに集まった。閉ループでの の平均が とともに小さくなったこと(共分散とホライズンを変えたとき)も、この測定と同じ向きである。同じ を保つには、 をコストの差に合わせて大きくするか、 を増やす必要がある。 を大きくすると、式(37) に近づき計画が動きにくくなる。
今の計画のまわりしか探さない
サンプルは を平均とする正規分布から作るので、探すのは今の計画のまわりである。サンプルがすべてコストの大きい領域(例えば全部が障害物の内側)に入ると、式(31) の重みは「コストの大きいものの中で比べて小さいもの」を重くするだけになる。Mohamed ほか(log-MPPI、2022)は、概要によれば、この状況で実行できない軌道が出ることを問題とし、正規分布の代わりに正規分布と対数正規分布を組み合わせた分布からサンプルを作ることで、制約を満たす軌道が得られやすくなったと報告している。
平均をとることによる問題
式(22) は の平均を計画にする。 に離れた2つの山があるとき(例えば障害物の左を回る入力列と右を回る入力列がどちらもコストが小さいとき)、平均は2つの山の間になり、それ自体のコストは大きい場合がある。例えば が と ( はある入力列)に同じ重みで集中していれば、平均は である。Williams ほか(ICRA 2017)は、 が多峰的なとき平均を合わせるだけでは不十分かもしれないと述べ、障害物の多い場面の実験ではそれが問題にならなかったとしている。Lambert ほか(Stein Variational MPC、2020)と Okada・Taniguchi(Variational Inference MPC、2019)は、入力列の分布を複数の山を持てる形で表す方法を提案した。
入力のなめらかさ
式(32) の更新は、時刻ごとに独立な乱数の重み付き平均なので、 が小さいと入力が時刻ごとに大きく変わる(閉ループで の が大きかった)。Williams ほか(T-RO 2018)は、出力した入力列に、各時刻のまわりで多項式を当てはめてなめらかにする方法を述べている。Kim ほか(Smooth MPPI、2022)は、概要によれば、入力を持ち上げる(input-lifting)方法と、入力列をなめらかにする新しい入力のコストを組み合わせ、外からなめらかにする処理なしになめらかな入力を出す方法を提案した。Pinneri ほか(iCEM、2020)は、交差エントロピー法で時間方向に相関した乱数を使い、必要なサンプル数を減らした。
制約
入力の上下限は、Williams ほか(T-RO 2018)のように、モデルの中で入力を範囲内に切り詰める関数を通せば扱える。式(1) の が切り詰めを含んでも、導出は が の関数であることしか使わないので、そのまま成り立つ。状態の制約(障害物など)は、このページの例のようにコストの項として入れるので、満たすことは保証されない。数値例では で 20 試行中 13 試行が障害物に入った。
モデルの誤差
MPPI はモデル 式(1) の上で最適化するので、モデルと実際の系が違えば、計画は実際の系で最適ではない。このページの数値例は、系とモデルを同じにしたので、モデルの誤差の影響は調べていない。Williams ほか(ICRA 2017)は、学習したニューラルネットワークをモデルにして、台車倒立振子とクアッドロータのシミュレーションで、真のモデルを使った場合との性能の差が 10% 以内だったと報告し、その理由として、モデル予測制御は短いホライズンしか使わず毎時刻計画を計算し直すことを挙げている。
確かめ問題
この章では、基準の分布の選び方・温度の極限・有効サンプル数の内容を、手で計算して確かめる問題を2つ出す。解答は各問題の直後の折りたたみにある。
問題1。 基準の平均を今の計画にした 式(34) の MPPI で、、、、( は定数)とする。 のとき、式(32) の1回の更新で、計画と の差 が何倍になるかを求めよ。また、同じ で更新をくり返すと計画がどこへ近づくか、その速さが でどう変わるかを答えよ。
解答(問題1)
では 式(32) は 式(22) の に収束する(重点サンプリング)。基準の分布は なので、式(16) は
である。指数を展開すると なので、 の係数は 、 の係数は で、、 である。 と平方完成すると、 は平均 の正規分布なので、
である。ここで は での直した後の計画 の極限である。両辺から を引くと、分子は なので、
となり、差は 倍になる。この係数は 0 より大きく 1 より小さいので、くり返すと差は等比数列で 0 に近づき、計画は を最小にする に近づく。 が大きいほど係数は 1 に近く、近づき方は遅い(式(37) と同じ向き)。 では係数は 0 で、1回で に届く。
問題2。 式(34) の MPPI で、 個のサンプルのコストが 、、 だった。 のときの重み と を、小数第4位まで( は第3位まで)四捨五入して求めよ。また、 と でそれぞれ がいくつに近づくかを答えよ。
確認できていない点
- 4周目の批判的レビュー(2026-10-23)で残った指摘:期待値の記号 の添字(どの分布についての期待値か)の書き方が節によって違う。アルゴリズムの手順で、最初の計画の決め方と、毎時刻の終わりに入れる値の名前が分かれていない。
- 数値例の衝突の判定は時刻の点だけで行い、時刻と時刻の間の線分が障害物を横切るかは調べていない。
- 数値例の結果は、このページで決めた1つの例題(線形のモデル、3つの障害物、、、、1時刻1回の更新)と 20 試行だけで測った。設定を変えたときの結果や、方法の一般的な優劣は調べていない。 を変えたときの の広がり、 で が最も小さくなった理由、交差エントロピー法と MPPI の違いの理由は調べていない。
- 重点サンプリングの推定 式(32) の、有限の での誤差の大きさ( を増やすとどの速さで小さくなるか)は示していない。
- 計算時間は、1台の CPU で、モデルが小さいこの例題だけで測った。
- 使われている例の論文のうち、ICRA 2017 と T-RO 2018(arXiv:1707.02342 の版)は本文を読んで式と実験の条件を確かめたが、ICRA 2016 は Crossref の書誌情報と概要だけを確かめた。改良として挙げた論文(log-MPPI、Stein Variational MPC、Variational Inference MPC、Smooth MPPI、iCEM)は題名・著者・概要だけを確かめ、手法の詳細は読んでいない。
- Nav2 の
nav2_mppi_controllerの対応する移動ロボット・速さ・既定値は、GitHub の README の記載で、動かして確かめてはいない。
参考
- Williams, Drews, Goldfain, Rehg, Theodorou「Aggressive Driving with Model Predictive Path Integral Control」(ICRA 2016): https://doi.org/10.1109/ICRA.2016.7487277
- Williams, Wagener, Goldfain, Drews, Rehg, Boots, Theodorou「Information Theoretic MPC for Model-Based Reinforcement Learning」(ICRA 2017): https://homes.cs.washington.edu/~bboots/files/InformationTheoreticMPC.pdf
- Williams, Drews, Goldfain, Rehg, Theodorou「Information-Theoretic Model Predictive Control: Theory and Applications to Autonomous Driving」(IEEE Transactions on Robotics 34(6), 2018): https://arxiv.org/abs/1707.02342
- Williams, Aldrich, Theodorou「Model Predictive Path Integral Control: From Theory to Parallel Computation」(Journal of Guidance, Control, and Dynamics、2017): https://doi.org/10.2514/1.G001921 、arXiv 版「Model Predictive Path Integral Control using Covariance Variable Importance Sampling」: https://arxiv.org/abs/1509.01149
- Williams, Goldfain, Drews, Saigol, Rehg, Theodorou「Robust Sampling Based Model Predictive Control with Sparse Objective Information」(RSS 2018):概要によれば、勾配の情報が疎で不連続なコストを持つ非線形の系のための確率的モデル予測制御で、サンプリングによる最適化と線形化による最適化を組み合わせ、チューブ型モデル予測制御を使う: https://doi.org/10.15607/RSS.2018.XIV.042
- Kappen「Path integrals and symmetry breaking for optimal control theory」(2005):経路積分による最適制御: https://arxiv.org/abs/physics/0505066
- Theodorou, Todorov「Relative entropy and free energy dualities: Connections to Path Integral and KL control」(CDC 2012):自由エネルギーと相対エントロピーの関係: https://doi.org/10.1109/CDC.2012.6426381
- Li, Todorov「Iterative Linear Quadratic Regulator Design for Nonlinear Biological Movement Systems」(ICINCO 2004):iLQR: https://doi.org/10.5220/0001143902220229
- Tassa, Erez, Todorov「Synthesis and stabilization of complex behaviors through online trajectory optimization」(IROS 2012):iLQG をモデル予測制御に使った例: https://doi.org/10.1109/IROS.2012.6386025
- Chua, Calandra, McAllister, Levine「Deep Reinforcement Learning in a Handful of Trials using Probabilistic Dynamics Models」(2018、PETS):交差エントロピー法をモデル予測制御に使う強化学習: https://arxiv.org/abs/1805.12114
- Pinneri ほか「Sample-efficient Cross-Entropy Method for Real-time Planning」(2020、iCEM): https://arxiv.org/abs/2008.06389
- Mohamed, Yin, Liu「Autonomous Navigation of AGVs in Unknown Cluttered Environments: log-MPPI Control Strategy」(2022): https://arxiv.org/abs/2203.16599
- Kim, Park, Kwak, Bae, Lee「Smooth Model Predictive Path Integral Control without Smoothing」(2022): https://arxiv.org/abs/2112.09988
- Lambert, Fishman, Fox, Boots, Ramos「Stein Variational Model Predictive Control」(2020): https://arxiv.org/abs/2011.07641
- Okada, Taniguchi「Variational Inference MPC for Bayesian Model-based Reinforcement Learning」(2019): https://arxiv.org/abs/1907.04202
- Nav2
nav2_mppi_controllerの README: https://github.com/ros-navigation/navigation2/tree/main/nav2_mppi_controller - 図と数値を作ったプログラム:wiki のデータリポジトリの
MPPI/figures.py。乱数の種を固定してあり、python3 figures.py <図の保存先>で、図を保存し、本文の数値を JSON で出す(CPU の numpy で約 8 分)。図の保存には hamko-admin のagents/skills/math-tex-explainer/svgfig.pyを使う。