オセロの評価値・単純な規則の打ち手どうしの総当たり・Edax の評価関数の形は オセロ のページにある。
概要
このページは、オセロの AI を作った実験を材料にして、強化学習を勉強するための資料である。強化学習は、行動の結果として得た得点を手がかりに、得点が高くなる行動のしかたを学ぶ機械学習である。このページでは、「なるべく負ける」オセロ AI と「勝つ」オセロ AI を、方策勾配法(打った手の確率を、その対局の結果が平均より良ければ上げ、悪ければ下げる方法)・AlphaGo・AlphaZero の方式で学習させ、既製のプログラム Edax の作り(評価関数と αβ 探索)と比べ、同じ作りの「負けたがる AI」の点数表を自己対戦から当てはめ、強さを 1 つの数(レーティング)で測り、計算をどう分ければ速くなるかを調べた。数値は、手元と Colab で動かした記録、出典を示した外部の値(論文・公開されているベンチマーク・連盟のレーティングの一覧・機器の公称値)、それらからの計算のどれかで、本文に出どころを書く。第2章の方策勾配法の学習プログラムの全文は GPU のページ にある。そのほかのプログラム(AlphaGo・AlphaZero の学習、評価、負けたがる AI、並列の測定)は手元の othello-lose/ にあり、本文ではファイル名で指す。
読む順路
上から順に読む。記号と用語は前の章で定義したものを使う。実験の結果は、後の章で扱うものを先に使う所がある(第3章が第5章のレーティングの値を、第2章が第6章の速さの比較の実行を使うなど)。そうした所は「第5章の…」のように章を書いて指す。各章の終わりに確かめ問題を置き、解答は折りたたみに入れた。
| 章 | 扱うこと | 読むと分かるようになること |
|---|---|---|
| 第1章 問題と方法の選び方 | 何を学習させるか、学習の方法の選択肢、記号 | 問題(相手・目的)の決め方と、方法を選ぶ観点(何を学習し、1 手にどれだけ計算するか) |
| 第2章 方策勾配法 | 方策・目的・勾配の式、ベースライン、実装する損失、学習中に見る量、学習の前後の打ち方(実行の条件の一部は第6章の速さの比較で示す) | 得点の期待値の勾配が、対局して記録した量の平均で書ける理由。損失の値が進み具合を表さない理由 |
| 第3章 価値と先読み | Q 学習、AlphaZero の損失、モンテカルロ木探索、AlphaGo と AlphaZero の学習と結果 | 局面の見込み(価値)を学ぶ方法と、先読みの結果を学習の目標にする方法の違い。先読みの回数で強さがどう変わるか |
| 第4章 探索と評価関数 | オセロのドメイン知識、Edax の評価関数と αβ 探索、このページの打ち手との対比、このページの対局での Edax の条件、第3章の先読みの回数と Edax の深さの違い、Edax にならった作りで、点数表を自己対戦から当てはめた「負けたがる AI」 | 点数表で局面に点を付け、深さを決めた探索で打つ作りの仕組みと、点数表を自己対戦から当てはめる方法(ネットワークの方式との強さの比較は第5章) |
| 第5章 強さの測り方(レーティング) | Bradley–Terry モデル、当てはめとブートストラップ、人間の値の換算、段位の意味、結論とほかの AI との比較、αβ 探索と AlphaZero の方式の比較、Egaroucid の評価関数、負ける強さのレーティング | 対局の勝ち負けから強さを 1 つの数にする方法と、その数の確かさ。オセロで αβ 探索と点数表の作りが強い理由と、AlphaZero の方式が弱いとは言えない理由 |
| 第6章 計算資源と並列学習 | 計算量、1 台の GPU での速さ、並列に計算できる条件(データ並列と BatchNorm の統計、通信と計算の比、Amdahl の法則、データを集める部分と学習する部分の分担、古いパラメータで集めたデータ、モデル並列、そのまま並列にできる仕事と並列にしにくい仕事、並列の数と速くなる倍率)、Colab の費用、途中からの再開 | どういう性質があれば計算を複数の GPU や CPU のプロセスに分けられるか、分けたときにどこまで速くなるか |
| 確認できていない点 | 確かめていない事項 | どこまでが確かめた事実か |
本文では、記録や計算で確かめた事実と、推測(「推測」と書く)と、確かめていないこと(「確かめていない」「未確認」と書く)を分けて書く。
第1章 問題と方法の選び方
この章では、AI に何を学ばせるか(問題)と、学ばせる方法の選択肢を決め、以降の章で共通に使う記号を定義する。読む順は、問題の設定、ゲームの機械学習の方法、記号 である。
問題の設定
この節では、AI が何を目指し、誰と対局するかを決める。
- 相手:合法手(その局面で打てる手)の中から等確率で1つ選んで打つ。この相手を以下「ランダムな相手」と呼ぶ。
- AI の色:対局ごとに、黒(先手)か白(後手)かを等確率で決める。
- 目的:終局時に、AI の石の数が相手の石の数より少ないこと(AI の負け)。
- パス:打てる手が無い側はパスし、両者が続けてパスしたら終局とする。
ゲームの機械学習の方法
この節では、ゲームを打つ AI を学習させる方法の選択肢を挙げ、このページで使う方法を決める。どの方法も、局面ごとの打ち方を決める数(パラメータ)を持ち、対局をくり返して集めた結果からその数を決める(Edax の点数表だけは決め方が公開されていない。第4章の負けたがる AI(なるべく負けることを目指して、Edax にならって作った AI)は、点数表を自己対戦の結果に当てはめる)。違いは、何を学習するかと、どうやって手を選ぶかにある。
| 方法 | 学習するもの | 手の選び方 |
|---|---|---|
| 方策勾配法 | 局面ごとに、各合法手を選ぶ確率 | 学習した確率に従って選ぶ |
| 見込みに基づく方法(Q 学習など) | 局面と手の組ごとに、その手を打った後に得られる得点の見込み | 見込みが最大の手を選ぶ |
| 探索と組み合わせる方法(AlphaZero の方式) | 手を選ぶ確率と、局面の得点の見込みの両方 | 学習した確率と見込みを使って先を読み、その結果で選ぶ |
| 点数表と αβ 探索(Edax の方式) | 盤の決まったマスの組(形)ごとの点数表の値 | 点数表で局面に点を付け、何手か先まで読み、点が最大の手を選ぶ。αβ 探索は結果を変えない枝を省き、Edax の一部の設定では、浅く読んだ値から結果が変わらないと見込める枝も打ち切る(ProbCut。第4章の αβ 探索) |
このページは、最初に第2章で方策勾配法を使う。理由は2つある。1手を選ぶ計算がネットワーク1回で済み、ネットワークで先読みをする方法(第3章のとおり、このページの設定では1手に33回)より計算が軽い。また、学習するのが確率だけなので、必要な式が記号から更新までの節で閉じる(Q 学習も1手の計算は1回で済むが、見込みの目標を作る式が別に要る)。ほかの方法の式と比較は、方策勾配法の式を定義した後の第3章(Q 学習と AlphaZero の方式)と第4章(点数表と αβ 探索)に置く。第3章では AlphaGo と AlphaZero の方式も学習させ、第4章では点数表と αβ 探索で打つ AI も作る。
記号
この節では、以降の節で共通に使う記号をまとめて定義する。1つの節や例の中だけで使う記号は、その場で定義する。
| 記号 | 意味 |
|---|---|
| 局面。AI から見た向きの盤面で、64 マスそれぞれが「AI の石」「相手の石」「空き」のどれか | |
| 局面 で手番側が打てるマス(合法手)の集合。マスは 0〜63 の番号で表す | |
| ネットワーク(式(2) で定義する関数)のパラメータ(重みとバイアスをすべて並べたもの)。学習で直す対象 | |
| 自然対数と、その逆の指数関数 | |
| で決まる実数 を、 の各成分で偏微分(ほかの成分を定数とみなして微分)した値を並べたベクトル(勾配)。偏微分は で書く | |
| 局面 をネットワークに入れる形に直した 192 個の 0 か 1(式(1)) | |
| 局面 を入れたときにネットワーク(式(2))が出す 64 個の実数。マス の値を と書く | |
| 局面 で AI がマス に打つ確率(方策)。青で書く | |
| 1局分の記録(AI の色、両者が打った手、パスの全部) | |
| 対局 が起きる確率と、そのうち によらない部分(AI の色と相手の手の確率の積)(式(6)・式(7)) | |
| 1局の中で AI が石を打った回数。パスは数えない | |
| AI が 回目()に石を打った局面と、打ったマス | |
| 対局 の得点。橙で書く | |
| 得点の期待値。学習で大きくしたい量 | |
| 1回の更新に使う対局の数。全対局を GPU で同時に進めるので「同時に進める対局数」でもある | |
| 対局の番号()。対局 の記録を 、AI が打った回数を と書く | |
| 対局 で AI が 回目に石を打った局面と、打ったマス | |
| ベースライン(得点から引く値)。緑で書く | |
| 学習率(1回の更新でパラメータを動かす幅を決める正の数) |
第1章の確かめ問題
問1-1 ゲームの機械学習の方法 の表の 4 つの方法について、(a) 学習するもの、(b) 学習したものから 1 手を選ぶのに要る計算を答えよ。また、方策勾配法を選んだ 1 つ目の理由(1 手を選ぶ計算がネットワーク 1 回で済み、先読みをする方法より計算が軽い)が、(b) のどの違いから来るかを答えよ。
解答(問1-1)
| 方法 | 学習するもの | 1 手を選ぶのに要る計算 |
|---|---|---|
| 方策勾配法 | 局面ごとの各合法手の確率 | その局面の確率を 1 回計算し、それに従って選ぶ |
| 見込みに基づく方法(Q 学習など) | 局面と手の組ごとの得点の見込み | その局面の各合法手の見込みを計算し、最大の手を選ぶ(ネットワークが全部の手の見込みを一度に出すなら 1 回) |
| 探索と組み合わせる方法(AlphaZero の方式) | 手の確率と局面の見込みの両方 | 学習した確率と見込みを使って先の局面を読み、その結果で選ぶ。先の局面ごとに確率と見込みを計算する |
| 点数表と αβ 探索(Edax の方式) | 形ごとの点数表 | 何手か先まで全部の手を読み、読んだ先の局面ごとに点数表で点を付ける |
1 つ目の理由は、方策勾配法では 1 手に要る計算が「いまの局面で 1 回」で、先の局面を読まないことから来る。探索と組み合わせる方法は、1 手ごとに先の局面をいくつもネットワークで評価するので、1 手あたりの計算が増える(何回になるかは第3章の 先読みの回数 で示す)。点数表と αβ 探索も先の局面をいくつも評価するが、1 局面の評価は点数表を引いて足すだけで、ネットワーク 1 回より軽い。そのため、1 手あたりの計算が方策勾配法より多いか少ないかは、読む深さによって違い、一概には言えない(第4章の Edax の深さとの違い)。1 つ目の理由が区別するのは、方策勾配法と、ネットワークで先読みをする方法である。Q 学習も、ネットワークが全部の手の見込みを一度に出すなら 1 手の計算は 1 回なので、1 つ目の理由では Q 学習と区別できず、方策勾配法を選んだのは 2 つ目の理由(式が閉じる)による。
第2章 方策勾配法
この章では、方策勾配法で「なるべく負ける」AI を学習させるときに、何をどの式で計算しているかを示し、学習の記録と学習の前後の打ち方で結果を確かめる。読む順は、局面から確率を作る 方策、大きくしたい量の 目的、その勾配の 方策勾配、ばらつきを減らす ベースライン、実際に計算する 対局の集まりからの推定、1手の確率の勾配、更新、学習の手順、学習中に見る量、方策勾配法の学習の結果 である。
方策
この節では、局面からマスごとの確率 を作る計算を定義する。
ネットワークへの入力は、局面 を 192 個の 0 か 1 に直したもの である。マス について、AI の石なら 1、相手の石なら 1、合法手なら 1 になる 3 つの値を、64 マス分並べる。 は中の条件が成り立てば 1、成り立たなければ 0 を表す。
ネットワークは3層の全結合である(全結合の層を重ねたこの形のネットワークを MLP(多層パーセプトロン)と呼ぶ)。 は 、 は 、 は の行列、 は長さ 256・256・64 のベクトルで、 はこれら全部である。 をベクトルの成分ごとに当てる。行列をかけて足し、ReLU を当てることを2回くり返し、最後にもう一度行列をかけて足す。
パラメータの数は、3つの行列の成分の数と3つのベクトルの長さの和である。
確率は、合法手のマスだけで の指数をとり、合計が 1 になるよう割って作る(ソフトマックス)。合法手でないマスの確率は 0 とする。
式(4) の分母は合法手全部の和なので、 のとき で、合法手の確率の和は 1 になる。
目的
この節では、学習で大きくしたい量 を定義する。
得点は、AI が負ければ 1、引き分けなら 0、勝てば −1 とする。
対局 が起きる確率を と書く。対局は、AI の色・AI の手・相手の手で決まり、打った手から次の局面は一意に決まる。AI の色と相手の手の確率は によらない。相手が石を打った回数を 、相手が 回目()に石を打った局面を とする。AI の色はどちらも確率 、相手の 回目の手は確率 ( はその局面の合法手の数)なので、その積を次のように定義する。
すると は、式(6) の と AI の手の確率 式(4) の積になる。
目的は得点の期待値で、起こりうる対局すべての和で書ける(1手ごとに盤上の石が1個増えて空きマスは 60 個なので石を打つのは高々 60 回、パスは2回続くと終局するので1局の長さは有限で、各手番の選択肢も有限なので、対局の種類も有限)。
は「負けた割合 − 勝った割合」に等しい。式(5) の得点は負けで 1、勝ちで −1、引き分けで 0 なので、式(8) の和は、負ける対局の確率の和から勝つ対局の確率の和を引いたものになるからである。
方策勾配
この節では、 を大きくする向き(勾配 )が、対局をして得た量の平均で書けることを示す。
式(8) を で微分し、式(7) を使うと、次の式になる(証明は下の折りたたみ)。 は、対局 が確率 で起きるときの平均を表す。
式(9) の平均の中身(得点と、打った手の確率の対数の勾配)は、 によらない部分 (AI の色と相手の手の確率)を含まない。平均は、実際に対局して記録をとれば求められる。相手がどう打つかを知らなくても、対局をして得点と自分の手を記録すれば勾配を求められる。 は、 をその向きに少し動かすと、打った手 の確率が上がる向きである。式(9) は、負けた対局(得点 1)では打った手の確率を上げ、勝った対局(得点 −1)では下げる向きを、全対局で平均したものになっている。
詳しくはこちら(式(9) の証明)
証明では、式(7) で が によらないこと、式(4) で合法手の確率が正であること、対局の種類が有限であることを使う。 は 式(2) の ReLU のため、ReLU に入る値がちょうど 0 になる では微分できない。以下の微分は、そうでない で成り立つ(PyTorch は 0 での ReLU の微分を 0 として計算する)。
式(4) より合法手の確率は正なので、式(7) で の対局は になる。起こりうる対局の集合は によらない。この集合の上で、式(8) の和と微分を入れかえる(有限和なので入れかえてよい)。
なので、対数の微分(合成関数の微分)から次の式が成り立つ。
式(11) を 式(10) に入れると、和は平均の形になる。
式(7) の対数をとると、積が和になる。
ベースライン
この節では、得点から定数 を引いても 式(9) の平均が変わらないことと、引くと推定のばらつきが減る例を示す。
式(9) の を、対局によらない定数 を引いた に置きかえても、平均は同じになる(証明は下の折りたたみ)。
以下では を「有利さ」と呼ぶ。
平均が同じでも、1局から計算する値のばらつきは で変わる。次の例で、引かないと値がばらつき、得点の期待値を引くとばらつきが減ることを示す(この例では 0 になる)。
例。手を1回だけ選ぶ問題を考える。合法手は2つで、ここでは手 A・手 B と呼ぶ(後の数値例のマス A・B・C とは別のもの)。A を選ぶと必ず負け(得点 1)、B を選ぶと必ず引き分け(得点 0)になるとする。出力は1つの実数 で、A の確率を 、B の確率を とする(式(4) で A の出力を 、B の出力を 0 としたもの)。いまは で、両方の確率が 0.5 とする。
の定義を合成関数の微分で微分すると、次のようになる。
式(16) を使うと、選んだ手の確率の対数の微分は次のとおり。
では なので、式(17) は A なら 0.5、B なら −0.5 である。1局から計算する値「有利さ × この微分」は次のとおり。
| 選んだ手 | 確率 | 得点 | 引かない場合(ベースライン 0) | ベースライン 0.5 の場合 |
|---|---|---|---|---|
| A | 0.5 | 1 | 1 × 0.5 = 0.5 | 0.5 × 0.5 = 0.25 |
| B | 0.5 | 0 | 0 × (−0.5) = 0 | (−0.5) × (−0.5) = 0.25 |
この例の得点の期待値は 式(8) と同じ考え方で次の になり、その微分は で 0.25 である。
表のどちらの列も、確率 0.5 ずつで平均すると 0.25 で、式(18) に等しい。ベースラインの 0.5 は、この例の得点の期待値 である。分散(平均からのずれの2乗の平均)は次のとおり。
この例で引かない場合は、B を選んだ対局から何も学ばず、A を選んだ対局だけで確率を動かすので、1局ごとの値がばらつく。
実装では、 を、同じ更新に使う 局の得点の平均にした( は和をとるための対局の番号)。
対局の集まりからの推定
この節では、式(14) の平均を 局の対局で置きかえた、実際に計算する量を示す。
式(14) の期待値を 局の平均に置きかえ、 に 式(20) を使ったものを、勾配の推定値 と定義する。
式(20) の は対局 自身の得点を含むので、式(14) の「対局によらない定数」という条件を満たさない。それでも、 なら の平均( 局すべての打ち方についての平均。以下、添字の無い はこの意味)は を正の数 倍したもので、向きは変わらない(証明は下の折りたたみ)。
なら (小数第6位を四捨五入)である。
詳しくはこちら(式(22) の証明)
局 は、同じ で互いに独立に打たれる。対局 の打った手の確率を上げる向きを と書く。式(20) の和から の項を分けると、有利さは次のように書ける。
式(23) に をかけて平均をとる。
の項は、 と が独立なので に分かれる。式(15) で とした式から なので、この項は 0。残る第1項は、式(9) より 。どの でも同じ値なので、式(21) で について平均しても で、式(22) になる。
実装では、次の量 を PyTorch の自動微分で微分し、その勾配の逆向きに進めている。 は、式(21) の和を ではなく AI の手の総数 で割り、符号を反転したものである。 と は微分しない定数として扱う。
式(25) を微分する。微分は和の各項に分けられ、各項の ・ と は によらないので係数として の外に出せる。式(21) の を使うと次のようになる。
式(26) の係数 は対局の集まりごとに変わる正の数なので、1回ごとの更新で と の向きは同じである。ただし、この係数は得点と無関係ではない(手数の多い対局と少ない対局で得点の傾向が違えば、係数と が相関する)ので、式(22) の「平均が の正の数倍」という性質は、 の平均についてはそのままは言えない。この差を実験で確かめてはいない。
1手の確率の勾配
この節では、式(21) の中の が、ネットワークの出力 についてどんな形になるかを示し、数値例で確率の動き方を確かめる。
式(4) の対数を で偏微分すると、次の式になる(証明は下の折りたたみ)。 は なら 1、それ以外は 0。
式(27) から、有利さが正の対局では、打ったマス の出力 を に比例して上げ、ほかの合法手の出力を、それぞれの確率に比例して下げる向きになる。有利さが負なら逆になる。 についての勾配は、式(27) に、式(2) の各層を順にさかのぼって微分をかけていく連鎖律(誤差逆伝播)で計算する。実装では PyTorch が自動でこの計算をする。
詳しくはこちら(式(27) の証明)
式(4) の対数をとる。 のとき、
式(28) の第1項を で偏微分すると 。第2項は、 なら合成関数の微分で で、式(4) よりこれは に等しい。 なら第2項の和に が入らないので 0 で、第1項も より なので 0。
数値例。合法手が3つ(マス A・B・C)で、出力が 、AI が B に打ったとする。式(4) から確率を、式(27) から B を打ったときの偏微分を計算すると、次の表になる(小数第5位を四捨五入)。
| マス | 出力 | 確率 | 偏微分 |
|---|---|---|---|
| A | 1.0 | 0.6652 | −0.6652 |
| B(打った手) | 0.0 | 0.2447 | 0.7553 |
| C | −1.0 | 0.0900 | −0.0900 |
説明のため、出力そのものをパラメータとみなし、ベースラインを仮に 0.2 と置いて、出力に「1 × 有利さ × 偏微分」を足して更新した後の確率を比べる。
| 対局の結果 | 有利さ(得点 − 0.2) | 更新後の出力(A, B, C) | 更新後の B の確率 |
|---|---|---|---|
| 負けた(得点 1) | 0.8 | (0.4678, 0.6042, −1.0720) | 0.4855 |
| 勝った(得点 −1) | −1.2 | (1.7983, −0.9063, −0.8920) | 0.0590 |
(小数第5位を四捨五入)
負けた対局では B の確率が 0.2447 から 0.4855 に上がり、勝った対局では 0.0590 に下がる。
更新
この節では、式(25) の勾配を使ってパラメータを直す方法を示す。
最も単純な更新は、 の勾配の逆向きに、学習率 をかけた分だけ進めることである( は右辺の値で置きかえることを表す)。
実装では 式(29) の代わりに Adam を使い、学習率は にした。Adam は勾配の移動平均を使って、パラメータの成分ごとに進む幅を調整する。
詳しくはこちら(Adam の式)
回目の更新での勾配を とする。成分ごとに次を計算する(2乗・割り算・平方根も成分ごと)。PyTorch の既定値 、、 を使い、 から始める。
は勾配の移動平均、 は勾配の2乗の移動平均である。式(31) の と は、0 から始めたことで最初の数回の が小さく出るのを補正する。
学習の手順
この節では、実装が計算している 式(1)・式(4)・式(5)・式(20)・式(25)・式(30)・式(31) を、どの順に計算しているかを示す。1回の更新は次の4段階で、決めた秒数(15秒)が過ぎるまでくり返す。
- 対局: 局を GPU で同時に最後まで進める。AI の手は 式(4) の確率で乱数を使って選び、相手の手はランダムに選ぶ。AI が打った局面の入力 (式(1))、合法手、打ったマス を記録する。
- 得点:終局した盤面から 式(5) の得点 を、式(20) でベースライン を求める。
- 勾配:記録した全局面をまとめてネットワークに入れ、式(25) の を計算して、PyTorch の自動微分で を求める。
- 更新:Adam(式(30)・式(31))でパラメータを直す。
学習後の評価では、乱数を使わず、各局面で確率 が最大のマスに打たせる。
学習中に見る量
この節では、学習で最小化している損失が何で、学習が進んでいるかを何で判断するかを示す。最小化しているのは 式(25) の損失 だが、その値の符号や大きさからは、負けた割合も方策の偏りも決まらない。 は、式(26) のとおり勾配の向きを作るための量で、値が何で決まるかは 損失の値の意味 で式から示す。進み具合は、負けた割合などの別の量で判断する。
記録する量
この節では、更新のたびに記録する4つの量を定義する。
1つ目は、ランダムな相手に負けた割合である。学習中の対局(AI が確率に従って乱数で手を選ぶ)の値と、評価の対局の値の2つを記録する。評価の対局は、学習とは別に、確率が最大の手だけを打たせてランダムな相手と 4,096 局打たせたもの。学習後に使う打ち方(確率が最大の手)の強さはこちらで見る。4,096 局で数えるので、負けた割合が 94% 前後なら、乱数によるばらつき(標準誤差 )は約 0.4 ポイントある。
2つ目は、損失 (式(25))の値である。
3つ目は、方策のエントロピーである。局面 での方策のエントロピー を次のように定義する。対数は自然対数なので、単位をナットと呼ぶ。
式(32) は、合法手を等確率で選ぶときに最大値 をとる。下限は 0 で、1つの手の確率を 1 に近づけると 0 に近づく(証明は下の折りたたみ)。記録するのは、学習中の対局で AI が石を打った全局面についての の平均と、比べるための の平均である。
詳しくはこちら(式(32) の最大値と下限)
を と書き、合法手の確率を (式(4) よりどれも正で、和は 1)と書く。 は上に凸な関数なので、確率 の重みで平均をとると、平均の のほうが の平均より大きいか等しい(イェンセンの不等式)。
式(33) の等号は がすべて等しいとき、つまり のときに成り立つ。下限は、 より各項 なので 。1つの手の確率を 1 に近づけると、その項は に、ほかの項は ()に近づくので、 は 0 に近づく。
4つ目は、勾配の大きさ である。 の全成分の2乗の和の平方根(ユークリッドノルム)で、Adam に渡す前の値を記録する。
損失の値の意味
この節では、式(25) の の値が、得点と「その対局の手の確率の対数の和」の共分散で決まることを示し、その値が何によって変わるかを示す。
対局 で AI が打った手の確率の対数の和を 、その平均を 、AI の手の数の平均を と書く。
式(25) を 式(34) の記号で書き直すと、次のようになる(証明は下の折りたたみ)。
式(35) の は、手の選ばれやすさだけでなく、AI が打った手の数と、各局面の合法手の数にもよる。合法手を等確率で選ぶ方策なら なので、 になる。各項 は 0 以下なので、手の数が多い対局ほど小さく(負に大きく)なりやすい。
そのため、方策がまったく偏っていなくても は 0 にならない。下の表の相関係数は、 局の2つの量 について次で定義する( は平均)。
ネットワークの出力をすべて 0 にした方策(式(4) から合法手を等確率で選ぶ)で 局を2回打たせると、次のとおりだった。
| 回 | 損失の値 | AI が負けた対局の平均の手数 | AI が勝った対局の平均の手数 | 得点と手数の相関係数 | 得点と手の確率の対数の和の相関係数 |
|---|---|---|---|---|---|
| 1 | −0.0189 | 29.75 | 30.21 | −0.323 | 0.142 |
| 2 | −0.0198 | 29.73 | 30.22 | −0.298 | 0.145 |
負けた対局のほうが AI の手数が少なく、得点と の相関係数は正(0.142・0.145)だった。式(35) から、共分散が正なら は負になる。 の符号や大きさから、方策がどちらへ偏っているかは読めない。
学習が進んだときの の変化は、式(35) の共分散を 式(38) で標準偏差と相関係数に分けると読める。 と書くと、式(38) より共分散は に等しいので、
( は の並び、 は の並び)。得点の標準偏差は、負けた割合を 、勝った割合を とすると、得点が なので 、平均が で、 になる。記録した各因子は次のとおり(小数第4位を四捨五入)。
| 方策の更新の回数 | 損失の値 | 得点の標準偏差 | 手の確率の対数の和の標準偏差 | 2つの相関係数 | AI の手の数の平均 |
|---|---|---|---|---|---|
| 0 | −0.0153 | 0.982 | 4.227 | 0.110 | 29.963 |
| 72 | −0.0005 | 0.296 | 3.962 | 0.012 | 29.543 |
が縮んだのは、得点の標準偏差が約3分の1になったこと(負けがほぼ毎回になったため)と、相関係数が約9分の1になったことによる。手の確率の対数の和の標準偏差と手の数の平均はほとんど変わっていない。相関係数が小さくなった理由は確かめていない。得点の標準偏差は負けた割合が 1 に近づくと 0 に近づくので、この記録では は学習の進みと同じ向きに縮んだ。ただし学習前でも は 0 でないので(等確率の方策の表)、値から負けた割合は決まらない。
を 式(25) から計算した値と 式(35) から計算した値の差は、記録した全 73 回で 以下だった。
記録した値
この節では、手元の RTX 3070 Ti で のまま 73 回更新し、4つの量を毎回記録した結果を示す。73 回は、第6章の 速さの比較 で示す「15 秒たったら止める」学習が、この GPU と で行った更新の回数である。この記録のための実行は、更新ごとに評価の対局も打つので乱数の使われ方が変わり、第6章の図3 の実行とは同じ回数でも値が一致しない。学習にかかった時間は測っていない。
図と表の横軸「方策の更新の回数」は、その値を出した方策が何回更新されたかを表す。学習中の対局の負けた割合・損失・エントロピー・勾配の大きさは、その回数だけ更新した方策で打った対局から計算し、その後に次の更新をした。評価の対局は、その回数目の更新の直後に打った。第6章の 学習の進み方 の表の「更新の回数 10」は、この数え方では 9 にあたる(10 回目の更新に使った対局は 9 回更新した方策で打った)。
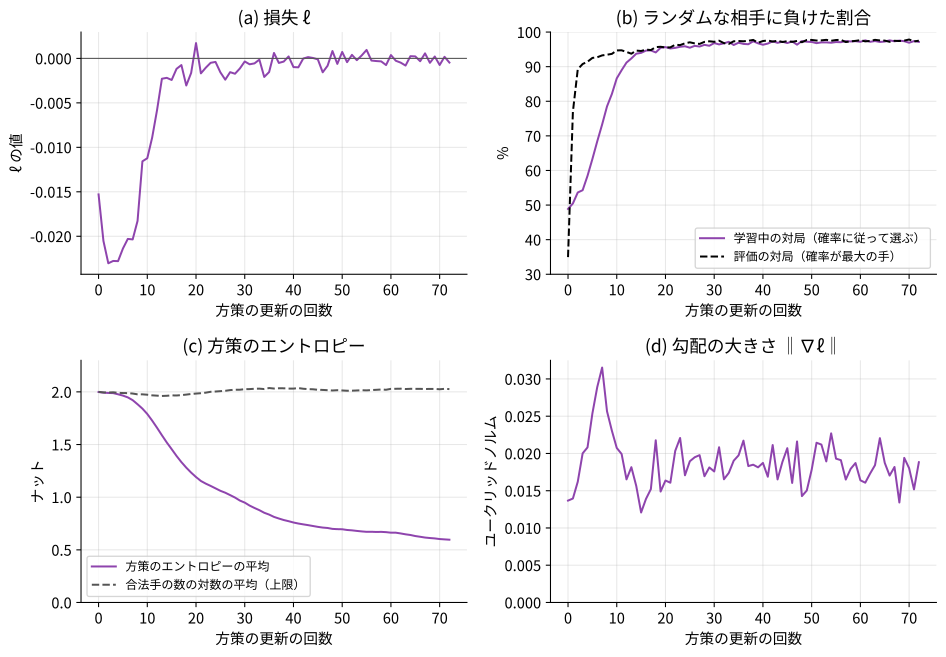
図1 学習中に記録した量。横軸はどれも方策の更新の回数。(a) 損失 の値。2 回更新した方策で最小になった後 0 に近づき、19 回以降は −0.0024〜0.0017 の範囲にある(54 点のうち負が 38 点、正が 16 点)。(b) ランダムな相手に負けた割合。紫の実線は学習中の対局、黒の破線は評価の対局。黒の破線は 2 回の更新で 89% まで上がり、紫の実線は 20 回前後でそれに追いつく。(c) 紫の実線は方策のエントロピー の平均、灰色の破線はその上限 の平均。紫の線が上限から離れていくのは、方策が特定の手に偏っていくことを表す。(d) 勾配の大きさ。0.012〜0.032 の間にあり、0 に落ちていない。
主な値を表にする。負けた割合は小数第2位、そのほかは小数第5位を四捨五入した。
| 方策の更新の回数 | 学習中の対局で負けた割合 | 評価の対局で負けた割合 | 損失の値 | エントロピーの平均 | 上限(合法手の数の対数の平均) | 勾配の大きさ |
|---|---|---|---|---|---|---|
| 0(学習前) | 48.9% | 35.0% | −0.0153 | 1.9987 | 2.0004 | 0.0137 |
| 1 | 50.5% | 77.0% | −0.0205 | 1.9928 | 1.9950 | 0.0139 |
| 2 | 53.6% | 89.3% | −0.0230 | 1.9899 | 1.9939 | 0.0162 |
| 8 | 78.5% | 93.5% | −0.0183 | 1.8826 | 1.9767 | 0.0257 |
| 24 | 95.9% | 96.8% | −0.0004 | 1.0840 | 2.0035 | 0.0171 |
| 72 | 97.2% | 97.5% | −0.0005 | 0.5963 | 2.0266 | 0.0188 |
表から読めることは次のとおり。
- 負けた割合:1 回更新した方策は、評価の対局では 77.0% 負けたが、学習中の対局では 50.5% だった。このときエントロピーの平均 1.9928 は上限 1.9950 とほぼ同じで、確率はまだほぼ等確率だった。推測では、評価では確率が最大の手だけを打つので、確率の差がわずかでも順位が入れかわれば結果が変わる。学習中の対局は確率に従って選ぶので、確率が少し偏っただけでは結果が変わりにくい(実際、48.9%・50.5%・53.6% と少しずつ上がっている)。
- エントロピー:1.9987 から 0.5963 に下がった。エントロピーの平均を指数に直すと (四捨五入)で、上限の平均を指数に直すと である(合法手の数の平均は 8.88)。上限はほぼ変わらないので、合法手の数が減ったのではなく、方策が特定の手に偏った。
- 損失:最小は 2 回更新した方策の −0.0230 で、19 回以降は −0.0024〜0.0017 の範囲(絶対値の平均 0.0007)にある。損失の値の意味 のとおり、縮んだのは主に得点の標準偏差と相関係数が小さくなったためである。
- 勾配の大きさ:0.0121〜0.0315 の範囲で、最大は 7 回更新した方策だった。
まとめると、この学習で進み具合の判断に使う量と、見ることは次のとおり。
| 量 | 見ること |
|---|---|
| 評価の対局で負けた割合 | 目的(負けること)がどれだけ達成できているか。約 0.4 ポイントのばらつきより大きく上がっていれば学習が進んでいる |
| 学習中の対局で負けた割合 | 評価の値に追いついたか。追いつけば、確率に従って選んでも同じ結果になるほど方策が偏った |
| エントロピーの平均 | 上限から離れていくか、0 に張りつかないか。0 に近いと、確率が最大でない手はほとんど打たれない。式(21) の推定値は実際に打った手の項だけの和なので、打たれない手の確率を直す材料が入らなくなる |
| 勾配の大きさ | 0 に落ちていないか。全対局が同じ結果なら 式(20) で有利さがすべて 0 になり、式(26) の勾配も 0 になって、学習の材料が無くなる。Adam は 式(31) で勾配をその大きさの移動平均で割るので、大きさの数値そのものは1回に進む幅を決めない |
| 損失の値 | 最小化している量だが、式(39) のとおり負けた割合以外の因子でも変わるので、値では進み具合を判断しない |
方策勾配法の学習の結果
この節では、学習の前後で AI の打ち方がどう変わったかを示す。
次の表は、学習の前後で、乱数を使わない AI(学習の手順の評価のしかた)を各相手と 8,192 局打たせた結果である。「返す数が最多の相手」は、返せる石が最も多い手を打つ相手(同じ数の手が複数あれば乱数で選ぶ)。値は GPU のページの A100 の実行(、15 秒で止めた学習。第6章の 速さの比較)のもの。
| 相手 | 学習前に負けた割合 | 学習後に負けた割合 | 学習後に勝った割合 |
|---|---|---|---|
| ランダムな相手 | 34.9% | 98.4% | 1.0% |
| 返す数が最多の相手 | 50.5% | 99.2% | 0.6% |
学習後の AI は、終局時の自分の石を減らす打ち方を覚えた。手元の RTX 3070 Ti で ・15秒学習させた実行(第6章の図3 の灰色の破線と同じ実行)で、ランダムな相手との 8,192 局の終局時の石の数を平均すると、次のようになった(小数第2位を四捨五入)。
| 時点 | AI の石の数 | 相手の石の数 |
|---|---|---|
| 学習前 | 34.7 | 29.3 |
| 学習後 | 18.5 | 45.5 |
第2章の確かめ問題
問2-1 ベースライン の例(手 A を選ぶと必ず負けて得点 1、手 B を選ぶと必ず引き分けで得点 0、A の確率は )で、 のときを考える。1 局から計算する値「有利さ × 選んだ手の確率の対数の微分」の平均と分散を、ベースラインが 0 のときと、得点の期待値 0.8 のときについて求めよ。次に、分散を最小にする定数のベースラインを求めよ。
解答(問2-1)
式(17) より、選んだ手の確率の対数の微分は、A なら 、B なら である。ベースラインを とすると、1 局から計算する値は A なら 、B なら である。
| ベースライン | A を選んだときの値(確率 0.8) | B を選んだときの値(確率 0.2) | 平均 | 分散 |
|---|---|---|---|---|
| 0 | 0.2 | 0 | 0.16 | 0.0064 |
| 0.8 | 0.04 | 0.64 | 0.16 | 0.0576 |
| 0.2 | 0.16 | 0.16 | 0.16 | 0 |
平均はどれも で、式(16) の に等しい(式(14) のとおりベースラインで平均は変わらない)。分散は、例えばベースライン 0 では である。得点の期待値 0.8 を引くと、分散は 0.0064 から 0.0576 に増える。ベースライン の例()では期待値を引くと分散が 0 になったが、期待値を引けばいつも分散が減るわけではない。
分散を最小にするベースラインは次のように求める。選んだ手の確率の対数の微分を と書くと、1 局の値は で、平均は によらないので、分散を最小にするには 2 乗の平均 を最小にすればよい。これは の 2 次式で、 で微分して 0 とおくと 、つまり
である。表の 3 行目のとおり、この例ではベースライン 0.2 で分散が 0 になる。式(20) の得点の平均は、計算が簡単なので実装で使ったベースラインで、分散を最小にする値とは限らない。
問2-2 局の得点が だった(3 局負けて 1 局勝った)。式(20) のベースラインと各局の有利さを求めよ。また、式(22) で の平均は の何倍か。最後に、4 局とも負けた(得点がすべて 1)ときの を求めよ。
解答(問2-2)
式(20) より 。有利さ は、負けた 3 局で 、勝った 1 局で である。式(22) の係数は なので、 の平均は の 0.75 倍で、向きは同じである。
4 局とも負けると で、有利さはすべて になる。式(21) の和の各項に 0 がかかるので である。記録した値 の最後の表の「勾配の大きさ」の行が述べるとおり、全対局が同じ結果だと学習の材料が無くなる。
第3章 価値と先読み
この章では、手の確率だけを学ぶ第2章の方法を、局面や手の得点の見込み(価値)を学ぶ方法と、先読み(探索)を組み合わせる方法へ広げる。読む順は、ほかの方法との比較(Q 学習と AlphaZero の損失の式)、AlphaGo と AlphaZero(先読みの手順、2 つの方式の学習、このページの実装と学習の結果)である。
ほかの方法との比較
この節では、ゲームの機械学習の方法で挙げた Q 学習と AlphaZero の方式を式で定義し、方策勾配法と比べる。Q 学習はこのページの実験では使っていない。AlphaZero の方式は、この後の AlphaGo と AlphaZero で学習させる。
Q 学習
この節では、Q 学習の学習対象と更新の目標を式で定義する。
Q 学習は、局面 でマス に打ち、その後は見込みが最大の手を打ち続けたときの得点の期待値を、見込み として学習する( はこの節で使う別のネットワークのパラメータ)。 には 式(2) と同じ形のネットワークの出力 を使ってよい。手は見込みが最大の合法手 を選ぶ(学習中は乱数で別の手も試す)。
ここでは、問題の設定と同じく相手が決まった確率で打つ(ランダムな相手)とし、相手の手を盤面の変化の一部とみなす。AI が局面 で に打った後、相手の手(とパス)を挟んで、次に AI が石を打てる局面を とする。見込みの目標 を次のように定義する。
式(41) の2行目は、次の手番で最も良い手を打ったときの見込みを、いまの手の見込みの目標にすることを表す。 は、次の2乗誤差を小さくする向きに更新する( は微分しない定数として扱う)。
は相手の手と、その後の局面によって変わる乱数である。定数 との2乗誤差の平均は と分けられ( を2乗して平均すると、交差項の平均は で消える)、 で最小になるので、各 の見込みを互いに独立に選べると仮定し、 の中の を固定して考えると、式(42) を多くの対局で小さくすることで は相手の手について平均した に近づく。実際のネットワークは全局面でパラメータを共有し、更新すると も変わるので、この仮定は近似である。相手を盤面の変化の一部とみなせるのは、相手の打ち方の確率が学習中に変わらないからである。AI 自身と対局させる場合(自己対戦)は相手も学習で変わるので、式(41) はそのままでは使えない。
AlphaZero の方式
この節では、AlphaZero の方式の学習対象と損失を式で定義する。
AlphaZero の方式は、AI 自身どうしの対局(自己対戦)で棋譜を集める。この点で、ランダムな相手と対局する問題の設定とは違う。ネットワーク(パラメータ )が手の確率 と局面の得点の見込み の2つを出す。手を選ぶときは、 と を使って先の局面を探索し(モンテカルロ木探索)、各手を調べた回数の割合を とする。手は に従って選ぶ。この節の方式では、対局の結果を、記録した各局面 の手番側から見た値 (手番側が目指す結果になれば 1、引き分けなら 0、逆なら −1)で表す。この AI が負けを目指すなら、手番側が負けた局面で である。 はパラメータを小さく保つための正の数とする( は の成分の2乗の和)。 は、対局が終わった後、記録した各局面 について次の損失を小さくする向きに更新する。
式(43) の第1項は見込みを実際の得点に近づけ、第2項は を探索で決めた割合 に近づける。
比較
この節では、3つの方法を、学習する関数・更新の目標・手の選び方・1回の対局で必要な計算で比べる。
| 方法 | 学習する関数 | 更新の目標 | 手の選び方 | 1回の対局で必要な計算 |
|---|---|---|---|---|
| 方策勾配法 | 手の確率(式(4)) | 対局の得点と打った手(式(21)、実装は 式(25)) | 確率に従う | 各手番でネットワークを1回 |
| Q 学習 | 局面と手の得点の見込み | 次の局面の見込みの最大値(式(41)) | 見込みが最大の手 | 各手番でネットワークを1回 |
| AlphaZero の方式 | 手の確率 と局面の得点の見込み (式(43)) | 探索で決めた割合と対局の得点(式(43)) | 探索の結果 | 各手番で探索した局面の数だけネットワーク |
AlphaGo と AlphaZero
この節では、先読み(モンテカルロ木探索)を学習と対局に組み込んだ2つの方式、AlphaGo(2016年)と AlphaZero(2017年に arXiv で公開)を式で定義する。どちらも、ネットワークが出す手の確率と局面の見込みを使って先を読み、その結果で手を選ぶ。違いは学習の材料で、AlphaGo は人の棋譜から始め、AlphaZero は自己対戦だけで学ぶ。この節で「AlphaGo Lee」は 2016年にイ・セドル九段と対局した版、「AlphaGo Zero」は 2017年に発表された、自己対戦だけで学んだ囲碁専用の版(AlphaZero の前身)を指す。読む順は、両者に共通する先読みの手順、AlphaGo の学習、AlphaZero の学習、このページの実装である。
このページの実装は、次のライブラリを使う。JAX は Python の数値計算のライブラリ(GPU で動き、自動で微分する)、haiku は JAX でネットワークを書くライブラリ、mctx は JAX で木探索をするライブラリ、Pgx は JAX で書かれたゲーム環境のライブラリである。Pgx には AlphaZero の学習の例と、学習済みのオセロ用ネットワークが付いている。後者を以下「Pgx の基準モデル」と呼び、比べる相手に使う(詳しくは第5章の Pgx の基準モデル)。
この節の AlphaGo・AlphaZero は、元の方式どおり勝ちを目指す(得点は勝ち 1・負け −1)。問題の設定の「負けを目指す」とは得点の符号が逆である。
先読みの手順
この節では、両方式が対局時に使うモンテカルロ木探索(以下、第3章では「探索」)を定義する。探索は、いまの局面から先の局面を木の形で少しずつ広げ、各手の良さを見積もる。見積もりに使うのは、局面 で手 を選ぶ確率 (事前確率)と、局面 の手番側から見た見込み (〜)を出すネットワークである。終局した局面には手番側が無いので、終局した局面 の見込みは「最後に打った側の相手から見た結果」(勝ち 1・引き分け 0・負け −1)と決める。こう決めると、終局していない局面と同じく「次にこの局面で打つはずの側」から見た値になる。
木の各枝(局面 と手 の組)に、その枝を通った回数 と、その枝を通った探索で得た見込みの合計 (局面 の手番側から見た値)を持たせ、平均を とする。局面 そのものを通った回数を とする( を木に加えたときの評価を1回と数えるので、)。
探索の1回(シミュレーション)は、次の3段階からなる。
- 選択:根(いまの局面)から始め、木の中にある局面 では、式(47) の値が最大の合法手 を選んで進む。
- 評価:木の外の局面 に着いたら、ネットワークで と を求め、 を木に加える。終局していればネットワークを使わず、上で決めた終局の見込みを使う。
- 逆伝播:根から までに通った各枝 について、 に 1 を足し、 に「 の手番側から見た の見込み」を足す。オセロでは打つ・パスするのどちらでも手番が交互に替わる(パスも1手と数える)ので、 から までの手数が偶数なら を、奇数なら を足す。
選択の値は、AlphaGo の論文と、このページの実装(mctx の muzero_policy)で少し違う。この節では実装の形を定義し、論文の形は下の折りたたみに置く。局面 の見込み を「 を通った全シミュレーションで に届いた見込みの平均」( を加えたときの評価を含む)とし、 を兄弟の手の中で 0〜1 に伸ばした値を (式(45)。最小・最大は、 と、1回以上通った手の の中でとる)、探索の広さを決める係数を (式(46))とする。
式(47) の第2項は、事前確率が高く、まだ通った回数が少ない手ほど大きい。通った回数が増えると で小さくなるので、回数を重ねると第1項(実際に読んだ結果の平均)で選ぶようになる。 は が 19652 に比べて小さい間はほぼ 1.25 である( で )。決めた回数 だけシミュレーションをくり返した後、根で通った回数 が最大の手を打つ。
詳しくはこちら(AlphaGo の論文の形)
AlphaGo の論文は、 を伸ばさず、係数を定数 にした形を示している(原文: "a_t = argmax_a (Q(s_t, a) + u(s_t, a)) using a variant of the PUCT algorithm, u(s, a) = c_puct P(s, a) √(Σ_b N_r(s, b)) / (1 + N_r(s, a))" — AlphaGo 論文 Methods)。論文の がこのページの 、 が にあたる。 の中は、論文が子の回数の和、mctx が親の回数 (子の回数の和+1)で、1だけ違う。AlphaGo は多数のスレッドで同時に探索し、同じ枝に集中しないように通過中の枝を一時的に負けとして数える工夫(virtual loss)も使ったが、このページの実装は1本の探索なので使わない。
先読みの回数
この節では、後の 学習の結果 と第5章の レーティング(AI と人間) の表に出てくる「先読み 8 回」「先読み 32 回」「先読み 100 回」が何の回数かを示す。回数は、上の 、つまりシミュレーションの回数である。1 回のシミュレーションでは、上の 3 段階(選択・評価・逆伝播)を 1 回ずつ行う。「評価」の段階で木に加わる局面は 1 つなので、先読み 回は、1 手を決めるのに木に最大 個の局面を加え、1 局面の評価を根の評価と合わせて 回行う(評価に使った mctx は終局に着いた回も評価し、その値を使わない。ブラウザの実装は終局に着いた回は評価しないので、最大 回)。1 回の評価で使うネットワークは、AlphaZero と Pgx の基準モデルでは 1 つ、AlphaGo 方式では確率と見込みの 2 つ(このページの実装)なので、ネットワークの計算は AlphaGo 方式だけ 2 倍になる。
最後に、根で通った回数 が最大の手を打つ。最大の手が複数あるときは、mctx はその中から乱数で 1 つ選ぶ(muzero_policy は通った回数の割合の対数から最大値を引き、temperature=0 の代わりにごく小さい数で割ってから抽選するので、最大の手だけが同じ確率で残る)。「先読みなし」は、根でネットワークの確率 が最大の手を打つことを指す。
小さな例
この節では、合法手が 3 つの局面で 8 回シミュレーションしたとき、式(45)〜式(47) で各回にどの手が選ばれ、通った回数と がどう変わるかを示す。根の合法手を A・B・C、事前確率を 、、、根の見込みを とする。根の動きだけを見るため、各シミュレーションで根に戻ってくる値(根の手番側から見た値)は、ネットワークの代わりに次のように決めておく:A を通ると 1 回目は 、2 回目以降は (ひと目では良いが、深く読むと悪い手)、B を通るといつも 、C を通るといつも (実は最も良い手)。
1 回目は、どの手も通った回数が 0 なので 式(45) の はすべて 0 で、 なので 式(46) は である。式(47) の値は第 2 項だけになり、事前確率に比例する。
式(48) で A が最大なので A を通り、 が戻る。2 回目は 、、 なので、式(45) の最小・最大は 、 で、 になる。まだ通っていない B・C の は 0 のままである。
式(49) でも A が選ばれ、今度は が戻る。 に下がり、(四捨五入)になるので、3 回目は で になり、A の第 1 項の上乗せが無くなる。各回の値は次の表のとおり(各回の、手を選ぶ前の値。「―」はまだ通っていない手。値は Python で計算し、四捨五入した)。
| 回 | 根を通った回数 | 根の見込みの平均 | 係数 | A の平均 | B の平均 | A の値 | B の値 | C の値 | 選んだ手 | 戻った値 |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 1 | +0.000 | 1.2501 | ― | ― | 0.625 | 0.375 | 0.250 | A | +0.2 |
| 2 | 2 | +0.100 | 1.2502 | +0.20 | ― | 1.442 | 0.530 | 0.354 | A | −0.4 |
| 3 | 3 | −0.067 | 1.2502 | −0.10 | ― | 0.361 | 0.650 | 0.433 | B | 0.0 |
| 4 | 4 | −0.050 | 1.2503 | −0.10 | 0.00 | 0.417 | 1.375 | 0.500 | B | 0.0 |
| 5 | 5 | −0.040 | 1.2503 | −0.10 | 0.00 | 0.466 | 1.280 | 0.559 | B | 0.0 |
| 6 | 6 | −0.033 | 1.2504 | −0.10 | 0.00 | 0.510 | 1.230 | 0.613 | B | 0.0 |
| 7 | 7 | −0.029 | 1.2504 | −0.10 | 0.00 | 0.551 | 1.198 | 0.662 | B | 0.0 |
| 8 | 8 | −0.025 | 1.2505 | −0.10 | 0.00 | 0.589 | 1.177 | 0.707 | B | 0.0 |
表の列は順に、、、、、、各手の 式(47) の値である。4 回目以降は なので で、B が選ばれ続ける。8 回が終わると通った回数は A 2 回・B 6 回・C 0 回で、B を打つ。C は最も良い手だが、通った回数が 0 の手の は 0(式(45))なので、C の第 2 項が B の値( B の第 2 項)を超えるまで選ばれない。
回数を増やすと変わること
この節では、先読みの回数を増やすと何が変わるかを、上の例と実測で示す。式(47) の第 2 項は に比例して増え、通った手では で割られるので、回数を増やすと、事前確率の低い手やまだ通っていない手も選ばれるようになる。上の例を同じ決め方で続けると、32 回では 20 回目に初めて C が選ばれ、通った回数は A 3・B 17・C 12(B を打つ)、100 回では A 6・B 17・C 77 で C を打つ。回数が少ないと、事前確率の低い手は 1 度も読まれないことがあり、回数が多いと、この例では読んだ結果()が良い手が選ばれた。
実測では、同じ Pgx の基準モデルの強さ(第5章の レーティング(AI と人間) で定義する尺度。先読みなしを 1000 とする)は、先読みなし 1000、8 回 1165、32 回 1320、100 回 1436 と、回数とともに上がった。このページの AlphaZero(反復 150 回)は、先読みなし 997 から先読み 32 回で 1338 になった。1 手に行う局面の評価は回数+1 なので、計算は回数にほぼ比例して増える。
ブラウザで対戦するときの先読み
この節では、このページのモデルとブラウザで対戦するための HTML ページ(このページとは別のページ)での先読みが、評価に使った実装と同じかを示す。対戦用のページでは、見込みのネットワークを持つモデル(AlphaZero・AlphaGo 方式・Pgx の基準モデル)について、先読みの回数を 0・8・32・100 から選べる。0 は先読みなしで、確率が最大の手を打つ。計算は、そのページを開いたブラウザが JavaScript で CPU を使って行う(convnet.js。GPU は使わない)。
評価では mctx の muzero_policy を pb_c_init=1.25(pb_c_base は既定の 19652)、乱数の上乗せ無し(dirichlet_fraction=0.0)、temperature=0.0 で使った(eval_search.py)。ブラウザの mctsSearchAsync(中身は simulate と selectAction)を読むと、次の点が mctx と同じだった。
- 選ぶ手の値は 式(47) で、係数は 式(46) と同じ
1.25 + log((C(s) + 19652 + 1)/19652)。 - は 式(45) と同じで、通っていない手は 0、最小・最大は親の見込みの平均と、通った手の からとる。
- 葉の見込みは、手番が替わるたびに符号を反転して足す。終局の扱いは、終局に入る枝に最終結果を足し、終局した局面の見込みを 0 とする形で、mctx に渡した
recurrent_fnと同じである。この形で枝に足される値は、上の 先読みの手順 の「終局した局面の見込みを結果とする」決め方で足される値と同じになる。 - 選ぶ段階で同じ値の手が並んだときは、値に 倍の一様乱数を足して 1 つに決める(mctx の
muzero_action_selectionと同じ大きさ)。最後に打つのは通った回数が最大の手。
違うのは 3 点ある。ブラウザではネットワークの重みを 16 ビットの浮動小数で持つ(評価は 32 ビット)。通った回数が最大の手が複数あるとき、ブラウザはマスの番号(a1 を 0 として行ごとに数えた番号)が最も小さい手を打ち、mctx は乱数で選ぶ。乱数の列も違う。同じかどうかを実際に確かめるため、2026-10-20 に、乱数で打って作った 11 局面で、AlphaZero(反復 150 回)の先読み 32 回を両方で動かした。11 局面すべてで、各手の通った回数が一致し、打つ手も一致した(スクリプトと結果は手元の othello-lose/check_mcts/。ブラウザ側は mctsSearchAsync と同じ simulate を使う mctsSearch を呼んだ)。ただし 11 局面のうち 6 局面は 32 回のうち 30 回以上が 1 つの手に集まった局面(うち 3 局面は合法手が 1 つ)で、違いが出にくい。AlphaGo 方式と Pgx の基準モデルでは確かめていない。対戦用のページの場所は、このページには載せていない。
AlphaGo の学習
この節では、AlphaGo の学習を3段階で定義する。手の確率を2種類(人をまねた と、自己対戦で強くした )、見込みを1種類()学習し、対局時の探索では を事前確率、 を見込みに使う。
人の棋譜での教師あり学習
この節では、人が打った手を当てるように を学習する式を示す。人の対局から集めた局面と打った手の組を ()とする。 のパラメータ は、人の手の確率の対数の平均を大きくする(交差エントロピーを小さくする)ように学習する。
式(50) は、式(25) で有利さをすべて 1 にした形と同じで、人が打った手は「良い手」とみなして一律に確率を上げる。AlphaGo は囲碁の約 3,000 万局面でこれを学習し、人の手を当てる割合は 57.0% だった(原文: "We trained a 13-layer policy network, which we call the SL policy network, from 30 million positions from the KGS Go Server. The network predicted expert moves on a held out test set with an accuracy of 57.0% using all input features" — AlphaGo 論文)。
自己対戦の方策勾配法
この節では、 から始めて勝てる方策 に直す方法を示す。考え方は 方策勾配 の節と同じ方策勾配法で、違いは相手である。相手は、学習中の方策の過去のパラメータを集めた「相手の集まり」から、1回の更新(128 局)ごとに乱数で1つ選ぶ。AlphaGo は 500 回の更新ごとに、そのときのパラメータを相手の集まりに加えた(原文: "Every 500 iterations, we added the current parameters ρ to the opponent pool."、ここでの ρ は方策のパラメータで、このページの とは別のもの — AlphaGo 論文)。相手を固定しないのは、決まった相手にだけ勝つ方策に偏るのを防ぐためと、論文は説明している(原文: "Randomizing from a pool of opponents in this way stabilizes training by preventing overfitting to the current policy.")。このページとは別に、手元で勝ちを目指す方策勾配法の MLP(方策 の節と同じネットワーク)を、学習相手だけ変えて 2,000 回まで学習した。角を優先する相手(マスの点数表で最も高い手を打つ相手。1・2群目の学習には使っていない)に勝った割合は、保存した 5 時点(73・250・500・1,000・2,000 回)で、ランダムな相手だけと学習したもの 5.4〜22.1%、半分を過去の自分と打ったもの 20.9〜37.5%、角を優先する相手も学習相手に入れたもの 76.0〜90.6% だった(各 2,048 局。3群目は学習で見た相手への値)。学習に使っていない相手への勝率は、相手を過去の自分に替えても 20.9〜37.5% にとどまり、回数に対して上がり続けもしなかった(250 回で 37.5%、2,000 回で 20.9%)。この実験からは、相手の集まりを使えば偏りが防げるとは言えない。AlphaGo の相手の集まりは、先読みや人の棋譜と組み合わせて使われている。
元の AlphaGo の更新は、得点から引く値(ベースライン)を、学習の手順全体の1周目では 0、2周目は見込みのネットワークの値 (局面ごとに変わる)にし、対局数で割った(原文: "using the REINFORCE algorithm with baseline v(s_t) for variance reduction. On the first pass through the training pipeline, the baseline was set to zero; on the second pass we used the value network vθ(s) as a baseline" — AlphaGo 論文 Methods)。1回の更新に 128 局を使った(原文: "The policy network was trained in this way for 10,000 mini-batches of 128 games")。このページの実装は、式(25)(ベースラインは 式(20) の得点の平均)とほぼ同じ更新を使った。違いは割る数で、式(25) はパスを数えない AI の手の総数、実装は AI のパスも数えた手の総数で割る。
見込みのネットワーク
この節では、局面からその後の勝ち負けを予測する の学習を示す。 どうしで最後まで打った対局から、局面 と、その手番側から見た最終結果 (勝ち 1・引き分け 0・負け −1)の組を 個集め、2乗誤差を小さくする。
は のパラメータである。式(51) を小さくする は、同じ局面 から先の結果の平均に近づく。Q 学習 の節で示した「定数との2乗誤差の平均は平均値で最小」と同じ理由である。
1局から取る局面は1つだけにする。同じ対局の局面はどれも同じ を持ち、隣り合う局面は石1個しか違わないので、全局面を使うと局面ではなく対局ごとの結果を覚えてしまう。AlphaGo の論文は、人の棋譜の全局面で学習したとき、学習データの2乗誤差 0.19 に対し検証データでは 0.37 だったと報告している(原文: "the value network memorized the game outcomes rather than generalizing to new positions, achieving a minimum MSE of 0.37 on the test set, compared to 0.19 on the training set")。そのため AlphaGo は、1局から1局面だけを取った 3,000 万局で学習した。各対局は、乱数で決めた手数 について、 手目まで で打ち、 手目だけ合法手から等確率で選び、その後は で終局まで打って、 手目の直後の局面を使った(AlphaGo 論文 Methods)。
対局時の探索
この節では、AlphaGo が対局時に3つのネットワークをどう組み合わせるかを示す。先読みの手順 の事前確率に を使う。論文は、 より のほうが探索の事前確率として強かったと報告している(原文: "the SL policy network pσ performed better in AlphaGo than the stronger RL policy network pρ, presumably because humans select a diverse beam of promising moves")。
葉の見込みには、 と、軽い方策で終局まで打った結果 を、重み で混ぜた値を使う。
論文では が最も強かった(原文: "the mixed evaluation (λ = 0.5) performed best")。 は対局には直接使わず、 を学習するための対局を作る役である。
AlphaZero の学習
この節では、AlphaZero が人の棋譜を使わずに、探索の結果そのものを学習の目標にする方法を示す。ネットワークは1つで、手の確率 と見込み の両方を出す(AlphaZero の方式 の節の記号)。学習は次のくり返しで、このくり返しの1周を「反復」と呼ぶ(1回の反復の中で、パラメータの「更新」を何回も行う)。
- いまのネットワークで探索しながら自己対戦する。各局面 で、探索で各手を通った回数の割合 を記録し、手は に従って乱数で選ぶ。
- 終局したら、記録した各局面に、その手番側から見た最終結果 を付ける。
- 式(43) の損失を小さくするように を更新する。第1項で を最終結果に近づけ、第2項で を探索の割合 に近づける。
第2項が要点で、式(25) の方策勾配法とは学習の信号が違う。方策勾配法は「その対局に勝ったか」だけで、打った手全部の確率を一律に上げ下げする。AlphaZero は、局面ごとに「探索した結果どの手を何回調べたか」という手ごとの目標を与える。探索は と を使って先を読むので、 は そのものより良い手に偏ると期待される。 を に近づけると、次の自己対戦ではその改善された確率から探索が始まる。この「探索で改善 → ネットワークがそれをまねる」のくり返しで強くなる。AlphaZero の論文は、チェス・将棋・囲碁で、この学習が既存の最強のプログラムを上回ったと報告している(AlphaZero 論文)。 が より必ず良いことは、ここでは示さない。
Gumbel AlphaZero
この節では、このページの AlphaZero の実装が学習中に使った探索の変形(Gumbel AlphaZero)を示す。元の AlphaZero は1手あたり 800 回シミュレーションしたが(原文: "During training, each MCTS used 800 simulations." — AlphaZero 論文)、回数を減らすと が粗くなる。Gumbel AlphaZero は少ない回数(このページでは 32 回)でも使える目標と手の選び方を作る。
まず、根で調べていない手の見込みを補う。ネットワークの見込みと、調べた手の平均を事前確率で重み付けした値を、通った回数で混ぜた値を とする( は1回以上通った手の集合)。
調べた手は 、調べていない手は 式(53) の を入れた値を、補完した見込み とし、これを最小 0・最大 1 に伸ばした値を とする。 をソフトマックスをとる前のネットワークの出力(式(4) の と同じ役)として、学習の目標の確率を次で定義する。
式(54) は、ネットワークの出力を、探索で見積もった見込みが高い手の方へずらしたものである。このページでは mctx の既定値 、 を使った(mctx の qtransform_completed_by_mix_value、Gumbel の論文 の付録 D)。学習では 式(43) の の代わりに を使う。
手の選び方も 式(47) と違う。根では、各手に独立なガンベル分布の乱数 を足し、 の大きい順に最大 16 手を候補に残す。シミュレーションを何回かずつ候補に割り振るごとに、 の小さい半分を候補から外し(逐次半減)、最後まで残った候補のうちこの値が最大の手を打つ。32 回・16 候補では、候補は 16 → 8 → 4 と減り、最後の 8 回は残った 4 手に 2 回ずつ割り振られる。名前の Gumbel はこの乱数から来ている。根より深い局面では、乱数を使わず、式(54) と同じ形の確率から通った割合を引いた値 が最大の手を選ぶ。こうすると、通った回数の割合が に近づく(mctx の gumbel_muzero_root_action_selection・gumbel_muzero_interior_action_selection、Gumbel の論文 5節)。
このページの実装
この節では、このページで動かした AlphaGo・AlphaZero の実装が、元の方式とどこが違うかを示す。どちらも、ネットワークは同じ形(入力 8×8×2、畳み込み 64 チャンネル、残差ブロック 6 個、手の確率 65 個(64 マス+パス)と見込み1個)で、Colab の GPU で学習した。ここで使う用語は次のとおりである。チャンネルは、1 マスあたりに持つ値の数で、入力は「手番側の石」「相手の石」の 2 チャンネルである。3×3 の畳み込みは、各マスについて周りの 3×3 マスの全チャンネルの値に重みをかけて足し、出力のチャンネルごとに 1 つの値を作る計算で、同じ重みを全マスで使う。1×1 の畳み込みは、周りのマスを使わず、各マスの値だけからチャンネルの数を変える畳み込みである。残差ブロックは、「BatchNorm(下で定義)と ReLU を当ててから 3×3 の畳み込み」を 2 回通した結果に、ブロックへの入力をそのまま足す塊である(othello_net.py の Block)。BatchNorm は、1 回の計算にまとめて入れた局面の集まり(バッチ)の中で、チャンネルごとに平均と分散で値をそろえる層で、式は第6章の BatchNorm の統計 で示す(othello_net.py)。
| 項目 | AlphaGo(元) | AlphaGo(このページ) | AlphaZero(元) | AlphaZero(このページ) |
|---|---|---|---|---|
| 人の棋譜 | KGS(囲碁の対局サーバー)の約 3,000 万局面 | WTHOR(フランスのオセロ連盟が配る人の対局の棋譜集)の 13.8 万局(823 万局面)。2024・2025年の約 35 万局面は検証用にし、学習には約 788 万局面を使う | 使わない | 使わない |
| 自己対戦の方策勾配法 | 128 局 × 1万回。相手の集まりに 500 回ごとに追加。ベースラインは 0 または見込み | 128 局 × 1,000 回。相手の集まりに 100 回ごとに追加。ベースラインは得点の平均 | ― | ― |
| 見込みの学習データ | 1局1局面、3,000 万局。乱数の手の前は | 1局1局面、26 万局。乱数の手の前も | 自己対戦の全局面 | 256 手の範囲で終局した対局の局面だけ |
| 学習中の探索 | ― | ― | 800 回。PUCT(AlphaGo Zero と同じで、式は論文に無い)。根に乱数(ディリクレ分布)を足し、訪問回数の割合を目標 | 32 回。Gumbel AlphaZero(式(54))。根の乱数はガンベル分布 |
| 1回の反復 | ― | ― | ― | 1,024 局を同時に 256 手分(約 26 万局面)打ち、4,096 局面ずつ 64 回更新。過去の反復の対局はためない |
| 損失 | ― | 式(50)・式(51) | 式(43)(重みの大きさの項あり) | 式(43) から重みの大きさの項を除き、見込みの項を 倍 |
| 葉の見込み | 見込みのネットワークと終局までの試し打ちを半分ずつ | 見込みのネットワークだけ(式(52) で ) | ネットワーク | ネットワーク |
| 対局と評価での探索 | 式(47) の折りたたみの論文の形 | 式(47)(mctx の muzero_policy)。事前確率は 、見込みは | PUCT(式は論文に無い) | 式(47)(mctx の muzero_policy。 と は MuZero の形) |
評価で先読みさせた 3 種類の打ち手が、先読みの手順 の事前確率 と見込み に何を使ったかは次のとおり(eval_search.py の make_player の az・ag・pgxs)。3 つとも探索の規則は同じ(式(45)〜式(47)、mctx の muzero_policy)で、違うのはネットワークだけである。
| 打ち手 | 事前確率 | 見込み |
|---|---|---|
| AlphaZero・先読み(各反復の時点) | その時点のネットワークの手の確率 | 同じネットワークの見込み |
| AlphaGo 方式・先読み | 段階1 の (24,000 回の更新後) | 段階3 の (6,000 回の更新後) |
| Pgx の基準モデル・先読み | Pgx の基準モデルの手の確率 | Pgx の基準モデルの見込み |
学習の結果
この節では、上の実装を 2026-10-20 に Colab で学習・評価した結果を示す。評価では、モデルに確率が最大の手(先読みなし)か、式(47) の先読み 32 回で打たせた。どちらも乱数を使わないので、そのままでは同じ対局がくり返される。そこで最初の 4 手だけ乱数で打った。行のモデルに割り当てるプレイヤーは半分ずつにしたが、Pgx は先に打つ側を局ごとに乱数で決めるので、行のモデルが先手になる局数はちょうど半分ではない。乱数の種はすべての組で同じなので、同じ局数の組どうしは同じ序盤の集まりで比べている。局数は、先読みなしのモデルと基準の相手の組が 512 局、それ以外が 256 局で、引き分けは勝ちに数えていない。勝率 50% 前後の標準誤差(局数を として )は、256 局で 3.1 ポイント、512 局で 2.2 ポイントである。
この節で使う相手の名前は次のとおり。「角を優先する相手」は 自己対戦の方策勾配法 の節と同じ、マスの点数表で最も高い手を打つ相手(点数表は第4章の このページの打ち手との対比 の折りたたみ)。「返す数が最多の相手」は第2章の 方策勾配法の学習の結果 と同じ、その場で返せる石が最も多い手を打つ相手。「Pgx の基準モデル」は、Pgx に付属するオセロの学習済みモデル(othello_v0)に確率が最大の手を打たせたもの。「MLP(混合で学習)」は 自己対戦の方策勾配法 の節の3群目(ランダムな相手・過去の自分・角を優先する相手と学習した MLP、2,000 回)、「MLP(ランダムだけで学習)」は1群目(ランダムな相手だけと学習した MLP、2,000 回)である。
学習にかかった時間と量は次のとおり。計算機は colab status の表示で、AlphaZero が L4、AlphaGo 方式が T4 だった。
| 方式 | 計算機 | 時間 | 学習の量 |
|---|---|---|---|
| AlphaZero | Colab の L4 1台 | 171.6 分 | 150 回の反復、自己対戦 614,567 局(3,932 万局面) |
| AlphaGo 方式 段階1 | Colab の T4 1台 | 32.5 分 | 24,000 回の更新(1回 1,024 局面、のべ 2,458 万局面) |
| AlphaGo 方式 段階2 | 同上 | 24.0 分 | 1,000 回の更新(1回 128 局、のべ 12.8 万局) |
| AlphaGo 方式 段階3 | 同上 | 17.9 分(対局 10.0 分(学習ログの「value data」の行)+学習 7.9 分) | 26.2 万局から 1 局面ずつ、6,000 回の更新 |
学習・評価を合わせた Colab の計算ユニットの消費は 7.25 CU だった(colab usage の残高が、学習前の 400.00 から 392.75 に減った)。
AlphaGo 方式の各段階の値は次のとおり。段階1 の人の手を当てる割合は 56.0%(学習に使っていない 2024・2025 年の 2 万局面)。段階3 の見込みの2乗誤差は 0.798(学習に使っていない 1.6 万局面)で、学習の初め(200 回)の 0.851 から下がった。結果が勝ち 1・負け −1・引き分け 0 のとき、常に 0 と答えると2乗誤差は引き分けでない局面の割合に等しい。このデータの引き分けの割合は数えていないが、上の総当たりの対局での引き分けは 0〜9% だったので、基準はおよそ 0.9〜1 で、0.798 は「少し当たるようになった」程度の値である。段階2 の記録の「段階1 に勝った割合」は、段階2 側が確率最大の手、段階1 側が確率に従う乱数の手で打った値で、最初の記録(25 回)ですでに 87.3%、1,000 回まで 84.9〜88.4% で横ばいだった。打ち方の違いの効果が大きく、学習の効果を示す値ではない。
基準の相手に勝った割合(AlphaZero は保存した 11 時点のうち主な 5 時点。列の「先読み」は、行のモデルが先読みするかどうかで、相手はいつも先読みしない):
| モデル | 角を優先する相手・モデルは先読みなし | 角を優先する相手・モデルは先読み 32 回 | Pgx の基準モデル・モデルは先読みなし | Pgx の基準モデル・モデルは先読み 32 回 | 返す数が最多の相手・モデルは先読みなし | 返す数が最多の相手・モデルは先読み 32 回 |
|---|---|---|---|---|---|---|
| AlphaZero 反復 0 回(学習前) | 14.6% | 19.5% | 0.6% | 2.3% | 32.4% | 48.0% |
| AlphaZero 反復 10 回 | 80.7% | 96.5% | 8.6% | 18.4% | 86.7% | 87.9% |
| AlphaZero 反復 40 回 | 86.1% | 94.9% | 24.6% | 64.5% | 69.7% | 72.7% |
| AlphaZero 反復 80 回 | 92.0% | 96.9% | 38.5% | 77.0% | 72.3% | 71.1% |
| AlphaZero 反復 150 回 | 90.6% | 95.3% | 52.7% | 86.7% | 67.8% | 73.4% |
| AlphaGo 方式 段階1(人の棋譜だけ) | 91.4% | ― | 49.8% | ― | 63.5% | ― |
| AlphaGo 方式 段階2(自己対戦後) | 90.4% | ― | 51.6% | ― | 60.0% | ― |
| AlphaGo 方式(段階1 の確率+段階3 の見込みで先読み) | ― | 98.0% | ― | 78.1% | ― | 68.8% |
| MLP(混合で学習) | 82.6% | ― | 1.0% | ― | 74.4% | ― |
| MLP(ランダムだけで学習) | 23.0% | ― | 1.2% | ― | 93.4% | ― |
主なモデルどうしの総当たり(行のモデルが列のモデルに勝った割合、すべて 256 局)。上の表の 512 局の組とは序盤の集まりが違うので、同じ組でも値が少し違う(例:AlphaZero 150 回・先読みなしと Pgx の基準モデルは 52.7% と 51.2%)。
| 行のモデル | AlphaZero 150 回・先読み | AlphaZero 150 回・先読みなし | AlphaGo 方式・先読み | AlphaGo 方式 段階1 | AlphaGo 方式 段階2 | MLP(混合で学習) | MLP(ランダムだけで学習) | Pgx の基準モデル |
|---|---|---|---|---|---|---|---|---|
| AlphaZero 150 回・先読み | ― | 93.8% | 64.8% | 85.9% | 90.2% | 96.9% | 98.8% | 86.7% |
| AlphaZero 150 回・先読みなし | 4.7% | ― | 21.5% | 44.5% | 49.6% | 97.3% | 96.5% | 51.2% |
| AlphaGo 方式・先読み | 26.6% | 73.8% | ― | 83.6% | 80.1% | 97.3% | 98.0% | 78.1% |
| AlphaGo 方式 段階1 | 12.5% | 51.2% | 12.9% | ― | 49.6% | 96.5% | 94.5% | 51.6% |
| AlphaGo 方式 段階2 | 9.4% | 46.1% | 17.6% | 45.7% | ― | 99.2% | 94.9% | 50.0% |
| MLP(混合で学習) | 0.8% | 1.2% | 0.4% | 1.2% | 0.0% | ― | 2.0% | 0.8% |
| MLP(ランダムだけで学習) | 1.2% | 3.5% | 0.4% | 5.1% | 5.1% | 96.5% | ― | 1.6% |
| Pgx の基準モデル | 12.5% | 45.3% | 19.1% | 42.6% | 46.1% | 98.8% | 97.7% | ― |
表から読めることは次のとおり(どれも1回の学習・1回の評価の値で、乱数の種を変えたくり返しはしていない)。
- 先読みの効果:同じ AlphaZero 150 回のネットワークで、Pgx の基準モデルに勝つ割合は、先読みなし 51.2% から先読み 32 回で 86.7% に上がった(どちらも 256 局で同じ序盤)。先読みありは、同じネットワークの先読みなしに 93.8% 勝った。
- AlphaZero と AlphaGo 方式:先読みありどうしでは、AlphaZero が 64.8% 勝ち、AlphaGo 方式が 26.6% 勝った(残り 8.6% は引き分け)。先読みなしでは、AlphaZero 150 回と AlphaGo 方式 段階1 の直接対局は、AlphaZero の勝ち 44.5%・段階1 の勝ち 51.2%・引き分け 4.3% で、勝った割合 と負けた割合 の差 の標準誤差は、局数を として で、、、 を入れると約 6.1 ポイントになる。差 6.7 ポイントはその約 1.1 倍なので、互角と区別できない。
- 段階2 の効果:同じ打ち方(どちらも確率が最大の手)での直接対局は、段階2 の勝ち 45.7%・段階1 の勝ち 49.6% で、段階2 で強くなった様子は見えなかった。角を優先する相手と Pgx の基準モデルへの勝率も、段階1 と標準誤差の範囲内で同じだった(91.4% と 90.4%、49.8% と 51.6%、512 局)。
- 方策勾配法の MLP との差:MLP(混合で学習)は、総当たりの表の MLP 以外のすべてのモデルに 1.2% 以下しか勝てなかった。MLP(ランダムだけで学習)も、MLP 以外には 5.1% 以下だった。基準の表の MLP の値は、自己対戦の方策勾配法 の節(2,048 局)とは局数と序盤が違い、差(例:ランダムだけで学習した MLP の角を優先する相手への 23.0% と 22.1%)は標準誤差の程度である。MLP(混合で学習)の角を優先する相手への 82.6% は、学習で見た相手への値である。
- 返す数が最多の相手:この相手への勝率は、強さの順に並ばなかった。AlphaZero(先読みなし)の勝率は、反復 10 回で 86.7%、40 回で 69.7%、150 回で 67.8% と、学習が進むと下がった。総当たりで AlphaZero 150 回(先読みなし)に 3.5% しか勝てない MLP(ランダムだけで学習)は、この相手に 93.4% 勝った。理由は確かめていない。
第3章の確かめ問題
問3-1 小さな例 の 8 回のシミュレーションが終わった後、9 回目に選ばれる手を 式(45)〜式(47) で求めよ(各手を通った回数は A 2 回・B 6 回・C 0 回、戻った値は表のとおり)。
解答(問3-1)
9 回目の前の値を求める。根を通った回数は 。根に届いた見込みは、根を加えたときの と、8 回の戻った値 なので、平均は (四捨五入)である。、。式(45) より 、 なので、、、(通っていない)。式(46) は である。式(47) の値は次のとおり()。
式(55) で B が最大なので、9 回目も B を通る。C の値 0.750 は、8 回目の 0.707 から増えたが、B の値 1.161 には届かない。
問3-2 合法手が 4 つの局面で、探索の 32 回のうち各手を通った回数が (20, 8, 4, 0) だった。元の AlphaZero の学習の目標 (AlphaZero の学習。このページの実装は の代わりに を使う)を求め、式(43) の第 2 項を、ネットワークの確率 が 4 手とも 0.25 のときと、 を に近づけた極限( に 0 の手があり、ソフトマックスの確率は 0 にならないので、 そのものにはならない)について計算せよ( の手の項は 0 とする)。第 2 章の方策勾配法の学習の信号との違いも答えよ。
解答(問3-2)
なので、 である。式(43) の第 2 項 は、 が 4 手とも 0.25 なら 、 を に近づけた極限では である(小数第4位を四捨五入)。 を に近づけると第 2 項は小さくなる。
違い:方策勾配法(式(21))は、1 局の得点 1 つに、その局で打った手の確率の対数の勾配をかける。式(27) のとおり、この勾配は打たなかった手の出力も動かすが、それは打った手の確率を上げ下げする分を確率の和が 1 になるように分けたもので、打たなかった手ごとの良し悪しは使っていない。AlphaZero の第 2 項は、局面ごとに 4 手それぞれの目標の割合を探索で決めて与えるので、打たなかった手についても、手ごとに目標へ向けて動かす。
第4章 探索と評価関数
この章では、ネットワークの代わりに、人が選んだマスの組(形)ごとの点数表で局面に点を付け、何手か先まで読んで手を決める作りを扱う。第2章・第3章の打ち手は手の確率や見込みをネットワークで出したが、この章の打ち手は点数表で局面に点を付け、手は探索で決める。点数表の値は、負けたがる AI では自己対戦の結果から当てはめた。Edax の点数表の作り方は公開されていない。第5章の レーティング(AI と人間) で、AI と人間の強さを Edax を介して比べるので、ここで Edax が何をしているかを先に決めておく。読む順は、オセロのドメイン知識、Edax の作り、このページの打ち手との対比、このページの対局での Edax の条件、Edax の深さとの違い(第3章の先読みの回数との違い)、負けたがる AI(Edax にならった作り) である。この章の記号(、、、、、負けたがる AI の ・・世代 など)は、第4章と、それを引いて使う第5章・第6章の節でだけ使う。
オセロのドメイン知識
この節では、オセロに特有の知識(以下、ドメイン知識)の例とその理由を示す。既製のプログラム Edax がそれをどう使っているかは、次の Edax の作り 以降の節で示す。読む順は、盤の呼び方、知識の例 である。この知識が強いプログラムの作りにどう効くかは、第5章の αβ 探索と AlphaZero の方式のどちらが強いか で、対局の結果と合わせて示す。
盤の呼び方
この節では、以下で使うマスの名前を決める。マスは、列を左から a〜h、行を上から 1〜8 として「a1」のように呼ぶ。4 つの角のマス a1・h1・a8・h8 を隅、隅と斜めに接する b2・g2・b7・g7 を X マス、隅と縦か横に接する b1・a2・g1・h2・a7・b8・h7・g8 を C マスと呼ぶ(第3章の や第2章の とは関係ない)。外周の 28 マスを辺のマスと呼ぶ。このページの打ち手の名前「角を優先する相手」の「角」は、隅のことである。
知識の例
この節では、ドメイン知識の例を 5 つ挙げ、それぞれの理由を、ルールからの理屈か盤面の例で示す。使うルールは次の 2 つである。
- 石が返るのは、打った石と、打った側の別の石とで、縦・横・斜めの 1 直線上に隙間なく挟まれたときだけである。
- 打てるのは少なくとも 1 つ石を返せるマスだけで、打てるマスが 1 つでもあれば、パスはできず、どれかに打たなければならない。
隅と辺の石の返りにくさ
この節では、隅の石が返らないことと、辺の石が辺に沿ってしか返らないことを示す。ある石が返るには、その石を通る直線の上で、その石の前と後ろの両方に相手の石が要る。隅のマスを通る直線は横・縦・斜めの 3 本で、隅はどれの端でもあるので、隅の石の片側にはマスが無く、隅の石は終局まで返らない。隅でない辺のマス(例えば d1)を通る直線は 4 本あり、そのうち辺に沿う 1 本(d1 なら 1 行目)以外の 3 本(d 列と 2 本の斜め)では d1 が端になる。そのため辺の石は、辺に沿った方向でしか返らない。
この 2 つを合わせると、隅の石から辺に沿って同じ色が隙間なく続く石も返らない。例えば a1・b1・c1 が黒なら、c1 を 1 行目に沿って挟むには b1 の側に白の石が要るが、そこは a1 まで黒が続いているので置けない。終局まで返らない石は、最後の石の数にそのまま入る。
隅の隣に打つと隅を与えやすい
この節では、X マス・C マスに打つと相手に隅を打たれる条件ができることを示す。相手が隅 a1 に打てるのは、a1 から出る 3 本の直線(1 行目、a 列、a1 から h8 への斜め)のどれかで、a1 のすぐ隣(b1・a2・b2)から自分の石が隙間なく続き、その先に相手の石があるときだけである。a1 に打って返る石は、この 3 本の上で a1 に接して並ぶ石だからである。したがって b1・a2・b2 に自分の石が無ければ、相手は a1 に打てない。自分が X マス b2 に打つと、例えば c3 に相手の石があり a1 が空いていれば、相手は a1 に打って b2 を返せる。C マス b1 に打つと、c1 に相手の石があれば同じことが起きる。
このページの「角を優先する相手」は、この知識を数で書いた点数表(隅 100、C マス −20、X マス −50 など。全体は下の このページの打ち手との対比 の折りたたみ)で、打てる手のうち点数が最も高い手を打つ。
打てる手の数
この節では、序盤から中盤で「自分の打てる手の数を保ち、相手の打てる手を減らす」ことが指針になる理由を示す。打てる手が 1 つでもあれば、どれかに打たなければならない(上のルールの 2 つ目)。打てる手が多ければ、隅を与える手を避けて選べるが、打てる手が X マス・C マスへの手だけなら、そのどれかを打つしかない。相手の打てる手を減らすと、相手がこの状態になる局面を作れる。これはルールから導ける性質ではなく経験則で、どの局面でも有利になるとは示せない。Edax も、手を読む順番を決めるのにこの量を使う(αβ 探索)。
辺の形
この節では、辺の石の並び(辺の形)が 1 つのまとまりとして良し悪しを持つ理由を示す。隅と辺の石の返りにくさ のとおり、辺の石は辺に沿った方向でしか返らない。そのため辺の 8 マスの色の並びは、辺の上の打ち合いだけで変わる。さらに、隅に接する C マスの石があるかどうかで、隅の隣に打つと隅を与えやすい の条件が決まる。Edax は辺の 8 マスに X マス 2 つを加えた 10 マスの形を 1 つの単位にして点数を付ける(評価関数)。
終盤は最後まで読める
この節では、終盤では終局まで全部の手を読める(読み切り)ことを示す。空きマスの数を とする。終局までの手順は、パスを除くと各手で空きマスのどれか 1 つに打つので、高々 通りである( で )。全部をたどることはできないが、次の αβ 探索 を使うと、結果を変えない枝を読まずに済む。実例として、オセロの終盤問題集 FFO の 40〜59 番(空きマス 20〜34。Edax に付属の problem/fforum-40-59.obf で数えた)の 20 問を、Edax 4.5.5 は終局まで読んで最善の石の差を求め、Core i9-13900K で合計 23.11〜28.42 秒、約 局面で解いた(Egaroucid(オセロのプログラム。作者が技術解説とベンチマークを公開している)のベンチマーク、「The FFO endgame test suite」の表。秒数の幅は、同じ版の 2 つのビルド(x64-v3 と x64)の差)。
Edax の作り
この節では、Edax が上の知識をどう使うかを、ソースで確かめた範囲で示す。対象は、このページの対局に使った Edax 4.7(GitHub の abulmo/edax-reversi、2026-10-13 公開の版を手元でビルド)である。Edax は、局面に点を付ける評価関数と、何手か先まで読む αβ 探索の組み合わせでできている。この章では、局面 を盤面と手番の組とし、点はすべて手番側から見た値とする(第1章の 記号 の は AI から見た向きの盤面で、意味が少し違う)。
評価関数
この節では、Edax が局面に付ける点 を定義する。Edax は盤の上に決まったマスの組(以下「形」)を 46 個置き、各形のマスの状態(手番側の石・相手の石・空きの 3 通りずつ)の並びごとに点数表で点を引き、その合計で局面を評価する。形は次の 12 種類で、回転・裏返しで重なる形は同じ点数表を使う(eval.c の EVAL_F2X・EVAL_SIZE)。
| 形の種類 | マスの数 | 個数 | 例 |
|---|---|---|---|
| 隅の 3×3 | 9 | 4 | a1〜c3 の 9 マス |
| 隅から縦横に 4 マスずつと X マス | 10 | 4 | a1〜a5、b1〜e1、b2 |
| 辺の 8 マスと X マス 2 つ | 10 | 4 | a1〜h1、b2、g2 |
| 辺の両隅と c〜f 列の 1・2 行目 | 10 | 4 | a1、c1〜f1、c2〜f2、h1 |
| 外から 2 本目の行・列 | 8 | 4 | a2〜h2 |
| 外から 3 本目の行・列 | 8 | 4 | a3〜h3 |
| 外から 4 本目の行・列 | 8 | 4 | a4〜h4 |
| 隅から隅への斜め | 8 | 2 | a1〜h8 |
| 7 マスの斜め | 7 | 4 | b1〜h7 |
| 6 マスの斜め | 6 | 4 | c1〜h6 |
| 5 マスの斜め | 5 | 4 | d1〜h5 |
| 4 マスの斜め | 4 | 4 | d1〜a4 |
局面 の空きマスの数を 、46 個の形の集合を 、形 の種類(上の表の行)を 、形 のマスの状態の並びを 3 進数で番号にしたものを とする。点数表 と定数 は、空きマスの数 ごとに別の値を持つ(0〜60 の 61 組。eval.c の EVAL_N_PLY = 61 と、表を選ぶ番号 ply = 60 − 空きマスの数)。
は 0 から遠い側への四捨五入である(eval_accumulate は合計に ±64 を足してから 128 で割り、0 の方向に切り捨てる)。 は −63 より小さい値を −63 に、63 より大きい値を 63 にすることである(search_eval_0 の EVAL_MIN・EVAL_MAX)。式(56) の値は、終局の石の差(手番側の石 − 相手の石)と同じ単位で読む(Edax の点の範囲 SCORE_MIN〜SCORE_MAX が −64〜64)。ソースで確かめたことは次のとおり。
- 評価関数の中に、打てる手の数の項は無い。
eval_accumulateは 46 個の形の点と定数を足すだけである。打てる手の数は、次の αβ 探索 で手を読む順番に使う。 - 点数表はファイル
data/eval.dat(13,952,436 バイト)から読む。ファイルの大きさは、見出しの 28 バイトと、61 組 × 114,364 個 × 2 バイトの和に一致する。114,364 個は、12 種類の点数表を回転・裏返しで同じになる並びをまとめて詰めた数と定数 1 個の和である(EVAL_PACKED_SIZEの合計)。
点数表の値をどう決めたかは、ソースにも README にも書かれていない。人の棋譜や Edax 自身の対局から当てはめた値かどうかは、確かめていない。OLIVAW(AlphaGo Zero の方式で学習したオセロの AI)の 2021 年の論文も、Edax の点数表の作り方は公開されていないと書いている(原文: "Unfortunately, a detailed description of how these value functions are obtained is not publicly available" — OLIVAW 論文 脚注 5)。
αβ 探索
この節では、Edax が何手か先まで読んで手を決める方法を示す。局面 で手 を打った後の局面を 、 で打てる手の集合を (第1章の 記号 の と同じく、打てるマスの集合)とし、 手先まで読んだ局面の値 (手番側から見た値)を次で定義する。 を読む深さと呼ぶ。
は でパスして手番が替わった局面で、パスでは深さを減らさない(midgame.c でパスの後も同じ depth で読む)。終局の値で空きマスを勝った側に数えるのは、Edax の終局の計算(endgame.c の solve)がそうしているからである。符号を反転するのは、相手の手番の値は相手から見た値なので、自分から見るには符号が逆になるからである。ただし Edax の深さ 1 の読み(midgame.c の search_eval_1)は、打った後の局面が終局でも、相手の石を全部返した場合を除いて 式(56) で点を付けるので、式(57) と一致しない場合がある。
式(57) の値を、全部の手をたどらずに求めるのが αβ 探索である。例えば根で手 A を読み終えて値 3 が分かったとする。次に手 B を読むとき、B の後の相手の手の 1 つで B の値が 3 以下と分かれば、相手はその手を選べるので、B の残りの手を読まなくても B は A より良くならない。そこで B の残りを読むのをやめる。こうして省いた枝は最大の値を変えないので、αβ 探索の値は 式(57) と同じになる。打てる手の数が平均 個のとき、深さ の全部の手をたどると末端の局面は 個だが、αβ 探索で良い手から順に読めた場合は 個で済む(Knuth と Moore の 1975 年の結果。ここでは証明しない)。、 では 個と 199,999 個である。読む順番が良いほど省ける枝が増えるので、Edax は手を読む順番を、次の値に重みを掛けて足した点で決める(move.c の movelist_evaluate。括弧の中は重み)。
- 相手の石を全部返す手()と、置換表(下の段落)に記録した、前に読んだときの最善手 2 つ(・)は、ほかの手より先に読む。
- その手の後に相手が打てる手の数(隅は 2 つと数える。
get_weighted_mobility)が少ないほど高い点()。残りの深さが十分あるときは、浅く読んだ値も足す(重みは残りの深さで 〜 に変わる)。浅く読む深さが 3 以上のときは、置換表に記録のある局面へ進む手にも点を足す()。 - 返らない石の数(。浅く読まない並べ替えでは隅とその近くだけ、浅く読む並べ替えでは辺全体を数える)と、その手の後に自分の石に接する空きマスの数(相手が後で打てるようになりうるマスの目安。少ないほど高い点。)。
- マスごとの固定の点数(隅 18、X マス 2 など。
SQUARE_VALUE)と、空きマスの偶奇(〜)。
このほか、同じ局面を 2 回読まないための表(置換表)、深さを 1 つずつ増やして読み直す反復深化、浅く読んだ値から、深く読んでも結果が変わらないと見込める枝を打ち切る ProbCut を使う。ProbCut で省く枝は結果を変えうるので、ProbCut を使うと値は 式(57) と一致するとは限らない。このページの対局では、深さの設定 12・16・21 で ProbCut を使った(このページの対局での Edax の条件)。
終盤の読み切り
この節では、Edax が終盤に終局まで読む条件を示す。Edax は「深さの設定」(対局で使った NBoard という通信の形式では set depth。中では options.level)と空きマスの数から、実際に読む深さ を search.c の表 LEVEL で決める。 が空きマスの数に等しくなると、式(57) の末端はすべて終局になり、終局の石の差を求める(読み切り)。読み切りでも、空きマスが 15 以上のうちは中盤と同じ探索(midgame.c)を使うので、手を読む順番に評価関数を使い、深さの設定によっては ProbCut も使う。空きマスが 14 以下になると、終盤用の探索(endgame.c)を使う(settings.h の DEPTH_MIDGAME_TO_ENDGAME = 15)。深さの設定ごとの値は このページの対局での Edax の条件 の表にある。
定石の本
この節では、Edax の定石の本(book)を示す。Edax は、序盤の局面と手を記録したファイル(data/book.dat)から手を選ぶ機能を持ち、起動の設定 -book-usage で使うかどうかを切りかえる(options.c)。このページの対局では使っていない(このページの対局での Edax の条件)。
このページの打ち手との対比
この節では、このページで比べる打ち手が、どのドメイン知識を、どの形で使っているかを並べる。「方策勾配法の MLP」は、第2章で学習した全結合のネットワーク(方策 で定義)で、学習相手によって「ランダムだけで学習」「自己対戦で学習」(半分を過去の自分と打つ)「混合で学習」(ランダムな相手・過去の自分・角を優先する相手と打つ)の 3 種類がある(自己対戦の方策勾配法)。WTHOR はフランスのオセロ連盟が配る人の対局の棋譜集である。「Pgx の基準モデル」は、Pgx(JAX で書かれたゲーム環境のライブラリ)に付属する学習済みのオセロ用ネットワークで、詳しくは第5章の Pgx の基準モデル で示す。AlphaGo 方式と AlphaZero は第3章の AlphaGo と AlphaZero で定義し、表の「先読み」はそこで定義した探索(モンテカルロ木探索)である。
| 打ち手 | 人が与えた知識 | 学習に使ったもの | 手の選び方 |
|---|---|---|---|
| ランダムな相手 | ルールだけ | 無し | 打てる手から等確率 |
| 返す数が最多の相手 | 「石を多く返す手が良い」という素朴な規則 | 無し | 返す石が最も多い手(同数は乱数) |
| 角を優先する相手 | 隅・X マス・C マスの良し悪しを書いた点数表 | 無し | 点数が最も高い手(同点は乱数) |
| 方策勾配法の MLP | ルールだけ(入力は盤面と打てるマス) | 相手との対局の勝敗。混合で学習した MLP は、角を優先する相手とも対局した | ネットワークの確率が最大の手 |
| AlphaGo 方式 | ルールと人の棋譜 | 人の棋譜(WTHOR)、自己対戦の勝敗 | 先読みなし、または先読み |
| AlphaZero | ルールだけ | 自己対戦の勝敗 | 先読みなし、または先読み |
| Pgx の基準モデル | ルールだけ(Pgx の論文による。手元では確かめていない) | 自己対戦の勝敗(同上) | 先読みなし、または先読み |
| Edax | 形を選んだ評価関数、打てる手の数などによる読む順番、終盤の読み切り | 不明(点数表の値の作り方は非公開) | αβ 探索の最善手 |
表の「ルールだけ」は、ネットワークの入力が盤面(と MLP では打てるマス)で、打てる手・終局・勝敗の判定にルールを使うという意味である。隅の良し悪しや辺の形のような知識を、点数表や評価関数の形として学習した打ち手に与えてはいない。ただし MLP の入力の打てるマスからは打てる手の数を数えられ、AlphaGo 方式は人の棋譜から学ぶので、人の知識が棋譜を通じて入りうる。学習で身についたかどうかは、このページでは調べていない。
角を優先する相手の点数表
eval_search.py と train_zoo.py の表(行は 1〜8、列は a〜h)。打てる手のうちこの点数が最も高い手を打ち、同点なら乱数で選ぶ(点数に 0〜0.5 の一様乱数を足して最大をとる)。
| 行 | a | b | c | d | e | f | g | h |
|---|---|---|---|---|---|---|---|---|
| 1 | 100 | −20 | 10 | 5 | 5 | 10 | −20 | 100 |
| 2 | −20 | −50 | −2 | −2 | −2 | −2 | −50 | −20 |
| 3 | 10 | −2 | −1 | −1 | −1 | −1 | −2 | 10 |
| 4 | 5 | −2 | −1 | −1 | −1 | −1 | −2 | 5 |
| 5 | 5 | −2 | −1 | −1 | −1 | −1 | −2 | 5 |
| 6 | 10 | −2 | −1 | −1 | −1 | −1 | −2 | 10 |
| 7 | −20 | −50 | −2 | −2 | −2 | −2 | −50 | −20 |
| 8 | 100 | −20 | 10 | 5 | 5 | 10 | −20 | 100 |
このページの対局での Edax の条件
この節では、このページの対局で Edax をどう動かしたかを、対局のスクリプト(edax_match.py・edax_ladder.py)と Edax のソースで確かめた範囲で示す。このページで「深さ 10 の Edax」「Edax 深さ 10」と書くときの 10 は、次の「深さの設定」の値である。
- 起動のしかた:
lEdax-x86-64-v3 -nboard -n 2 -book-usage offで起動し、NBoard の形式で毎手その局面までの手順を渡して 1 手ずつ打たせた。-n 2はスレッドを 2 本使う設定である。時間の制限は付けていない。 - 定石の本:
-book-usage offで使わない設定にした。手元のdata/book.datは 84 バイトで、局面の記録はほぼ無い。 - 評価関数:起動した場所からの既定の場所
data/eval.dat(options.cの既定値)を読む。 - 深さの設定:NBoard の
set depthに渡した値が、Edax の中のoptions.levelになる(nboard.c)。 - 序盤:同じ対局のくり返しを避けるため、最初の 4 手は双方とも打てる手から等確率で選んだ。各組 32 局で、先手・後手を 1 局ごとに入れかえた。
深さの設定ごとの、終盤より前に読む深さ と、終局まで読み切る空きマスの数は次のとおり(search.c の表 LEVEL を読んで数えた)。「確からしさ」は Edax の表 selectivity_table で ProbCut の強さを表す百分率で、100% は ProbCut を使わない。
| 深さの設定 | 終盤より前に読む深さ | 終盤より前の ProbCut | 読み切る空きマスの数 | 読み切りの ProbCut |
|---|---|---|---|---|
| 1〜10 | 設定と同じ | 使わない | 設定の 2 倍以下(設定 10 なら 20 以下) | 使わない |
| 12 | 12 | 確からしさ 73% | 24 以下 | 22〜24 で 98%、21 以下は使わない |
| 16 | 16 | 確からしさ 73% | 27 以下 | 25〜27 で 87%、22〜24 で 98%、21 以下は使わない |
| 21 | 21 | 確からしさ 73% | 30 以下 | 28〜30 で 87%、25〜27 で 98%、24 以下は使わない |
このほか、最善と見込む手順の上の局面では、空きマスが一定の数(設定 10・12 で 10、16 で 12、21 で 14)以下になった所から終局まで読む処理(midgame.c の PV の延長、get_pv_extension)がある。search.c の is_depth_solving によれば、これで最善の手順を終局まで読むのは、設定 10・12・16 では表の「読み切る空きマスの数」の範囲の中だけだが、設定 21 では空きマスが 31〜33 の局面でも、最善と見込む手順に限って終局まで読む。例えば深さ 1 の Edax は、終盤より前は打てる各手の後の局面を 式(56) で評価して最も良い手を打ち、空きマスが 2 以下になると終局まで読む。深さ 21 の Edax は、空きマスが 30 以下になると(ProbCut を使いながら)終局まで読む。
Edax の深さとの違い
この節では、先読みの「回数」と、Edax の「深さの設定」(このページの対局での Edax の条件)が違う数であることを示す。深さの設定が 10 以下の Edax は、終盤より前は、式(57) のとおり、打てる手を全部、設定と同じ深さ まで読み、末端の局面に 式(56) で点を付ける(αβ 探索は結果を変えずに枝を省く)。設定が 11 以上の Edax(このページでは 12・16・21)は、これに加えて ProbCut で、結果を変えうる枝も見込みで省く。調べる局面の数は深さとともに急に増え、OLIVAW の論文の計測では、深さ 4・6・8・10 の Edax は 1 手に平均 1 万・5 万・25 万・200 万局面を調べた(原文: "On average, E4, E6, E8 and E10 explored 10, 000, 50, 000, 250, 000, and 2, 000, 000 nodes to make a move, respectively" — OLIVAW 論文。当時の Edax の版での値)。これに対し先読み 回は、木に局面を最大 個加えるだけで、どの手をどれだけ深く読むかは 式(47) が決める。第3章の 小さな例 の 8 回では C を 1 度も読まず、A を 2 回、B を 6 回読んだ。
| 項目 | 先読みの回数(このページの探索) | Edax の深さの設定 |
|---|---|---|
| 数の意味 | シミュレーションの回数 | 何手先まで読むか(終盤では読み切り) |
| 読む手 | 式(47) で選んだ手だけ。手ごとに深さが違う | 全部の手。αβ 探索で結果を変えない枝を省き、設定 11 以上では ProbCut で結果を変えうる枝も省く |
| 末端の評価 | ネットワークの見込み | 評価関数 (式(56)) |
| 1 手で数える量 | 局面の評価:回数+1(32 回なら 33) | 調べた局面:OLIVAW の論文の深さ 10 で平均 200 万。手元の深さの設定 10 では、10〜22 手目の 10 局面の平均で約 335 万(対局全体の平均ではないので、論文の値と比べられない) |
| 終盤 | 特別な扱いは無い | 空きマスが少なくなると終局まで読む |
表の「1 手で数える量」は、左がネットワークで局面を評価した回数、右が αβ 探索で調べた局面の数で、同じ量ではない。1 回の評価の計算も違う。このページの AlphaZero のネットワークは、残差ブロックの畳み込みだけで 1 局面に積和が約 2,800 万回()だが、式(56) は点数表を 46 回引いて足すだけである。したがって「先読み 32 回」と「深さ 10」は、数の大小で読む量を比べられない。
負けたがる AI(Edax にならった作り)
この節では、Edax にならった作り(形ごとの点数表の評価関数、深さを決めた αβ 探索、終盤の読み切り)で「なるべく負ける」AI を作った方法と結果を示す。第2章の負けたがる MLP は、手の確率をネットワークで出し、方策勾配法で学習した。この節の AI は、点数表の値を自己対戦の結果から当てはめ、手は探索で選ぶ。同じ考え方で勝つ向きに作られた Egaroucid の評価関数は、第5章の Egaroucid の評価関数が学んだもの で示す。プログラムは手元の othello-lose/weak/(探索は C の engine.c、学習は train.py)で、計算はすべて手元の CPU で行った。
作り
この節では、負けたがる AI が局面に付ける点と、手を選ぶ探索を定義する。局面 の点を、式(56) から 1/128 の倍率・丸め・切り詰めを除き、点数表の組を空きマスの数ごとから下の段階ごとに替えた形で、形ごとの点数表の和として定義する。形は 11 種類(隅の 3×3、隅の 2×5、辺の 8 マスと X マス 2 つ、外から 2〜4 本目の行、隅から隅への斜め、7〜4 マスの斜め)で、回転・裏返しで写した 46 個を盤に置く(engine.c の base_sq)。Edax の 12 種類(評価関数 の表)のうち「隅から縦横に 4 マスずつと X マス」と「辺の両隅と c〜f 列の 1・2 行目」の 2 種類の代わりに、「隅の 2×5」(a1〜e1 と a2〜e2 の 10 マスと、その回転・裏返しの 8 個)を使う。点数表は段階ごとに別の値を持つ。段階は、空きマスの数 を 4 で割った商で決め、商が 3 より小さければ 3 とする(engine.c の stage_of)。空きマスは 60 以下なので、段階は 3〜15 になる。
商が 3 より小さい局面(空きマス 11 以下)を段階 3 にまとめるのは、下の学習で記録する局面が空きマス 13 以上(商が 3 以上)で、商が 0〜2 の局面の学習データが無いからである(空きマス 12 の局面も記録しないが、商が 3 なのでもともと段階 3 に入る)。46 個の形の集合を とし、形 の種類 と状態の番号 は 式(56) と同じ意味で使う(種類は上の 11 種類)。段階 の、種類 の形の点数表を 、段階 の定数を とする。どちらも下の学習で決める値である。
式(59) の値は、手番側から見た「相手の石の数 − 自分の石の数」の終局での値の予想である。正解に使うのは、下の 学習 のとおり、空きマス 12 の局面から両者が負けを目指して最善を打ったときの終局の値である。式(59) は下の探索の末端の点に使う。点数表の値の数は、1 段階あたり 11 種類の表の大きさの和 個と定数 の 1 個である。段階は 3〜15 の 13 個なので、使う値は全部で 個になる(ファイルは段階 0〜15 の 16 段階分の場所を持ち、段階 0〜2 は 0 のまま)。
手の選び方は Edax と同じ組み合わせである。読む値は、式(57) の Edax の値と同じ形の再帰で、終局の値を「相手の石 − 自分の石」(空きマスは数えない)にし、末端の点を 式(59) にしたものである。 手先まで読んだ値 (手番側から見た値)を、上の行から順に、最初に当てはまる行で定義する(engine.c の search)。
、、 は 式(57) と同じ意味である。式(57) と違い、深さ 0 では終局していても 式(59) の点を使う(Edax の実装の深さ 1 の読みも、αβ 探索 の節のとおり、終局の局面に評価関数で点を付ける場合がある)。空きマスが決めた数 (以下「読み切る空きマスの数」。既定は 14)より多いうちは、根の各手について 式(60) を αβ 探索で求め、最大の手を打つ。空きマスがそれ以下になったら、深さを限らずに(末端がすべて終局になるまで)同じ再帰を読み切り、「相手の石 − 自分の石」が最大になる手を打つ。読み切りでは、根の手はマスの番号順に読み、根より下の局面では、空きマス 7 以上で同じ局面の値を覚えておく表(置換表)を引き、空きマス 6 以上で相手の打てる手が少ない手から読み、2 手目以降は「最初の手より良いか」だけを調べる PVS を使う(engine.c の best_move・solve)。どれも、省いた枝が結果を変えない工夫である。Edax との違いを次の表にまとめる(Edax の列は第4章の Edax の作り の節、負けたがる AI の列は engine.c による)。
| 項目 | Edax | 負けたがる AI |
|---|---|---|
| 目指す値 | 手番側の石 − 相手の石(終局の空きマスは勝った側に数える) | 相手の石 − 手番側の石(空きマスは数えない) |
| 形 | 12 種類 46 個 | 11 種類 46 個(上のとおり 2 種類を「隅の 2×5」に替えた) |
| 点数表の組 | 空きマスの数ごとに 61 組 | 段階ごとに 13 組 |
| 点の丸めと切り詰め | 128 で割って丸め、±63 で切り詰める | しない |
| 深さ 0 の局面が終局のとき | 式(57) では終局の値。実装の深さ 1 の読み(search_eval_1)は、相手の石を全部返す手を除いて評価関数の点 | 点数表の点 |
| 中盤の探索の工夫 | 反復深化、置換表、ProbCut、打てる手の数などで手を読む順番を決める | 根を除き、残りの深さが 3 以上のとき、点数表の点で手を読む順番を決める。置換表・反復深化・ProbCut は無い |
| 読み切り | 空きマス 15 以上は中盤の探索、14 以下は終盤用の探索 | 根の下で、置換表(空きマス 7 以上)、相手の打てる手が少ない順(空きマス 6 以上)、PVS を使う。根の手はマスの番号順 |
以下、打ち手を「世代 ・深さ ・読み切り 」と呼ぶ。世代は、下の 学習 の節で点数表を作った回の番号(0〜5)である。読み切る空きマスの数を書かないときは 14 とする。
学習
この節では、点数表の値を決める手順と、当てはめの誤差を示す。点数表は、世代ごとに対局で局面を集め(世代 0 は乱数どうし、世代 1 以降は自己対戦)、式(59) をその局面の「正解」に当てはめて作る。
- 世代 0:点数表が無いので、双方とも乱数で打つ。空きマスが 12 になった所で終局まで読み切り(双方とも負けを目指して最善を打つとした値)、その値を、その対局の各局面の正解にする。正解は各局面の手番側から見た値なので、手番が逆の局面では符号を反転して付ける。空きマスが 12 になる前に終局した対局は、実際の終局の値を正解にする。
- 世代 :世代 の点数表で、深さ 2 の探索で自己対戦する。序盤の 2〜12 手(局ごとに乱数で決める)と、それ以降の 5% の手は乱数で打ち、探索で打つ手も各手の値に 0〜1 の一様乱数を足して選ぶ(同じ対局ばかりになるのを避けるため)。空きマスが 12 になったら世代 0 と同じく読み切った値を正解にする。
- 当てはめ:世代 と の局面を合わせ(世代 0 は世代 0 だけ)、局面ごとに乱数で 5% を選んで、当てはめに使わない確かめ用に残す。局面 の正解を と書く。段階ごとに、2 乗誤差 を小さくする向きに、点数表と定数を 150 回動かす(
train.pyのfit_stage)。点数表の値は 0 から、定数は正解の平均から始める。1 回の更新では、各局面の誤差 を、点数表の各値について、その値が出てきたところで足し合わせ(1 局面に同じ値が 2 回出てくれば 2 回足す)、「その値が出てきた回数 + 20」で割り、 をかけた分だけその値を減らす。定数は、誤差の平均の 0.7 倍だけ減らす。出てきた回数の少ない値は 1 回に動く幅が小さいので、150 回で止めると、2 乗誤差の最小値より 0 に近いところに残りうる(推測。最小値まで解けたかは確かめていない)。
1 世代は 96,000 局(約 460 万局面)で、世代 0〜5 の 6 世代を作った。自己対戦は 8 プロセスに 12,000 局ずつ分け、当てはめは段階ごとに別のプロセスで行った(並列にできる理由は第6章の そのまま並列にできる仕事)。1 世代の時間は、自己対戦が 152〜264 秒、当てはめが 270〜443 秒だった(train.log)。
確かめ用の局面での予想の誤差(正解との差の絶対値の平均。単位は石)は次のとおり(gen/log.json)。「定数で予想」は、段階ごとに当てはめに使った局面の正解の平均を、すべての局面の予想にした場合である。確かめ用の局面は対局ごとではなく局面ごとに選んだので、同じ対局の別の局面(正解の大きさが同じで(手番が逆なら符号が逆)、形も近い)が当てはめに使われている。そのため、この誤差は新しい対局での誤差より小さめに出ている可能性がある(確かめていない)。また、世代 5 の局面は世代 4 と 5 の 2 世代分(局面の数は約 2 倍)で、局面を集めた打ち方も世代 0 と違うので、世代 0 と世代 5 の列は同じ条件の比較ではない。
| 段階 | 空きマスの数 | 世代 0・点数表の誤差 | 世代 0・定数で予想した誤差 | 世代 5・点数表の誤差 | 世代 5・定数で予想した誤差 |
|---|---|---|---|---|---|
| 3 | 13〜15 | 6.46 | 10.97 | 7.36 | 11.30 |
| 6 | 24〜27 | 8.87 | 10.91 | 9.25 | 11.46 |
| 9 | 36〜39 | 10.03 | 10.88 | 10.35 | 11.46 |
| 12 | 48〜51 | 10.51 | 10.89 | 10.95 | 11.52 |
| 13 | 52〜55 | 10.45 | 10.98 | 10.93 | 11.51 |
| 14 | 56〜59 | 10.07 | 10.83 | 10.79 | 11.52 |
(小数第3位を四捨五入)
段階 3 から 12 までは、空きマスが多い段階ほど、点数表の予想は定数の予想に近い(差は、世代 0 で 4.51 から 0.38 に縮む)。段階 13・14 では差がやや広がる(世代 0 で 0.54・0.76。丸める前の値の差)。世代 0 の正解は、空きマス 12 まで乱数で打った局面の読み切りの値なので、序盤の局面から当てにくいのは、その後の空きマス 12 までの打ち方が乱数で決まるためと推測する(確かめていない)。定数で予想した誤差は、どの段階でも世代 5 のほうが大きく、世代 5 の正解は世代 0 よりばらついている(世代 5 の局面には世代 4 の局面も入るので、同じ条件の比較ではない)。段階 15 は空きマス 60 の初期局面だけなので、点数表は定数と同じ予想しかできない(gen/log.json で両者の誤差が等しい)。
結果
この節では、負けたがる AI どうしと、比べる打ち手の対局の結果を示す。負けたがる AI どうしと、比べる打ち手の総当たりをした。打ち手は 16 人で、世代 0〜5 の深さ 4(6 人)、世代 5 の深さ 6・読み切り 18 と深さ 8・読み切り 20、点数表をすべて 0 にした深さ 4、第2章と同じ方法で負けを目指して 73 回と 2,000 回更新した MLP(以下「負けたがる MLP(73 回)」「負けたがる MLP(2,000 回)」)、ランダムな相手、返す数が最多の相手、返す数が最少の相手(返せる石が最も少ない手を打つ)、角を優先する相手、角を避ける相手(角を優先する相手の点数表で最も低い手を打つ)である。総当たりは 120 組・各 100 局で、league.py が組を順に、arena.py が 1 組の 100 局を 8 プロセスに分けて打った。最初の 4 手は乱数で、先手・後手は 1 局ごとに入れかえた。乱数の種は局の番号で決めるので、どの組も同じ 100 局分の序盤を使う。この 100 局の 4 手後の局面は 79 通りで、行の打ち手の色まで含めても 88 通りしかない。乱数を使わない打ち手どうしの組では、序盤と色が同じ局は同じ対局になるので、異なる対局は 100 局のうち多くて 88 局である。勝ち負けは「終局時に石が少ない方が勝ち」で数える。主な組は次のとおり(league.json。「石の差」は行の打ち手の石 − 相手の石の 100 局の平均)。
| 行の打ち手 | 相手 | 行の打ち手が勝った割合 | 引き分け | 石の差 |
|---|---|---|---|---|
| 世代 5・深さ 4 | ランダムな相手 | 100% | 0% | −40.8 |
| 世代 5・深さ 4 | 世代 0・深さ 4 | 99% | 0% | −24.1 |
| 世代 5・深さ 4 | 負けたがる MLP(2,000 回) | 100% | 0% | −30.9 |
| 世代 5・深さ 8・読み切り 20 | 世代 5・深さ 6・読み切り 18 | 70% | 12% | −5.1 |
| 世代 5・深さ 8・読み切り 20 | 負けたがる MLP(2,000 回) | 100% | 0% | −35.7 |
| 点数表をすべて 0 にした深さ 4 | ランダムな相手 | 68% | 3% | −12.6 |
| 点数表をすべて 0 にした深さ 4 | 負けたがる MLP(2,000 回) | 14% | 3% | +12.2 |
分かることは次のとおり。
- 負けたがる AI のうち世代 1〜5 は、2,000 回更新した負けたがる MLP に 100 局すべてで勝った(石を少なく終えた)。世代 0 は 98 局勝った。
- 世代 5 は世代 0 に 99% 勝った。世代を重ねた効果と推測する。ただし世代 0 と世代 5 は、局面を集めた打ち方(世代 0 は空きマス 12 まで乱数、世代 5 は世代 4 の点数表による深さ 2 の探索)と、当てはめに使った局面の数(世代 5 は 2 世代分で約 2 倍)が違い、どの違いが効いたかは分けられない(1 回の測定)。
- 点数表をすべて 0 にした AI(空きマス 14 以下では読み切りで打ち、それより前は、探索の末端が終局でない限り手の値がすべて 0 で並ぶので、
engine.cの決め方では並んだ手のうちマスの番号が最も小さい手を打つ)は、負けたがる MLP に 14% しか勝てず、同じ深さ・同じ読み切りの世代 0 には 100 局すべてで負けた。この比較からは、負けたがる AI の強さは、終盤の読み切りより前の打ち方(点数表)から来ていると推測する。ただし、マスの番号が最も小さい手は a1 の隅や 1 行目の手で、隅の石は返らない(第4章の 隅と辺の石の返りにくさ)ので、この決め方は石を減らしたい側には特に不利と推測する。点数表が無いときの比べる相手としては、読み切りより前を乱数で打つ版のほうが適していたが、それは試していない。 - 同じ点数表でも、深く読み早くから読み切る打ち手が強かった(深さ 8・読み切り 20 が、深さ 6・読み切り 18 に 70% 勝った)。深さと読み切る空きマスの数を同時に変えたので、どちらの効果かは分からない。
全員の強さを 1 つの数にした値は、第5章で尺度を定義した後の 負ける強さのレーティング に置く。
ブラウザで対戦できる版(weak/weak_engine.js)も作った。点数表は 0.1 刻みの 8 ビットの整数に丸めて持つ(export_weak.py)。2026-10-21 に、乱数で打って作った局面で C 版と比べると、空きマス 8〜14 の 15 局面の読み切りの値は 15 局面すべてで一致し、空きマス 15〜48 の 60 局面の深さ 4 の最善手は 59 局面で一致した(othello-lose/parallel_study/check_js.py)。手が違った 1 局面(空きマス 40)では、別に計算した手ごとの値は、C 版で f3 が 1.404、e7 が 1.201 で、ブラウザ版はそれぞれ 1.266・1.366 だった(小数第4位を四捨五入)。同じように 0.1 刻みに丸めた点数表を C 版に読ませると、この局面の値はブラウザ版と同じ 1.266・1.366 になり、60 局面のうち 59 局面でブラウザ版と同じ手を選んだ(othello-lose/parallel_study/check_js_rounded.py)。残る 1 局面は、値が 2.035 で並ぶ 2 手のどちらを選ぶかが、C 版の単精度とブラウザ版の倍精度の計算の差で分かれた。したがって、手の違いは点数表の丸めと、並んだ値の扱いから来ている。
比べる相手として、AVILEN の「最弱オセロ」(https://othello.to-kei.net/weak/ )がある。ITmedia の記事(https://www.itmedia.co.jp/news/articles/1908/07/news048.html )によれば、ニューラルネットワークを自己対戦の強化学習で学習させたもので、全日本チャンピオンが負けようとしても 10 回中 9 回勝ってしまった(筆者が記事を読んで要約した内容で、このページの作成では記事の原文を確かめていない)。サイトの AI はサーバー側で手を計算するので(このページの筆者がサイトを使って確かめた範囲。このページでは記録を残していない)、このページの AI と打たせるには、サイトの盤に 1 手ずつ手で入力するか、サーバーに自動で問い合わせる必要がある。どちらもしていないので、強さは比べていない(未実施)。
第4章の確かめ問題
問4-1 打てる手の数が平均 個、読む深さ のとき、全部の手をたどったときの末端の局面の数と、αβ 探索で良い手から順に読めた場合の末端の局面の数(αβ 探索 の Knuth と Moore の式)を求め、その比を答えよ。
解答(問4-1)
全部をたどると 個。良い手から順に読めた場合は 個。比は (四捨五入)で、αβ 探索は末端の局面を約 256 分の 1 にする。深さを 2 増やすと、全部をたどる数は 倍になるが、αβ 探索の数は約 倍にしかならない。
問4-2 負けたがる AI(Edax にならった作り) の点数表について、1 段階あたりの値の数を、11 種類の形のマスの数(9、10、10、8、8、8、8、7、6、5、4)から求めよ。また、式(58) で、空きマスを 4 で割った商が 3 より小さい局面を段階 3 にまとめる理由を答えよ。
解答(問4-2)
1 つのマスは「手番側の石・相手の石・空き」の 3 通りなので、 マスの形の点数表は 個の値を持つ。11 種類の和は 個で、定数 を足すと 167,266 個である。
空きマスが 11 以下の局面は、4 で割った商が 0〜2 になる。自己対戦では空きマスが 12 になったら読み切りで正解を求めて対局を打ち切り、記録するのは空きマスが 13 以上(商が 3 以上)の局面だけなので、商が 0〜2 の局面の学習データが無い。そのため、探索の末端が空きマス 11 以下の局面になったときは、式(58) の で段階 3 の表を使う。
第5章 強さの測り方(レーティング)
この章の「得点」は、第2章の得点 ではなく、勝ち 1・引き分け 0.5・負け 0 で数えた点を表す。この章では、ここまでに作った打ち手と、Edax・Pgx の学習済みモデル・人間の強さを、対局の勝ち負けから 1 つの数(レーティング)にする方法と結果を示し、その結果からオセロで強いプログラムの作りを比べる。読む順は、レーティング(AI と人間)、αβ 探索と AlphaZero の方式のどちらが強いか、負ける強さのレーティング である。
レーティング(AI と人間)
この節では、このページで学習したモデル、比べるための既製のプログラム・学習済みモデル・規則、人間を、1 つの数(レーティング)で並べる。読む順は、尺度の定義、求め方、打ち手の出どころ、Pgx の基準モデル、人間の値の換算、段位の意味、レーティングの表、1000 はどれくらいか、結論と、ほかの AI との比較 である。この節の結果を使って、次の αβ 探索と AlphaZero の方式のどちらが強いか で、オセロで強いプログラムの作りを比べる。この節の ・ は打ち手を表す。
尺度の定義
この節では、レーティングの値が何を表すかを決める。打ち手 のレーティングを とし、 が に勝つ確率 を次で定義する。
この形は Bradley–Terry モデルと呼ばれ、チェスの Elo レーティングと同じ形である。式(61) は差 だけで決まるので、全員に同じ数を足しても確率は変わらない。そこで Pgx の基準モデル(先読みなし。Pgx の基準モデル)を 1000 に固定する。差が 200 のとき強い側が勝つ確率は (四捨五入)、差が 400 のとき である。
式(61) を差について解くと、勝つ確率から差を求める式になる。両辺の逆数から 1 を引くと 、左辺は なので、両辺の常用対数をとって 倍すると次になる。
式(62) は、下の 人間の値の換算 と 結論と、ほかの AI との比較 で、勝った割合から差を見積もるのに使う。
求め方
この節では、全対局から をどう求めたかを示す。対局の結果は、データの出どころごとの記録(例:「AlphaZero 150 回・先読み 32 回と Pgx の基準モデルが 256 局打った」)として残っている。同じ組でも、出どころが違えば別の記録になる(例:MLP(混合で学習)・2000 回とランダムだけで学習した MLP・2000 回の組は、256 局と 512 局の 2 つの記録がある)。記録を で表し、記録 の 2 人を ・、局数を 、 の得点(勝ち 1・引き分け 0.5・負け 0)の合計を とする。
ある打ち手(または打ち手の集まり)が、それ以外の相手に全勝または全敗しているとき、その差を大きくするほど下で最大にする量が大きくなり続け、値が決まらない。全員の値が必ず有限に決まるように、各記録に「引き分け 1 局」(得点 0.5、局数 1)を足した 、 を使う(例:Pgx の基準モデルは深さ 6 以上の Edax に 32 局全敗し、足した後の得点の割合は )。 として、次の量が最大になる を求めた。
引き分けを 0.5 勝として扱うので、式(63) は厳密な尤度ではなく、それに準じる量である。式(63) を で微分すると、 が出る記録についての次の和になる。
詳しくはこちら(式(64) の導出)
記録 について とおくと、式(61) は で、 である。、 なので、式(63) の記録 の項を で微分すると、
になり、 で微分すると符号が逆になる。これを が出る記録すべてで足すと 式(64) になる。
式(64) の大かっこの中は、 が実際に取った得点と、式(61) から予測した得点の差である。この向きに を動かすことを 4,000 回くり返し、そのつど Pgx の基準モデルが 1000 になるように全員をずらした(elo_all.py)。終わった時点で、大かっこの中の大きさは全員で 以下(得点の単位)で、8,000 回に増やしても値は変わらなかった。
この求め方は、全対局をまとめて 式(63) を最大にするので、対局の順番によらない。チェスなどで使われる、1 局ごとに値を少しずつ更新する方式では、結果が対局の順番に依存し、値が落ち着くまで多くの対局が要る。式(63) が使うのは各記録の局数と得点だけなので、同じ組の対局をもう一度くり返すことは、記録ごとに足す 0.5 勝の分を除けば、その組の局数を増やすことと同じである。そのため、総当たりを何周もくり返す必要は無く、全員が対局の組を通じて 1 つにつながっていれば値が決まる。ただし、値の確かさは各組の局数で決まり、局数の少ない組だけでつながる打ち手(例:Edax の各深さは 32 局ずつの組でつながる)は、下の区間が広い。
95% 区間は、各記録について、得点の割合 を勝つ確率として 局の勝敗を二項分布で引き直し、式(63) で を求め直すことを 200 回くり返した(ブートストラップ。1 回の当てはめは 1,500 回のくり返し)、その 2.5% 点と 97.5% 点である(elo_ci_raw.py。点の値は elo_all.json と同じ)。引き直すと引き分けは無くなるので、区間はわずかに広めに出る。区間は Pgx の基準モデルを 1000 に固定したうえでの値なので、Pgx の基準モデルとの差の揺れである。区間は対局の偶然の揺れだけを表し、式(61) が当てはまらないことによるずれは含まない。得点の割合が 0 か 1 の記録(例:Pgx の基準モデル対 深さ 6 以上の Edax)は引き直しても変わらないので、その記録の揺れも区間に入らない。
ページの元データ elo_all.json の区間は、引き直しに誤りがあるので使わなかった。elo_all.py は、0.5 勝を足した後の割合 で 局を引き、それを 局の記録として当てはめに渡すので、当てはめの中でさらに 0.5 勝と 1 局を足すと得点の割合が 1 を超える標本ができる。この誤りで、Pgx の基準モデルが全敗した深さ 6 以上の Edax の区間が下に偏っていた(例:深さ 10 は 2063 に対し 1706〜2078。この表の引き直しでは 1919〜2248)。
使った対局は次のとおり(打ち手 63、記録 494(異なる組は 417)、計 30.7 万局)。
- 学習の結果 の評価と総当たり(Colab の GPU)。
- 方策勾配法の MLP 20 個(勝ちたがる 15 個・負けたがる 5 個)と、手書きの規則 3 つの総当たり 253 組(各 512 局、手元の CPU)。負けたがる MLP も、勝った割合で数えた。
- MLP の学習時の評価(ランダムな相手・返す数が最多の相手・角を優先する相手と各 2,048 局)。
- Edax との対局(手元の CPU、各組 32 局):Pgx の基準モデルと Edax の深さの設定 1・2・3・4・6・8・10・12・16・21、隣り合う深さの Edax どうし(8 と 12 の組も含む)、AlphaZero 150 回・先読み 32 回と Edax の深さ 1・2・3・4・6、Pgx の基準モデルの先読み 8・32・100 回と、先読みなしの Pgx の基準モデル・Edax 深さ 2・4・AlphaZero 150 回・先読み 32 回。
「返す数が最多の相手」との対局(70 記録)は、まず除いて全員の値を決め、そのあとこの相手だけを、ほかの全員の値を固定して当てはめた(区間は出していない)。式(61) は、A が B に、B が C に強ければ A は C にも強いという並び方を前提にしているが、学習の結果 のとおり、この相手への勝率は強さの順に並ばない。例えば AlphaZero(先読みなし)は、反復 10 回(下の表で 706)から 150 回(997)へ強くなったのに、この相手への勝率は 86.7% から 67.8% に下がった。後から当てはめると、この相手の対局がほかの打ち手の値を動かさない。
式(61) で予測した勝率と、実際の得点の割合(0.5 勝を足した後)の差は、返す数が最多の相手を除く 424 記録の平均で 8.9 ポイントだった。差が大きいのは MLP どうしの組で、例えば MLP(混合で学習)・2000 回がランダムだけで学習した MLP・2000 回に取った得点の割合は、2 つの記録を合わせて 0.5 勝を足す前で 3.9%(768 局で 30 点)、予測は 45% だった。MLP どうしの記録を除くと平均 7.3 ポイント(233 記録)、Edax を含む記録だけでは 3.2 ポイント(31 記録)である。MLP どうしは強さの順に並ばない組が多いので、MLP の行の順位は参考にならない。
打ち手の出どころ
この節では、表に並ぶ打ち手を、どこから来たかで 5 つに分ける。表の「出どころ」の列はこの分け方である。
| 出どころ | 打ち手 |
|---|---|
| このページで学習 | 方策勾配法の MLP(勝ちたがる・負けたがる)、AlphaZero、AlphaGo 方式 |
| Pgx に付属の学習済み | Pgx の基準モデル(先読みなし、先読み 8・32・100 回) |
| 既製のプログラム(Edax) | Edax の深さの設定 1・2・3・4・6・8・10・12・16・21(オセロのドメイン知識。評価関数 eval.dat と αβ 探索) |
| 手書きの規則 | ランダムな相手、返す数が最多の相手、角を優先する相手 |
| 人間(換算) | 日本オセロ連盟・世界オセロ連盟の値を、下の 人間の値の換算 でこの尺度に直した値 |
Pgx の基準モデル
この節では、尺度の 1000 に置いた Pgx の基準モデルが何かを示す。Pgx(JAX で書かれたゲーム環境のライブラリ)が配る、オセロ用の学習済みネットワーク othello_v0 である。手元の重みのファイル(baselines/othello_v0.ckpt)の設定は、残差ブロック 6 個・128 チャンネル・前活性化の残差ブロック(resnet_v2: True)・出力 65 個(64 マスとパスの手の確率)で、学習するパラメータは 1,793,995 個(約 179 万。ファイルの値を数えた。BatchNorm の平均・分散のような、学習で求めない値は含まない)である。ほかに局面の見込み(手番側から見た値)を 1 つ出す。このページの AlphaZero は、残差ブロック 6 個・64 チャンネルで、学習するパラメータは 458,827 個(約 46 万。othello_net.py のネットワークを作って数えた。数え方は同じ)なので、Pgx の基準モデルの約 4 分の 1 である。
Pgx の論文によれば、基準モデルは、論文の AlphaZero の学習(Gumbel AlphaZero、1 手 32 回の探索、計算量の目安 の表の「Pgx の例」)の 100 回目の反復(約 2,600 万局面)のモデルである(原文: "we selected the 200-iteration (≈ 52M frames) model for 9x9 Go and the 100-iteration (≈ 26M frames) model for other environments" — Pgx 論文)。手元のファイルがこのモデルと同じかは確かめていない。論文は、基準モデルに 1 手 32 回の探索をさせた強さを 1000 としている(原文: "We adjusted the Elo rating to ensure that our baseline models had 1000 Elo. During the evaluation matches, the agents conducted 32 simulations for each move")。このページの 1000 は先読みなしの強さで、論文の 1000 とは違う。このページの尺度では、Pgx の基準モデルの強さは先読みなし 1000、先読み 8 回 1165、32 回 1320、100 回 1436 である。
人間の値の換算
この節では、人間のレーティングを、この節の尺度に直す方法を示す。人間の値は人間どうしの対局から求めた値なので、そのままでは AI の値と比べられない。次の 2 段階で直した。
(1) 日本の値から世界の値へ。 日本オセロ連盟のレーティングの一覧(2026-10-10 更新、1,655 人)と、世界オセロ連盟(World Othello Federation)の一覧(2026-10-20 に集計、公式の順位がある 1,782 人)の両方に載る 248 人(日本の一覧の名前をローマ字に直し(pykakasi を使用)、世界の一覧の日本の選手 865 人の名前と一致したもの)について、日本の値 から世界の値 への直線を最小二乗法で当てはめた(相関係数 0.93、直線からのずれの標準偏差 127)。248 人の日本の値は 541〜1666(中央値 1037)で、下の段位の表の中央値はすべてこの範囲に入る。日本の値が 541 より低い人や 1666 より高い人には、この直線が成り立つかは分からない。248 人の組はこのページには載せていない。
(2) 世界の値からこの尺度へ。 両方の尺度で強さが分かる打ち手を探し、OLIVAW の論文(2021)の対局を使った。OLIVAW は AlphaGo Zero の方式で学習したオセロの AI である(計算量の目安)。論文では、1 手に探索する局面を 1,000 個までにした OLIVAW(第 20 世代。論文の記号で O-1000。計算量の目安 の表の 100〜400 回は学習中の値で、これとは別)に対し、深さ 10 の Edax が 10 局の得点で 7 対 3(引き分けは 0.5)、元世界王者 Michele Borassi が 3 局で 2 勝 1 敗だった(原文: 図 6 の E10 の行、O-1000 の列 "7-3"、"In short, Borassi played against O-1000." "The final score was thus 2-1 against OLIVAW." — OLIVAW 論文)。論文には O-1000 と深さ 10 の Edax の 100 局の結果も図 5a にあるが、数値は本文に無く、図から読み取っていないので使っていない。この 2 つの得点の割合を 式(62) で差に直す。OLIVAW のこの尺度の値を 、深さ 10 の Edax を 、Borassi を とすると、
である(四捨五入)。式(67) の左の式から右の式を引くと が消え、 になる。(下の表の深さ 10 の Edax)を入れると で、Borassi の世界の値は 2350(2026-10-20 の世界オセロ連盟の一覧で 28 位)なので、世界の値からこの尺度へはこの差を引く。
計算した値は、ページの元データ human_ref.json の値(Borassi 2036.68、ずれ −313.32)と一致した。この換算は次を仮定している。どれも確かめていない。
- 世界の値が、式(61) と同じく、差 400 で勝つ確率が約 91% になる尺度であること。
- OLIVAW の論文の深さ 10 の Edax(当時の版。αβ 探索の深さを 10 に制限した Edax と書かれている。序盤は XOT と呼ばれる、約 1 万通りの一覧から乱数で選ぶ 8 手)と、このページの深さの設定 10 の Edax(版 4.7。空きマス 20 以下では終局まで読む。序盤の 4 手は乱数)が同じ強さであること。論文の「深さ 10」がこのページの深さの設定 10 と同じ意味かも確かめていない(論文の本文は図 5b について、深さ 10 の Edax が終局の 20 手前から深く読むと書いており、このページの設定 10 が空きマス 20 以下で読み切るのと合う)。
- Borassi の 2019 年の対局のときの強さが、2026-10-20 の世界の値 2350 に当たること。
- Edax と打ったときの O-1000(XOT の序盤 8 手、各 10 局)と、Borassi と打ったときの O-1000(通常の序盤、持ち時間 30 分)が同じ強さであること。
13 局だけにもとづくので、換算のずれは 1 標準偏差で 240 程度と見積もられる(下の折りたたみ。95% の幅ならその約 2 倍)。
詳しくはこちら(換算のずれの大きさ)
得点の割合 を 局から求めると、その標準誤差は である。式(62) の右辺を とおくと なので、 の小さな揺れに対する差の揺れは、標準誤差に を掛けた大きさで見積もれる(1 次の近似)。
式(69) に 、 を入れると 120、、 を入れると 213 で、2 つの対局は独立なので、差 26.8 の揺れは 程度(標準偏差)になる。ただし では得点の割合が 0 や 1 にもなりうるので、1 次の近似は粗く、この値は目安である。これに、深さ 10 の Edax の値そのものの区間(求め方 の引き直しで 1919〜2248)が加わる。
段位の意味
この節では、表に出てくる日本の段位が、どれくらいの成績を挙げた人に与えられるかを示す。段位は日本オセロ連盟が認定する制度で、世界オセロ連盟の制度ではない。段位は九段から初段、級位は 1 級から 7 級で、初段以上の人を有段者、級位を持つ人を級位者と呼ぶ(日本オセロ連盟段級位認定規程 第 1 条、有段者・級位者)。段位はレーティングでは決まらず、公認の大会の成績で決まる(規程第 2〜4 条)。昇段は、原則として今の段位から 2 段階までである(規程第 4 条)。規程には段位を下げる条文は無く、段位を失うのは連盟を除名されたときだけである(第 14 条)。
次の表の「何をした人か」は、Othello! JAPAN(オセロの情報サイト。日本オセロ連盟とは別の運営)の用語辞典の例で、各段位の頁にリンクした。辞典の本文には 2013〜2014 年ごろの内容が含まれる(例:全日本選手権を「2013年で41回」と書いている)ので、大会の例は今と違うことがある。辞典にある大会の名前は例で、ほかの大会でも条件を満たせば認定される。品川シーサイドオープンは、辞典によれば誰でも参加できる大会である(二段 の頁)。「人数」以降の列は、日本オセロ連盟のレーティングの一覧に載る人を段位ごとに分けた値で、「換算」は 式(66) と 式(68) でこの尺度に直した値(四捨五入)である。
| 段位 | 何をした人か(例) | 人数 | 日本の値の中央値 | 換算の中央値 | 換算の 10%〜90% |
|---|---|---|---|---|---|
| 九段 | 八段の人が、全日本選手権・名人戦・王座戦・世界選手権のどれかでさらに 2 回優勝(通算 5 回の優勝)。最高の段位(九段) | 8 | 1456 | 2171 | 1920〜2495 |
| 八段 | 七段の人が、全日本選手権・名人戦・王座戦・世界選手権のどれかでさらに 2 回優勝(通算 3 回の優勝)(八段) | 3 | 1514 | 2265 | 2181〜2401 |
| 七段 | 全日本選手権・名人戦・王座戦のどれかで優勝(七段。規程では世界選手権の優勝も) | 16 | 1402.5 | 2084 | 1872〜2296 |
| 六段 | 全日本選手権・名人戦・王座戦で準優勝か 3 位(六段) | 26 | 1328.5 | 1965 | 1626〜2160 |
| 五段 | メジャー大会で 8 位以内。五段以上を「高段者」と呼ぶことが多い(五段) | 54 | 1301 | 1920 | 1618〜2131 |
| 四段 | 地区名人戦や全日本選手権のブロック予選で優勝など。四段以上は特別に認められた大会でしか認定されない(四段) | 58 | 1243.5 | 1827 | 1619〜2087 |
| 三段 | 各ブロックで開かれるオープン大会(例:品川シーサイドオープン)で優勝など(三段) | 97 | 1159 | 1691 | 1456〜1915 |
| 二段 | 参加資格が 1 級〜三段の大会(りんかいチャレンジカップのインターミディエイト部門)で優勝、または品川シーサイドオープンで 6 戦 5 勝(二段) | 134 | 1075.5 | 1555 | 1351〜1770 |
| 初段 | 品川シーサイドオープンで 6 戦 4 勝、または品川シーサイドオープンやりんかいチャレンジカップの、級位者だけが出られるビギナー部門(ここでの級位者は段位を持たない人を指し、級を持たない人も含む。級位者)で 1 年に 2 回優勝。段位の中で最も下だが、級位者から見れば相当強い(初段) | 184 | 984 | 1407 | 1210〜1650 |
| 1 級 | ― | 141 | 914 | 1294 | 1111〜1509 |
| 2 級 | ― | 88 | 873.5 | 1229 | 1032〜1388 |
| 3 級 | ― | 76 | 865.5 | 1216 | 1040〜1370 |
| 4 級 | ― | 38 | 845.5 | 1183 | 1027〜1338 |
| 5 級 | ― | 22 | 836.5 | 1169 | 1019〜1273 |
| 6 級 | ― | 6 | 836.5 | 1169 | 904〜1238 |
| 7 級 | ― | 2 | 776.5 | 1072 | 980〜1163 |
| 段級位なし | 一覧に載っているが段級位を持たない人 | 702 | 861 | 1209 | 1129〜1310 |
辞典と規程(2026-04-01 改定)で違う所がある。六段は、規程では「五段の者がさらに 2 回五段に認定される資格を得たとき申請できる」(第 4 条 2)で、辞典の準優勝・3 位とは書き方が違う。辞典は、六段を取れる成績を 3 回収めても七段になれるよう規定が変わったと書いているが、今の規程の条文には見当たらない。
段位と、この一覧のレーティングは一致しない。表では、八段の中央値(1514)が九段(1456)より高く、10%〜90% の幅は、段位では八段(3 人なので参考にならない)を除いて、この尺度で 419〜575 ある(表の丸めた値の差)。理由は次のように推測する(確かめていない)。段位は過去に挙げた最も良い成績で決まり、規程に下げる条文が無いので、強かった時期の段位がそのまま残る。レーティングは対局の結果から計算する値なので、最近の対局で上下する。
このページの AI と比べると、このページで作った最強の AlphaZero 150 回・先読み 32 回(1338)は、初段の中央値(1407)と 1 級の中央値(1294)のあいだにある。初段は、上の辞典の例では「誰でも出られる大会で 6 戦 4 勝する人」である。ただし換算のずれは 1 標準偏差で 240 程度あり、1338 から ±240 の範囲(1098〜1578)には、7 級を除く級位から二段までの中央値が入る。そのため、どの段位に当たるかは決められない。また「段級位なし」の 702 人は、レーティングの一覧に載る(公認の大会に出た)人で、オセロを遊ぶ人全体ではない。
レーティングの表
この節では、AI と人間の値を 1 つの表に、レーティングの高い順に並べる。全 77 行のうち、次の 43 行を載せた:Edax の深さの設定の全部(10 行)、Pgx の基準モデルの先読み 0・8・32・100 回、AlphaZero の先読みなし・先読み 32 回の代表の時点(反復 10・40・80・150 回の先読み、10・150 回の先読みなし)、AlphaGo 方式の 3 つ、MLP の代表 3 つ(勝ちたがる MLP の 2 種類と負けたがる MLP の 2,000 回)、手書きの規則 3 つ、人間 14 行。残りを含む全行は下の折りたたみにある。「MLP(自己対戦で学習)」は 自己対戦の方策勾配法 の節の 2 群目(半分を過去の自分と打った MLP)である。区間は 求め方 の引き直しで求めた値である。順位は全 77 行の中の順位である。「元の値」は人間の換算前の値で、「世界」は世界オセロ連盟、「日本」は日本オセロ連盟の値である。人間の値は換算なので区間を出していない。世界の 50 位・100 位・中央値は、同順位(一覧で「T29」のように書かれる)の人も数えた 1,782 人の中の位置である(ページの元データ human_ref.json は同順位の人を落として 376 人で数えていたので、この 3 行はそれと値が違う)。
| 順位 | 打ち手 | 出どころ | レーティング | 95% 区間 | 元の値 |
|---|---|---|---|---|---|
| 1 | 世界1位・Keisuke FUKUCHI(日本でも1位) | 人間(世界の値から換算) | 2441 | 換算のため無し | 世界 2754 |
| 2 | Edax 深さ 21 | 既製のプログラム(Edax) | 2352 | 2103〜2596 | ― |
| 3 | Edax 深さ 16 | 既製のプログラム(Edax) | 2310 | 2111〜2556 | ― |
| 4 | 日本 九段の中央値(8 人) | 人間(日本の値から換算) | 2171 | 換算のため無し | 日本 1456 |
| 5 | Edax 深さ 12 | 既製のプログラム(Edax) | 2125 | 1973〜2311 | ― |
| 6 | 世界 10位の選手 | 人間(世界の値から換算) | 2125 | 換算のため無し | 世界 2438 |
| 7 | 日本 七段の中央値(16 人) | 人間(日本の値から換算) | 2084 | 換算のため無し | 日本 1402.5 |
| 8 | Edax 深さ 10 | 既製のプログラム(Edax) | 2063 | 1919〜2248 | ― |
| 9 | 元世界王者 Borassi(換算の基準に使った) | 人間(世界の値から換算) | 2037 | 換算のため無し | 世界 2350 |
| 10 | 世界 50位の選手 | 人間(世界の値から換算) | 2003 | 換算のため無し | 世界 2316 |
| 11 | 世界 100位の選手(同順位あり) | 人間(世界の値から換算) | 1929 | 換算のため無し | 世界 2242 |
| 12 | 日本 五段の中央値(54 人) | 人間(日本の値から換算) | 1920 | 換算のため無し | 日本 1301 |
| 13 | Edax 深さ 8 | 既製のプログラム(Edax) | 1907 | 1785〜2059 | ― |
| 14 | Edax 深さ 6 | 既製のプログラム(Edax) | 1766 | 1681〜1868 | ― |
| 15 | 日本 三段の中央値(97 人) | 人間(日本の値から換算) | 1691 | 換算のため無し | 日本 1159 |
| 16 | Edax 深さ 4 | 既製のプログラム(Edax) | 1614 | 1554〜1688 | ― |
| 17 | Pgx の基準モデル・先読み 100 回 | Pgx に付属の学習済み | 1436 | 1356〜1506 | ― |
| 18 | Edax 深さ 3 | 既製のプログラム(Edax) | 1417 | 1352〜1498 | ― |
| 19 | 世界 中央値(891・892 番目。一覧では T890)の選手 | 人間(世界の値から換算) | 1410 | 換算のため無し | 世界 1723 |
| 20 | 日本 初段の中央値(184 人) | 人間(日本の値から換算) | 1407 | 換算のため無し | 日本 984 |
| 21 | AlphaZero 反復 150 回・先読み 32 回 | このページで学習 | 1338 | 1313〜1364 | ― |
| 22 | Pgx の基準モデル・先読み 32 回 | Pgx に付属の学習済み | 1320 | 1259〜1393 | ― |
| 24 | 日本 1 級の中央値(141 人) | 人間(日本の値から換算) | 1294 | 換算のため無し | 日本 914 |
| 26 | AlphaGo 方式・先読み 32 回 | このページで学習 | 1226 | 1204〜1246 | ― |
| 27 | Edax 深さ 2 | 既製のプログラム(Edax) | 1217 | 1165〜1283 | ― |
| 28 | 日本 3 級の中央値(76 人) | 人間(日本の値から換算) | 1216 | 換算のため無し | 日本 865.5 |
| 30 | 日本 段級位なしの中央値(702 人) | 人間(日本の値から換算) | 1209 | 換算のため無し | 日本 861 |
| 31 | AlphaZero 反復 80 回・先読み 32 回 | このページで学習 | 1197 | 1150〜1249 | ― |
| 32 | Pgx の基準モデル・先読み 8 回 | Pgx に付属の学習済み | 1165 | 1093〜1242 | ― |
| 33 | AlphaZero 反復 40 回・先読み 32 回 | このページで学習 | 1097 | 1054〜1141 | ― |
| 34 | Edax 深さ 1 | 既製のプログラム(Edax) | 1010 | 916〜1102 | ― |
| 35 | Pgx の基準モデル・先読みなし(基準) | Pgx に付属の学習済み | 1000 | 固定 | ― |
| 36 | AlphaGo 方式 段階1・24000 回(先読みなし) | このページで学習 | 998 | 981〜1015 | ― |
| 37 | AlphaZero 反復 150 回・先読みなし | このページで学習 | 997 | 981〜1012 | ― |
| 38 | AlphaGo 方式 段階2・1000 回(先読みなし) | このページで学習 | 993 | 978〜1012 | ― |
| 44 | AlphaZero 反復 10 回・先読み 32 回 | このページで学習 | 845 | 814〜871 | ― |
| 47 | AlphaZero 反復 10 回・先読みなし | このページで学習 | 706 | 684〜727 | ― |
| 49 | MLP(ランダムだけで学習)・2000 回 | このページで学習 | 558 | 545〜571 | ― |
| 54 | MLP(混合で学習)・2000 回 | このページで学習 | 525 | 512〜538 | ― |
| 58 | 角を優先する相手 | 手書きの規則 | 512 | 499〜526 | ― |
| 68 | 返す数が最多の相手(後から当てはめ) | 手書きの規則 | 235 | ― | ― |
| 72 | ランダムな相手 | 手書きの規則 | 96 | 83〜111 | ― |
| 77 | 負けたがる MLP(2,000 回) | このページで学習 | -381 | -399〜-360 | ― |
全 77 行のレーティング
| 順位 | 打ち手 | 出どころ | レーティング | 95% 区間 | 元の値 |
|---|---|---|---|---|---|
| 1 | 世界1位・Keisuke FUKUCHI(日本でも1位) | 人間(世界の値から換算) | 2441 | 換算のため無し | 世界 2754 |
| 2 | Edax 深さ 21 | 既製のプログラム(Edax) | 2352 | 2103〜2596 | ― |
| 3 | Edax 深さ 16 | 既製のプログラム(Edax) | 2310 | 2111〜2556 | ― |
| 4 | 日本 九段の中央値(8 人) | 人間(日本の値から換算) | 2171 | 換算のため無し | 日本 1456 |
| 5 | Edax 深さ 12 | 既製のプログラム(Edax) | 2125 | 1973〜2311 | ― |
| 6 | 世界 10位の選手 | 人間(世界の値から換算) | 2125 | 換算のため無し | 世界 2438 |
| 7 | 日本 七段の中央値(16 人) | 人間(日本の値から換算) | 2084 | 換算のため無し | 日本 1402.5 |
| 8 | Edax 深さ 10 | 既製のプログラム(Edax) | 2063 | 1919〜2248 | ― |
| 9 | 元世界王者 Borassi(換算の基準に使った) | 人間(世界の値から換算) | 2037 | 換算のため無し | 世界 2350 |
| 10 | 世界 50位の選手 | 人間(世界の値から換算) | 2003 | 換算のため無し | 世界 2316 |
| 11 | 世界 100位の選手(同順位あり) | 人間(世界の値から換算) | 1929 | 換算のため無し | 世界 2242 |
| 12 | 日本 五段の中央値(54 人) | 人間(日本の値から換算) | 1920 | 換算のため無し | 日本 1301 |
| 13 | Edax 深さ 8 | 既製のプログラム(Edax) | 1907 | 1785〜2059 | ― |
| 14 | Edax 深さ 6 | 既製のプログラム(Edax) | 1766 | 1681〜1868 | ― |
| 15 | 日本 三段の中央値(97 人) | 人間(日本の値から換算) | 1691 | 換算のため無し | 日本 1159 |
| 16 | Edax 深さ 4 | 既製のプログラム(Edax) | 1614 | 1554〜1688 | ― |
| 17 | Pgx の基準モデル・先読み 100 回 | Pgx に付属の学習済み | 1436 | 1356〜1506 | ― |
| 18 | Edax 深さ 3 | 既製のプログラム(Edax) | 1417 | 1352〜1498 | ― |
| 19 | 世界 中央値(891・892 番目。一覧では T890)の選手 | 人間(世界の値から換算) | 1410 | 換算のため無し | 世界 1723 |
| 20 | 日本 初段の中央値(184 人) | 人間(日本の値から換算) | 1407 | 換算のため無し | 日本 984 |
| 21 | AlphaZero 反復 150 回・先読み 32 回 | このページで学習 | 1338 | 1313〜1364 | ― |
| 22 | Pgx の基準モデル・先読み 32 回 | Pgx に付属の学習済み | 1320 | 1259〜1393 | ― |
| 23 | AlphaZero 反復 120 回・先読み 32 回 | このページで学習 | 1301 | 1248〜1369 | ― |
| 24 | 日本 1 級の中央値(141 人) | 人間(日本の値から換算) | 1294 | 換算のため無し | 日本 914 |
| 25 | AlphaZero 反復 100 回・先読み 32 回 | このページで学習 | 1287 | 1233〜1350 | ― |
| 26 | AlphaGo 方式・先読み 32 回 | このページで学習 | 1226 | 1204〜1246 | ― |
| 27 | Edax 深さ 2 | 既製のプログラム(Edax) | 1217 | 1165〜1283 | ― |
| 28 | 日本 3 級の中央値(76 人) | 人間(日本の値から換算) | 1216 | 換算のため無し | 日本 865.5 |
| 29 | AlphaZero 反復 60 回・先読み 32 回 | このページで学習 | 1210 | 1160〜1257 | ― |
| 30 | 日本 段級位なしの中央値(702 人) | 人間(日本の値から換算) | 1209 | 換算のため無し | 日本 861 |
| 31 | AlphaZero 反復 80 回・先読み 32 回 | このページで学習 | 1197 | 1150〜1249 | ― |
| 32 | Pgx の基準モデル・先読み 8 回 | Pgx に付属の学習済み | 1165 | 1093〜1242 | ― |
| 33 | AlphaZero 反復 40 回・先読み 32 回 | このページで学習 | 1097 | 1054〜1141 | ― |
| 34 | Edax 深さ 1 | 既製のプログラム(Edax) | 1010 | 916〜1102 | ― |
| 35 | Pgx の基準モデル・先読みなし(基準) | Pgx に付属の学習済み | 1000 | 固定 | ― |
| 36 | AlphaGo 方式 段階1・24000 回(先読みなし) | このページで学習 | 998 | 981〜1015 | ― |
| 37 | AlphaZero 反復 150 回・先読みなし | このページで学習 | 997 | 981〜1012 | ― |
| 38 | AlphaGo 方式 段階2・1000 回(先読みなし) | このページで学習 | 993 | 978〜1012 | ― |
| 39 | AlphaZero 反復 100 回・先読みなし | このページで学習 | 985 | 960〜1007 | ― |
| 40 | AlphaZero 反復 20 回・先読み 32 回 | このページで学習 | 978 | 946〜1012 | ― |
| 41 | AlphaZero 反復 120 回・先読みなし | このページで学習 | 968 | 948〜994 | ― |
| 42 | AlphaZero 反復 80 回・先読みなし | このページで学習 | 924 | 895〜948 | ― |
| 43 | AlphaZero 反復 60 回・先読みなし | このページで学習 | 904 | 878〜933 | ― |
| 44 | AlphaZero 反復 10 回・先読み 32 回 | このページで学習 | 845 | 814〜871 | ― |
| 45 | AlphaZero 反復 40 回・先読みなし | このページで学習 | 811 | 785〜837 | ― |
| 46 | AlphaZero 反復 20 回・先読みなし | このページで学習 | 730 | 707〜754 | ― |
| 47 | AlphaZero 反復 10 回・先読みなし | このページで学習 | 706 | 684〜727 | ― |
| 48 | AlphaZero 反復 5 回・先読み 32 回 | このページで学習 | 699 | 669〜728 | ― |
| 49 | MLP(ランダムだけで学習)・2000 回 | このページで学習 | 558 | 545〜571 | ― |
| 50 | MLP(自己対戦で学習)・250 回 | このページで学習 | 548 | 534〜561 | ― |
| 51 | AlphaGo 方式 段階1・1000 回(先読みなし) | このページで学習 | 536 | 506〜563 | ― |
| 52 | AlphaZero 反復 5 回・先読みなし | このページで学習 | 533 | 510〜554 | ― |
| 53 | MLP(自己対戦で学習)・1000 回 | このページで学習 | 526 | 512〜539 | ― |
| 54 | MLP(混合で学習)・2000 回 | このページで学習 | 525 | 512〜538 | ― |
| 55 | MLP(混合で学習)・500 回 | このページで学習 | 518 | 506〜532 | ― |
| 56 | MLP(混合で学習)・73 回 | このページで学習 | 518 | 503〜531 | ― |
| 57 | MLP(自己対戦で学習)・73 回 | このページで学習 | 516 | 502〜530 | ― |
| 58 | 角を優先する相手 | 手書きの規則 | 512 | 499〜526 | ― |
| 59 | MLP(自己対戦で学習)・500 回 | このページで学習 | 503 | 488〜518 | ― |
| 60 | MLP(混合で学習)・250 回 | このページで学習 | 499 | 485〜513 | ― |
| 61 | MLP(ランダムだけで学習)・1000 回 | このページで学習 | 463 | 451〜477 | ― |
| 62 | MLP(ランダムだけで学習)・250 回 | このページで学習 | 446 | 433〜462 | ― |
| 63 | MLP(ランダムだけで学習)・500 回 | このページで学習 | 443 | 431〜456 | ― |
| 64 | MLP(混合で学習)・1000 回 | このページで学習 | 440 | 427〜455 | ― |
| 65 | MLP(自己対戦で学習)・2000 回 | このページで学習 | 382 | 368〜395 | ― |
| 66 | MLP(ランダムだけで学習)・73 回 | このページで学習 | 376 | 362〜389 | ― |
| 67 | AlphaZero 反復 1 回・先読み 32 回 | このページで学習 | 363 | 322〜404 | ― |
| 68 | 返す数が最多の相手(後から当てはめ) | 手書きの規則 | 235 | ― | ― |
| 69 | AlphaZero 反復 0 回・先読み 32 回 | このページで学習 | 199 | 157〜238 | ― |
| 70 | AlphaZero 反復 1 回・先読みなし | このページで学習 | 136 | 104〜163 | ― |
| 71 | AlphaZero 反復 0 回・先読みなし | このページで学習 | 133 | 104〜168 | ― |
| 72 | ランダムな相手 | 手書きの規則 | 96 | 83〜111 | ― |
| 73 | 負けたがる MLP(73 回) | このページで学習 | -287 | -303〜-268 | ― |
| 74 | 負けたがる MLP(250 回) | このページで学習 | -307 | -324〜-290 | ― |
| 75 | 負けたがる MLP(1,000 回) | このページで学習 | -312 | -329〜-292 | ― |
| 76 | 負けたがる MLP(500 回) | このページで学習 | -320 | -337〜-303 | ― |
| 77 | 負けたがる MLP(2,000 回) | このページで学習 | -381 | -399〜-360 | ― |
1000 はどれくらいか
この節では、尺度の 1000(Pgx の基準モデル・先読みなし)がどれくらいの強さかを、ほかの打ち手との勝つ確率で示す。図2 は 式(61) の曲線に、主な打ち手の位置を点で示したものである。
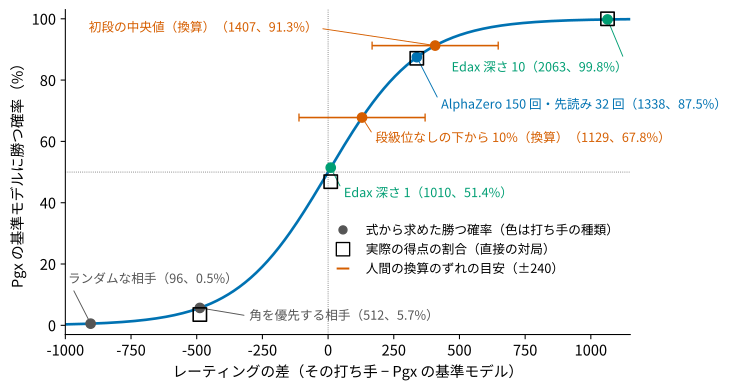
図2 横軸は、各打ち手のレーティングから Pgx の基準モデルの 1000 を引いた差、縦軸はその打ち手が Pgx の基準モデルに勝つ確率。丸は 式(61) で求めた確率で、色は打ち手の出どころ(青はこのページで学習、緑は Edax、橙は人間、灰は手書きの規則)、位置は上の表の値(人間は換算した値。「段級位なしの下から 10%」は日本の値 812 を換算した値)。括弧の中はレーティングと、式で求めた勝つ確率。人間の点の横棒は、換算のずれの目安(1 標準偏差で ±240)。白抜きの四角は、その打ち手が Pgx の基準モデルと直接打って取った得点の割合(引き分けは 0.5。角を優先する相手 256 局で 3.5%、深さ 1 の Edax 32 局で 46.9%、AlphaZero 150 回・先読み 32 回 256 局で 87.1%、深さ 10 の Edax 32 局で 100%)。四角の記録はレーティングを求めるのにも使ったので、丸と四角が近いことは式の確かめにはならない(特に深さ 1 の Edax は記録が 3 つしかないので、この記録の影響が大きい)。差が ±400 を超えると確率は 9% 未満か 91% 超になり、曲線がほぼ平らになるので、そこより先の違いは数十局の勝ち負けでは見分けにくい。
分かることは次のとおり。
- 事実(対局から):Pgx の基準モデルと深さ 1 の Edax(1010)は区別できない。直接の対局では、Pgx の基準モデルが 32 局で得点の割合 53.1% で、32 局では標準誤差が 9 ポイント程度ある。
- 式からの計算:角を優先する相手(512)とは差が 488 で、式(61) では Pgx の基準モデルが 94.3% 勝つ(直接の対局では得点の割合 96.5%)。ランダムな相手(96)には 99.5% 勝つ。
- 推測(換算から):日本オセロ連盟の一覧で段級位なしの人の下から 10%(日本の値 812)は、換算で 1129 である。1000 との差 129 は換算のずれ(1 標準偏差で 240 程度)より小さいので、1000 と区別できない。初段の中央値(1407)は、1000 より 1.7 標準偏差ほど上である。
- 未確認:オセロの大会に出ない人(一覧に載らない人)と、このページの AI は対局させていない。そういう人が 1000 より上か下かは分からない。
結論と、ほかの AI との比較
この節では、表と換算から言えることをまとめ、表に無い AI(Egaroucid)と、オセロが解かれた結果を並べる。
- このページで作った最も強い打ち手は、AlphaZero 150 回・先読み 32 回(1338、区間 1313〜1364)である。人間の換算では、日本の初段の中央値(1407)と 1 級の中央値(1294)のあいだにある。換算のずれ(1 標準偏差で 240 程度)を考えると、どの段位に当たるかは決められない。
- 深さ 10 の Edax(2063)は、日本の七段の中央値(2084)や世界 10 位(2125)と同じ程度に並ぶ。ただし世界の値からの換算は、OLIVAW の論文で深さ 10 の Edax と元世界王者 Borassi(2026-10-20 の一覧で世界 28 位)がほぼ同じ強さだったことを起点に作ったので、これは独立に確かめた比較ではなく、その論文の対局の結果を言いかえたものである。深さ 21 の Edax(2352)は、表では世界 1 位の Keisuke FUKUCHI(福地啓介。世界 2754、換算 2441)に次ぐ。換算のずれが大きいので、深さ 10 以上の Edax と上位の人間の順序は決められない。
- 世界の上位 10 人は、全員が日本の選手である(2026-10-20 の世界オセロ連盟の一覧。同順位を含めて 100 位以内の 102 人のうち、日本の選手は 76 人)。
- 表に無い強い AI として Egaroucid がある(作者のサイトのトップページは「世界最強レベルAI搭載 オセロ研究支援アプリ」と書いている。Egaroucid)。Egaroucid 7.8.0 の公開ベンチマークでは、Egaroucid と Edax 4.6 を同じレベル 21(Edax ではこのページの深さの設定にあたると考えられるが、ベンチマークのページには Edax への指定のしかたが書かれていないので確かめていない)で、XOT の序盤(8 手)から先手・後手を 1 回ずつ持つ 2 局を 1 組とし、2 局で取った石の数の合計が多い方を勝ちとして 100 組打たせた。Egaroucid の勝ち 51 組・引き分け 20 組・Edax の勝ち 29 組で、勝ちの割合は だった(「Edax 4.6との対戦」の表。定石の本は双方使わない)。式(62) で差に直すと で、深さ 21 の Edax(2352.5)に足すと、レベル 21 の Egaroucid は約 2430 になる。世界 1 位の人間の換算(2441)と 11 しか違わず、換算のずれ(1 標準偏差で 240 程度)や、元にした深さ 21 の Edax の区間(2103〜2596)よりずっと小さいので、どちらが強いかは言えない。この見積もりは、2 局 1 組の勝ち負けを 式(61) の 1 局と同じに扱い、Edax 4.6 のレベル 21 とこのページの深さ 21 の Edax(4.7)を同じ強さとみなしている(確かめていない)。2 局の石の合計で勝ちを決めると、1 局ずつ数えるより強い側の勝ちの割合が大きく出ると考えられるので、77.7 は大きめに出ている向きである(推測)。また、レベル 21 より深く読ませた Egaroucid の強さではない。
- オセロは、初期局面から双方が最善を尽くすと引き分けになることが、2023 年に計算で示された(弱解決。Takizawa "Othello is Solved")。最善の打ち手は存在するが、この表の尺度での値は求めていない。
αβ 探索と AlphaZero の方式のどちらが強いか
この節では、レーティング(AI と人間) の結果を受けて、「オセロは先を読みやすいので、AlphaZero の方式を使わない方が強い、という構造になっているのか」という問いに、分かっていることと分かっていないことを分けて答える。先に答えを書く。今の最も強い部類のオセロのプログラム(Edax・Egaroucid)は、どちらも αβ 探索の系統と、人が選んだ形の点数表(評価関数)でできていて、オセロにはこの組み合わせが向く理由が 4 つある。ただし、AlphaZero の方式が本質的に弱いことを示した比較は無く、このページのデータからもそうは言えない。なお、オセロは初期局面から全部を読めるわけではない。初期局面からの読み切り(弱解決、結論と、ほかの AI との比較)は 2023 年に大きな計算で行われたもので、対局中に全部を読めるのは終盤だけである。
αβ 探索と形の点数表が向く理由
この節では、オセロで αβ 探索と形の点数表の組み合わせが強い理由を 4 つ示す。
- 打てる手が少ない。 乱数で打った 2,000 局(手元で計算。2026-10-21 に別の乱数で計算し直しても平均 8.51)では、打てる手の数は 1 手番あたり平均 8.5、21〜40 手目では約 11〜12 だった。Egaroucid の解説も「オセロに関して言えば合法手は対局全体を通して10手前後」と書いている(Egaroucid の技術解説「合法手数」)。囲碁は約 250 である(原文: "Go (b ≈ 250, d ≈ 150)" — AlphaGo 論文)。αβ 探索 の、良い手から順に読めた場合の末端の局面の数 に深さ を入れると、 で 199,999 個、 で約 個で、約 1,000 万倍違う。
- 評価が速い。 式(56) は点数表を 46 回引いて足すだけである。2026-10-21 に手元の Core i9-11900K の 1 スレッドで Edax(
-n 1)を動かすと、10〜22 手を乱数で打った 10 局面を深さの設定 10 で読んだときは毎秒約 2,060 万局面(Edax の表示で 1.624 秒に 3,350 万局面)、FFO の 20〜39 番(空きマス 6〜26 の終盤 20 問。既定の深さの設定 21 で実行し、最後の 1 問だけ ProbCut 付き)を読み切ったときは毎秒約 4,580 万局面だった(Edax が表示する数で、末端で評価した局面のほか、途中の局面や手の並べ替えのために調べた局面も含む)。同じ CPU の 1 コアで、このページの AlphaZero のネットワーク(JAX)は毎秒約 1,500 局面を評価した(1 局面ずつでも 256 局面ずつでも同じ程度)。中盤の値で比べると、Edax が調べる局面の数と、ネットワークが評価する局面の数の比で、約 1.4 万倍違う(読み切りでは末端で評価関数の値を使わないので、この比には使わない)。 - 終盤を読み切れる。 このページの深さの設定 21 の Edax は、空きマスが 30 以下になると終局まで読み、31〜33 でも最善と見込む手順に限って終局まで読む(このページの対局での Edax の条件)。Egaroucid が学習データを作るのに使った強さ(レベル 11)も「終盤25手読み切り」である(Egaroucid の技術解説「中盤以降の学習データの作り方」)。ProbCut を使わずに読み切る範囲(深さの設定 21 では空きマス 24 以下)では、評価関数の誤差は結果に入らない。
- 形の点数表で十分正確な評価が作れる。 Egaroucid の作者は、Logistello(1997 年に人間に勝ったオセロのプログラム。同じ解説による)の論文(Buro, 1997・1999)でパターンを使った評価関数が提案されてから、オセロでは高い精度の評価関数が作れるようになったので、αβ 探索の系統が向いていると書いている(Egaroucid の技術解説「評価関数の精度」)。ただし同じ作者は、オセロで αβ 探索の系統とモンテカルロ木探索の系統のどちらが良いかは簡単には結論できないとも書き、αβ 探索の系統が向く理由に、オセロが石の差を最大にするゲームであることも挙げている(同「探索アルゴリズムの選定」「スコアを最大化するゲームである点」)。同じ解説では、小さなニューラルネットワーク(入力 128、中間 32 が 2 層)を評価関数にした実験で、学習データに対する最終の石の差の予測の平均絶対誤差が 5.4 石で、パターンの評価の 3.5 石に届かなかったと報告している(同「NNUE評価関数」)。
AlphaZero の方式が弱いとは言えない理由
この節では、上の 4 つがあっても、AlphaZero の方式が本質的に弱いとは言えない理由を示す。
- このページの AlphaZero は小さく、学習も短い。 ネットワークは学習するパラメータ 458,827 個(Pgx の基準モデルの約 4 分の 1)、学習は L4 1 台で 171.6 分・自己対戦 61.5 万局である(学習の結果)。この規模の結果から、方式の限界は言えない。
- OLIVAW は、少ない学習で深さ 10 の Edax に近づいた。 OLIVAW は AlphaGo Zero の方式で、無料の Colab で約 5 万局の自己対戦から学習した(計算量の目安)。1 手に探索する局面を 1,000 個までにした OLIVAW は、元世界王者 Borassi に 1 勝 2 敗、深さ 10 の Edax には 10 局の得点で 3 対 7 だった。1 万個までにした OLIVAW(論文の O-10T)は、深さ 10 の Edax と 4.5 対 5.5 でほぼ互角で、8 者の総当たりでは 1 位だった(OLIVAW 論文 の図 6・表 I)。表 I では、深さ 10 の Edax が 1 手に調べた局面の数の最大は平均 で、O-10T()の約 830 倍である。ただしこれは調べた局面の数の比で、1 局面の計算はネットワークのほうがずっと重い(上の 2)ので、1 手あたりの計算の量は OLIVAW のほうが多い可能性がある(ネットワークの大きさが違うので、計算の量そのものは比べていない)。どちらも 10 局ずつなので、強さの差の大きさは決められない。
- 囲碁で AlphaGo の方式が使われた理由は、オセロには当てはまらない。 囲碁は打てる手が約 250 と多く(上の 1)、Egaroucid の解説によれば囲碁では評価関数が作りにくかったので、αβ 探索の系統が向かなかった(Egaroucid の技術解説「評価関数の精度」「合法手数」。原典は確かめていない)。オセロで αβ 探索の系統が使われ続けているのは、上の 1〜4 の条件がそろっているからで、AlphaZero の方式がオセロで働かないからではない、と推測する(確かめていない)。反対の向きの材料もある。Egaroucid の作者は、オセロ AI のコンテスト(CodinGame)で自分の実装ではモンテカルロ木探索があまり強くならなかったと書き(ただし自分の実装力の問題である説が濃厚とも書いている)、モンテカルロ木探索の系統は石の差のようなスコアを最大にするゲームが経験的に苦手と言われる、とも書いている(同時に、2024 年にモンテカルロ木探索でスコアを最大にする手法が提案され、非常によくできているとも書いている。Egaroucid の技術解説「双方のアルゴリズムで実験してみた結果」「スコアを最大化するゲームである点」)。
- 大きな計算で学習した AlphaZero の方式のオセロ AI と、Edax・Egaroucid を同じ条件で比べた結果は、このページでは見つけていない(未確認)。
Egaroucid の評価関数が学んだもの
この節では、Egaroucid の評価関数が何から学んだかを、作者の技術解説(Egaroucid の技術解説、2025-11-29 更新と書かれた版を 2026-10-21 に読んだ)で示す。
- 形式:Edax と同じく、Logistello で提案されたパターンの評価(形ごとの点数表の和)を元にし、手番側の石の数を特徴量に加えた。Egaroucid 7.7.0 では形を回転・裏返しした 64 個の特徴量を使い、評価関数は 1 手ごとに 60 組に分けている(「評価関数のモデル」「石評価パターン」「その他の特徴量」)。探索中にニューラルネットワークの計算はしない(解説には、点数表を小さなニューラルネットワークから起動時に作り直す方法もあるが、これも探索中に使うものではない。「深層学習」)。小さなニューラルネットワーク(NNUE)は試したが、上のとおり精度がパターンの評価に届かなかった。
- 学習データ:Egaroucid の過去の版どうしの自己対戦(レベル 11、序盤のいろいろな手数を乱数で打ってから対局)で、各局面の正解を対局の最終の石の差とした。序盤 11 手までは、現れうる局面(約 2,000 万)を全部並べ、Egaroucid 7.4.0 のレベル 17 で読んだ値を正解にした。合計 18 億局面で、Adam で点数表を当てはめた(解説の「評価関数のモデル」の値。同じ解説の「深層学習」には 32 億局面以上とあり、どちらが今の版の値かは確かめていない)(「評価関数の学習データ」「評価関数のモデル」「評価関数の最適化」)。
- 探索:αβ 探索の系統の Negascout 法を使う(「探索アルゴリズムの選定」)。
つまり Egaroucid は、評価関数の形(どのマスの組を見るか)は人が選び、点数は自分の対局から機械学習で決め、探索は αβ 系統、という作りである。第4章の負けたがる AI も、目指す向きは逆だが、同じ考え方(形を人が選び、点数表を自己対戦の結果に当てはめる)で作った。2025-11-29 更新の解説によれば、人の棋譜ではなく自己対戦で学ぶ点は AlphaZero と同じだが、ネットワークとモンテカルロ木探索は使っていない。
負ける強さのレーティング
この節は、勝つ強さとは別の尺度の話なので、勝つ強さについての節を終えた後に置く。この節では、第4章の 負けたがる AI(Edax にならった作り) の総当たり(16 人・120 組・各 100 局、計 12,000 局)から、式(61) と同じ形の尺度で「負ける強さ」を求めた値を示す。勝ち負けは「終局時に石が少ない方が勝ち」で数え、ランダムな相手を 1000 に固定した。求め方は 求め方 と同じく、各組に引き分け 1 局を足して 式(63) を最大にした(league.py の fit、5,000 回のくり返し)。区間は求めていない。上の レーティングの表(勝つ強さ、Pgx の基準モデルを 1000)とは別の尺度で、数を比べることはできない。
| 打ち手 | 負ける強さのレーティング |
|---|---|
| 世代 5・深さ 8・読み切り 20 | 2961 |
| 世代 5・深さ 6・読み切り 18 | 2756 |
| 世代 5・深さ 4 | 2451 |
| 世代 3・深さ 4 | 2439 |
| 世代 4・深さ 4 | 2431 |
| 世代 2・深さ 4 | 2369 |
| 世代 1・深さ 4 | 2124 |
| 世代 0・深さ 4 | 1827 |
| 負けたがる MLP(2,000 回) | 1454 |
| 負けたがる MLP(73 回) | 1381 |
| 角を避ける相手 | 1312 |
| 点数表をすべて 0 にした深さ 4 | 1137 |
| 返す数が最少の相手 | 1072 |
| ランダムな相手(基準) | 1000 |
| 返す数が最多の相手 | 958 |
| 角を優先する相手 | 781 |
(league.log の末尾。四捨五入した値)
世代 0 から 2 までで 542 上がり(1827 → 2369)、世代 2〜5 は 2369〜2451 の 82 の幅に収まった。1 組 100 局では、勝率 50% 付近の標準誤差は で、式(69) と同じ 1 次の近似(傾き )で差に直すと約 35 になる。そのうえ、乱数を使わない打ち手どうしの組では、序盤の重なりで異なる対局は 1 組 88 局以下なので(第4章の 結果)、実際の揺れはこれより大きい。直接の対局では、世代 2 は世代 3・4・5 のどれにも負け越した(世代 2 の得点の割合は 0.37・0.42・0.34)。世代 3・4・5 どうしの得点の割合は、3 対 4 が 0.55、3 対 5 が 0.40、4 対 5 が 0.50 で、式(61) で予想される値(3 対 4 は 0.51、3 対 5 は 0.48、4 対 5 は 0.47)との差は、標準誤差 0.05 の 2 倍以内である。世代 3・4・5 の順位は区別できない。同じ世代 5 の点数表で、深く読み早く読み切る打ち手ほど 2451 → 2756 → 2961 と高かった。ただし、負けたがる AI の 8 人(世代 0〜5 の深さ 4 と、世代 5 の深さ 6・8)と、それ以外の 8 人の組 64 組のうち 61 組は、相手の勝ちが 0 局だった(うち 2 組は引き分けが 1 局)。こうした組では、差の大きさは足した引き分け 1 局でほぼ決まる(求め方)。そのため、上位と下位の差(例えば世代 5・深さ 8・読み切り 20 とランダムな相手の 1961)の大きさは確かでない。順位が確かなのは、勝ち負けが分かれた組でつながる打ち手どうしである。当てはめのくり返しを 5,000 回から 50,000 回に増やしても、値は変わらなかった。
第5章の確かめ問題
問5-1 式(61) で、レーティングの差が 300 のとき強い側が勝つ確率を求めよ。また、ある組で強い側が 80% 勝ったとき、式(62) で差を求めよ。
問5-2 レーティングの表 の AlphaZero 反復 150 回・先読み 32 回(1338)と Edax 深さ 4(1614)について、式(61) で AlphaZero が取る得点の割合を予想せよ。実際の対局(32 局)では、AlphaZero は 3 勝 2 分け 27 敗(引き分けを 0.5 勝として得点 4)だった。予想と実際の差は、32 局の偶然の揺れで説明できるか。
解答(問5-2)
差は なので、予想は (四捨五入)である。実際の得点の割合は で、差は 4.5 ポイントである。得点の割合 0.17 を 32 局から求めたときの標準誤差は で、差 0.045 はその約 0.7 倍なので、偶然の揺れで説明できる大きさである。ただし、この 32 局は 2 人のレーティングを求めるのにも使ったので、予想と実際が近いことは 式(61) が当てはまることの独立な確かめにはならない(1000 はどれくらいか の図2 の説明と同じ理由)。
第6章 計算資源と並列学習
この章では、学習にどれだけ計算が要るかと、その計算を 1 台の GPU と、複数の GPU や CPU のプロセスでどう速くするかを扱う。中心は、どういう性質があれば計算を複数の GPU や CPU のプロセス(以下「台」。並列に計算できる条件 で定義する)に分けられるかである。読む順は、公開されている例の 計算量の目安、このページの方策勾配法を 2 つの GPU で比べた 速さの比較、それらを使って分け方を論じる 並列に計算できる条件、Colab での構成と費用、途中からの再開への備え である。
計算量の目安
この節では、AlphaGo・AlphaZero 方式の学習にどれだけ計算が要ったかを、公開されている例で並べる。オセロ(8×8)は囲碁・チェスより打てる手が少なく、1局が最大 60 手なので、小さな計算で済んだ例がある。
| 例 | ゲーム | 方式 | 計算機 | 時間 | 学習の量 | 強さ |
|---|---|---|---|---|---|---|
| AlphaGo(2016) | 囲碁 | 人の棋譜+自己対戦+探索 | 各段階 50 GPU | 人の棋譜で約3週間、自己対戦で1日、見込みで1週間 | 3,000 万局面+128 万局+3,000 万局 | プロ棋士に勝利 |
| AlphaZero(2017) | チェス・将棋・囲碁 | 自己対戦+探索 | 自己対戦に TPU 5,000 台、学習に TPU 64 台 | 囲碁で 8 時間(16.5 万回の更新)の時点で AlphaGo Lee を上回る | 70 万回の更新(1回 4,096 局面) | 既存の最強プログラムを上回る |
| OLIVAW(2021) | オセロ | AlphaGo Zero 方式 | 無料の Colab。自己対戦は 19 人が複数のノートブックで分担(K80 GPU など)。学習は TPU を使うと K80 の約 10 倍速いと書いている | 30 日 | 20 世代、約 5 万局。1手 100〜400 回の探索 | イタリア王者に 4-0、元世界王者に 1 勝 2 敗 |
| Pgx の例(2023) | オセロ | Gumbel AlphaZero | A4000 GPU 1 台 | 11.4 時間 | 1手 32 回の探索、自己対戦 1,024 局を同時に、400 回の反復(約 1.05 億局面) | レーティングの推移を論文の図5に掲載(Pgx の基準モデルに先読み 32 回をさせた強さを 1,000 とした値) |
| Liskowski ら(2018) | オセロ | 人の棋譜だけ(探索なし) | GTX Titan 1 台 | 数時間〜数十時間 | WTHOR 11.9 万局(687 万局面) | 人の手を当てる割合は単一のネットワークで 62.7%(bagging で 64.0%)。2手読みの Edax に勝利 |
出典と原文:
- AlphaGo:(原文: "Training took around 3 weeks for 340 million training steps" / "trained in this way for 10,000 mini-batches of 128 games, using 50 GPUs, for one day" / "mini-batches of 32 positions, using 50 GPUs, for one week" — AlphaGo 論文 Methods)
- AlphaZero:(原文: "in Go, AlphaZero outperformed AlphaGo Lee after 8 hours (165k steps)" / "using 5,000 first-generation TPUs to generate self-play games and 64 second-generation TPUs to train the neural networks" — AlphaZero 論文)
- OLIVAW:(原文: "OLIVAW was entirely developed, trained, and tested on Colaboratory" / "a single training run lasting 30 days, 20 generations, and ∼ 50, 000 games" / "19 people contributed to the generation of games with their Google accounts" / "The training phase can be accelerated using the TPU runtime of Colaboratory" — OLIVAW 論文)。元世界王者 Borassi との対局は 2-1 で Borassi の勝ち。
- Pgx:(原文: Table 23 "Othello A4000 x 1 11.4"、"During the self-play, 32 simulations were performed at each position"、"We performed training for 400 iterations (≈ 105M frames)"、Table 22 "Number of channels of conv. layer 128" — Pgx 論文)
- Liskowski ら:(原文: "the WThor database contains the records of 119,339 games" / "The deep CNN-based move predictor with its nearly 63% of accuracy" / 表 "Conv8+BN+bagging 64.0" — Liskowski ら)
このページの規模に当てはめると、Pgx の例が近い。Pgx の例は 128 チャンネル・GPU 1 台・約 1.05 億局面である。このページの AlphaZero はネットワークを 64 チャンネルに小さくし、Colab の L4 1台で 150 回の反復(1回約 26 万局面なので約 3,900 万局面、Pgx の約 37%)にした。実測では 150 回で 171.6 分・61.5 万局だった。学習後の強さは 学習の結果 にあり、Pgx の基準モデル(先読みなし)に、先読み 32 回で 86.7% 勝ち、先読みなしどうしでは 52.7%(ほぼ互角)だった。Pgx の基準モデルが Pgx の論文の学習とどう対応するかは確かめていないので、局面の数 37%(チャンネル数も半分なので、畳み込みの計算量はさらに小さい)で Pgx の例と同じ強さになったとは言えない。
速さの比較
この節では、同じプログラムを手元の RTX 3070 Ti と Colab の A100 で15秒ずつ走らせ、処理の速さと学習の進み方を比べる。プログラム・学習時間(15秒)・学習率は同じで、 が違う。そのほか、CPU(手元は Core i9-11900K、A100 の VM は Xeon 2.20GHz)と PyTorch の版(手元は 2.10.0、A100 は 2.11.0)も違う。A100 は1回だけ走らせた(Colab の計算ユニットを節約するため)。どの設定も乱数の種は同じ1つで、種を変えたくり返しはしていない。
1秒あたりの対局数
この節では、機種と ごとの処理の速さを比べる。次の表は、 ごとの更新の回数、1回の更新にかかった秒数、1秒あたりの対局数である。学習時間は「15秒を過ぎたら止める」ので実際には 15.17〜15.22秒だった。1回の更新の秒数は実際の時間を更新の回数で割り、1秒あたりの対局数は対局の総数を実際の時間で割った。値は GPU のページと同じ実行のもの。
| 機種 | 同時に進める対局数 | 更新の回数 | 1回の更新にかかった秒数 | 1秒あたりの対局数 |
|---|---|---|---|---|
| RTX 3070 Ti | 4,096 | 73 | 0.208 | 19,706 |
| RTX 3070 Ti | 8,192 | 41 | 0.370 | 22,135 |
| RTX 3070 Ti | 16,384 | メモリ不足で停止 | ― | ― |
| A100 40GB | 16,384 | 37 | 0.411 | 39,839 |
A100()は、1秒あたりの対局数が手元の最大( の 22,135)の 1.8倍だった。これは ・CPU・PyTorch の版も違う条件を1回ずつ測った比で、機種だけの差ではない。手元は を 4,096 から 8,192 に倍にしても1秒あたりの対局数が 12% しか増えなかった。1回の更新の秒数 が の1次式だと仮定する( は によらない固定分、 は1局あたりの時間)。
手元の2点( で 0.208秒、 で 0.370秒)を 式(70) に入れて解くと、 秒、 秒(四捨五入)になる。式(70) が成り立つとして手元で を動かせたとすると約 0.69秒で、A100 の 0.411秒の 1.7倍になる(2点からの外挿による推測)。
このプログラムは torch.autocast(混合精度)も torch.set_float32_matmul_precision(行列積に TF32 を使う設定)も呼んでいないので、全結合層の行列積は FP32 のまま計算される(PyTorch の既定、GPU のページ)。そのため、GPU のページの行列積の 6倍は当てはまらない。FP32 のままの行列積の実測の差は 1.2倍で、1.8倍はこれより大きい。どの処理が時間を決めているかは測っておらず、1.8倍の理由は分からない。
学習の進み方
この節では、学習中の対局で負けた割合が、秒数と更新の回数に対してどう上がったかを比べる。
図3 は、学習中の対局(AI が確率に従って乱数で手を選ぶ)で負けた割合を、横軸を秒数(左)と対局数(右)にして描いたもの。手元の2本は1回の更新ごと、A100 は10回の更新ごとに記録した。手元の2本は、上の表とは別の実行で記録した(1秒あたりの対局数の差は 1% 以内)。曲線が約 50% から始まり、方策勾配法の学習の結果の学習前(34.9%)と違うのは、図3 は確率に従って乱数で手を選んだ値、結果の表は確率が最大の手を選んだ値だからである。
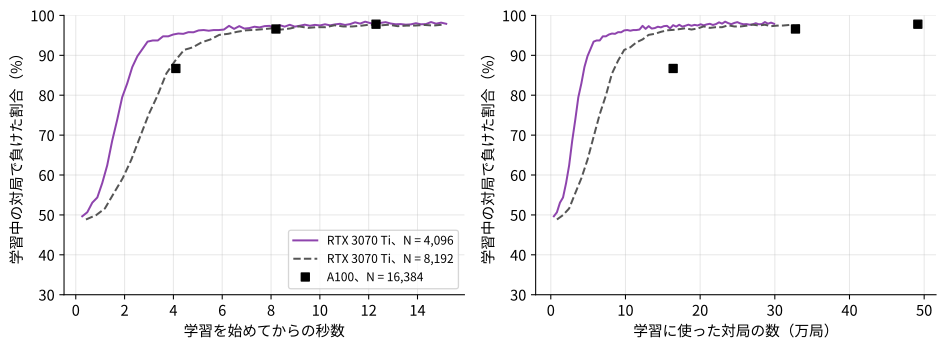
図3 学習中の対局で負けた割合。紫の実線は RTX 3070 Ti で 、灰色の破線は RTX 3070 Ti で 、黒い四角は A100 で 。左は横軸が学習開始からの秒数、右は学習に使った対局数(万局)。左で紫の線が最も早く上がる。右で3つを同じ対局数で比べられるのは 16.4万局の点だけで、そこでは紫が最も高く、黒い四角が最も低い。
同じ更新の回数で比べると、10回と20回では が大きいほど負けた割合が高いが、30回では順序が崩れる。差は最大で 3.7 ポイント(10回)である。
| 更新の回数 | RTX 3070 Ti、4,096 局 | RTX 3070 Ti、8,192 局 | A100、16,384 局 |
|---|---|---|---|
| 10 | 83.0% | 85.4% | 86.7% |
| 20 | 95.5% | 96.4% | 96.6% |
| 30 | 97.4% | 97.2% | 97.8% |
(学習中の対局で負けた割合。小数第2位を四捨五入。「10」の行は 10 回目の更新に使った対局、つまり 9 回更新した後の方策で打った対局の値(20・30 も同じ))
同じ秒数で比べると、1秒あたりの更新の回数が多い手元の が最も進んでいた。4秒前後の時点では次のとおり。
| 機種と同時に進める対局数 | 記録した時点 | その時点までの更新の回数 | 学習中の対局で負けた割合 |
|---|---|---|---|
| RTX 3070 Ti、4,096 | 4.2秒 | 20 | 95.5% |
| RTX 3070 Ti、8,192 | 4.1秒 | 11 | 88.7% |
| A100、16,384 | 4.1秒 | 10 | 86.7% |
2つの表から、この実験の範囲では、同じ秒数での差(最大 8.8 ポイント)に比べて、同じ更新の回数での差(最大 3.7 ポイント)は小さかった。10回・20回では が大きいほど高いが、乱数の種を変えたくり返しをしていないので、 の効果か乱数によるばらつきかは分からない。更新の回数でおおよそそろう理由は確かめていない。推測では、式(25) は AI の手の総数で割った平均なので を大きくしても勾配の大きさは増えず、Adam(式(31))は勾配の大きさで割って進む幅をそろえるので、1回の更新で進む量は にあまりよらない。 で走らせた A100 は、1秒あたりの対局数は 1.8倍だったが、1秒あたりの更新の回数が手元の の約半分だったので、同じ秒数での学習は手元より遅れた。12秒以降は、手元の2本が 97.3〜98.3%、A100 が 12.3秒の時点で 97.8% だった。
並列に計算できる条件
この節では、どういう性質があれば計算を複数の GPU や CPU のプロセスに分けて速くできるかを、式と、このページの実例で示す。以下、計算を分担する GPU・CPU のプロセス・スレッドをまとめて「台」と呼び、台の数を 、台の番号を ()とする。GPU や CPU を載せた機械そのもの(VM を含む)は「マシン」と呼んで、台と区別する。台の間でデータを送ることを「通信」と呼ぶ。この節の は、第2章の MLP に限らず、AlphaZero の も含めてネットワークのパラメータ一般を表す。 は標本の番号、 は台の番号である(第2章の や、第5章の打ち手の ・記録の とは別)。台の数 は、第3章の ・ の添字 G(ガンベル分布の G)とは関係ない。 は第4章と同じく負けたがる AI の世代の番号である。読む順は、仕事の分け方、データ並列が成り立つ条件、通信と計算の比、Amdahl の法則、強化学習に特有の点、モデル並列とパイプライン並列が要るとき、そのまま並列にできる仕事、並列にしにくい仕事、並列の数と速くなる倍率 である。
仕事の分け方
この節では、計算を複数の台に分ける方法を 4 つに分け、各台が何を持ち、台の間で何を送るかを並べる。
| 分け方 | 各台が持つもの | 台の間で送るもの | このページでの例 |
|---|---|---|---|
| データ並列 | 同じパラメータの写しと、1 回の更新に使うデータの一部 | 更新のたびに勾配(BatchNorm を合わせるなら、その統計も) | このページでは使っていない。Pgx の AlphaZero の例が使う |
| データを集める部分と学習する部分の分担 | 自己対戦の台はパラメータの写し、学習の台はパラメータと最適化の状態 | パラメータ(学習の台から)と対局の記録(自己対戦の台から) | OLIVAW が Colab のノートブックで自己対戦を分担した |
| モデル並列・パイプライン並列 | パラメータの一部(各層の一部、または一部の層) | 層の途中の値 | このページでは要らない |
| そのまま並列 | 互いに独立な仕事の全部 | 無し(終わった結果を集めるだけ) | 別々の実験、評価の対局、ブートストラップ(並列にできるが、このページでは順に計算した)、負けたがる AI の自己対戦と当てはめ |
以下の節で、それぞれが成り立つ条件と、速くなる上限を示す。
データ並列が成り立つ条件
この節では、1 つのネットワークの 1 回の更新を 台で分担したときに、1 台で計算したのと同じ更新になる条件(損失が標本ごとの和であること、勾配の平均で更新すること、BatchNorm の統計を合わせること)を示し、あわせて標本を増やしたときの学習率の扱いを示す。
損失が標本ごとの項に分かれること
この節では、勾配を台ごとの計算に分けられる条件を式で示す。1 回の更新に使う 個のデータ(局面や対局。以下「標本」)に番号 を付け、標本 の損失を とする。 は で割り切れるとし、台 が受け持つ 個の標本の番号の集合を とする。1 回の更新で小さくする量は標本の損失の平均 とする。
和は 個の部分和に分けられ、微分は和の各項に分けられるので、次の式が成り立つ。2 つ目の等号は による。
は、Adam の式 の と同じく損失の勾配である。台 が自分の標本だけで を計算できるのは、 が標本 と だけで決まり、ほかの標本によらないときである。これがデータ並列の 1 つ目の条件である。
このページの方策勾配法の損失 式(25) は、対局ごとの和に見えるが、2 か所でほかの対局を使う。ベースライン (式(20))は 局全部の得点の平均で、割る数 は 局全部の手の数の和である。そこで、 局を 台に 局ずつ分け、台 の対局の番号の集合を とすると、勾配の計算の前に、各台が得点の和 と手の数の和 の 2 つの数を全台で足し合わせれば、 と が全台で同じ値になる。その後は、式(26) の和を、次の 式(72) のとおり台ごとの部分和に分けられる。この部分和は平均ではなく和なので、全台で集めるときは平均ではなく和をとる(平均をとった場合は 倍する)。
AlphaZero の損失 式(43) は、局面ごとの項(見込みの 2 乗誤差と、確率の交差エントロピー)と、標本によらないパラメータの大きさの項 からなる。後者は全台で同じ値なので、どの台で計算しても同じで、和の分解を妨げない(このページの実装ではこの項を除いている。第3章の このページの実装)。したがって BatchNorm(下の BatchNorm の統計)を除けば、この条件を満たす。
勾配を集めると大きなバッチ 1 回と同じ更新になること
この節では、各台の勾配の平均をとって更新すれば、全台のパラメータが同じに保たれ、1 台で 個の標本を使った更新と同じになることを示す。各台の を全台で平均し、その結果を全台が受け取る通信を all-reduce と呼ぶ。
- はじめに、全台に同じパラメータと同じ最適化の状態(Adam の 式(30) の )を置く。
- 各台が を計算し、all-reduce で を受け取る。式(71) より、これは 個の標本の損失の平均の勾配に等しい。
- 各台が、同じ勾配で同じ最適化の式(式(31))を当てる。更新の前のパラメータと状態が全台で同じなら、更新の後も同じである。
1 から始めて 2 と 3 をくり返すので、何回更新しても全台のパラメータは同じで、1 台で 個の標本を使って更新したのと同じになる。Adam は勾配について線形でない(式(31) で 2 乗の移動平均の平方根で割る)が、全台が平均した後の勾配に当てるので、この議論はそのまま成り立つ。ただし、浮動小数の足し算は順番で結果がわずかに変わるので、足す順番が 1 台のときと違えば、値は丸めの誤差の範囲で一致しない。
バッチを大きくしたときの学習率
この節では、台を増やして 1 回の更新の標本を増やしたときに、学習率をどう変えるかを示す。1 台で標本 個を使っていた更新を、1 台あたりの標本を 個のまま 台に増やすと、1 回の更新の標本は 個になる。
標本が互いに独立で同じ分布から出るとき、 個の平均の勾配の各成分は、平均が標本の数によらず、分散が 1 標本の勾配のその成分の分散の 倍になる(独立な数の和の分散は分散の和なので、 個の和の分散は 1 標本の分散の 倍で、 で割ると和の分散の 倍、つまり 1 標本の分散の 倍になる)。標本を増やすと、勾配の向きの平均は変わらず、ばらつきだけが減る。
勾配の逆向きに進める最も単純な更新(式(29))で、学習率 ・標本 個の更新を 回続けることと、標本 個の更新 1 回を比べる。 回目(。Adam の式と同じく 1 から数える)の更新に使う 個の標本の集合を 、その損失の平均の勾配を 、 回更新した後のパラメータを と書くと、 回の更新の後のパラメータは
である。最後の等号は 式(71) と同じく、平均の平均が全体の平均になることによる。 は、 回の更新のあいだにパラメータがあまり動かず、勾配がほぼ変わらない()と仮定した近似である。式(73) から、標本を 倍にした 1 回の更新で同じだけ進むには、学習率を 倍にすればよい。これを学習率の線形の規則と呼ぶ(Goyal ら、2017、arXiv:1706.02677)。仮定が成り立たない学習の初めや、学習率が大きすぎる場合は、この規則で学習が不安定になりうるので、同じ論文は学習の初めに学習率を少しずつ上げる工夫(warmup)を併用している。
このページの学習は Adam を使う。Adam は 式(31) で勾配を勾配の大きさの移動平均で割るので、1 回に進む幅は主に学習率で決まり、式(73) の議論はそのままは当てはまらない。実験では、学習率を のまま同時に進める対局数 を 4,096・8,192・16,384 にし、同じ更新の回数での負けた割合の差は最大 3.7 ポイントだった(学習の進み方)。標本を増やしただけでは 1 回の更新で進む量はほとんど増えなかった(乱数の種 1 つで、機種も違う 3 回の実行なので、 の効果と乱数のばらつきは区別できていない)。学習率を上げると速くなるかは確かめていない。
BatchNorm の統計
この節では、BatchNorm を使うネットワークでは 式(71) の条件が成り立たない理由と、成り立たせる方法を示す。BatchNorm(第3章の このページの実装 で定義した層)は、ある層の 1 つのチャンネルについて、バッチの中の値の平均と分散で値をそろえる。畳み込みの後の BatchNorm では、1 つの標本の 1 つのチャンネルに 64 マス分の値があるので、バッチの標本が 個なら、そろえる値は 個ある(haiku の hk.BatchNorm は、標本とマスの全部について平均をとる)。その値に番号 を付けて と書く。
は 0 で割らないための小さな正の数である。BatchNorm の出力は、 に学習する係数をかけ、学習する定数を足した値である。式(74) の は と を通じてバッチの全標本によるので、標本 の損失もほかの標本による。各台が自分の 個の標本の値( 個。その番号の集合を とする)だけで平均 と分散 をとると、1 台で 個を使ったときと違う値になる。
全体の平均と分散は、台ごとの平均と分散から計算できる。 個の値 の分散は、2 乗を展開して と書ける( はその 個の平均)。台 の値にこれを当てると 、全体の値に当てると である。全体の和を台ごとの和に分けると次になる。
したがって、各台が と の 2 つの数をチャンネルごとに全台で平均すれば、1 台のときと同じ統計になる(逆伝播でも、平均と分散についての勾配を全台で合わせる必要がある。ここでは順伝播だけを数える)。このページの AlphaZero のネットワーク(othello_net.py)は BatchNorm を 15 層(残差ブロックに 12、その後に 1、手の確率と見込みの出力の前に 1 つずつ)持ち、チャンネルの合計は なので、1 回の順伝播で合わせる数は 個である。数は少ないが、順伝播だけで 15 か所、全台がそろうのを待つことになる。
自己対戦では、BatchNorm は学習中にためた平均と分散の移動平均を使う(az_train.py の自己対戦は is_eval=True)。このときは が定数なので、局面ごとの計算は互いに独立で、自己対戦は台ごとに自由に分けられる。
計算量の目安 の Pgx の論文は、9×9 の囲碁で A100 を 1 台(同時に 1,024 局)から 8 台(同時に 8,192 局)にした比較を示し、自己対戦が学習時間の 90% 超を占めたと書いている(原文: "the time spent on self-play was dominant (more than 90%) compared to the time spent on training" — Pgx 論文 付録)。Pgx の AlphaZero の例(このページの実装の元)は、JAX の pmap で自己対戦の局を GPU ごとに分け、勾配を pmean で平均する作りで、BatchNorm は GPU 間で合わせていない(haiku の cross_replica_axis を使っていない)ので、厳密には 1 台の学習と同じ更新ではない。このページの実装は 1 台用にこの部分を外した。PyTorch では DistributedDataParallel が勾配の all-reduce を行う。
通信と計算の比
この節では、台を増やしたときの 1 回の更新の時間を、計算と通信に分けて式にし、このページのネットワークで数値を出す。
1 回の更新の時間
この節では、all-reduce にかかる時間の式を示す。パラメータの数を 、1 個の数のバイト数を (FP32 なら 4)、1 台が送れる速さを (バイト毎秒)とする。台を輪の形につないで、隣の台にだけ送る all-reduce(ring all-reduce)では、1 台が送る数は 個である(下の折りたたみ)。1 回の送受信にかかる固定の待ち時間を無視すると、all-reduce の時間は
である。式(76) は を増やしても を超えない。1 台で 1 回の更新の計算にかかる時間を 、 台で分けたときの 1 台の計算時間を とし、 台のときの 1 回の更新の時間と、速くなる倍率 を次で定義する。
詳しくはこちら(ring all-reduce で 1 台が送る数)
個の数を 個の塊(各 個)に分ける。前半(reduce-scatter)では、 回、各台が 1 つの塊を隣へ送り、受け取った塊を自分の同じ番号の塊に足す。1 回目は台 が自分の塊 を送り、2 回目以降は直前に受け取って足した塊を送る。こうすると、 回の後には、各塊について全台の和を持つ台がちょうど 1 台ずつできる(塊 の和は、塊 が輪を 歩進んだ先の台にある)。後半(all-gather)では、同じ向きに 回、和ができた塊を隣へ送って写す。1 台が送る数は前半・後半とも 個で、合わせて 個である。全台が同時に送るので、時間は 1 台が送る量で決まる。
このページのネットワークでの数値
この節では、式(76) をこのページのネットワークに当てはめる。 には 2 つの例を使う。PCIe 4.0(GPU と CPU をつなぐ規格)の 16 レーン(1 レーンあたり毎秒 16 G 回の転送、128 ビットを 130 ビットで送る符号化)の片方向の公称値 GB/s と、マシンどうしを 10 Gbit/s の回線でつないだ場合の GB/s である。どちらも公称値で、実際の速さは測っていない。、 の値は次のとおり(四捨五入)。
| ネットワーク | パラメータの数 | パラメータの大きさ(FP32) | all-reduce の時間(31.5 GB/s) | all-reduce の時間(1.25 GB/s) |
|---|---|---|---|---|
| 方策勾配法の MLP(式(3)) | 131,648 | 526,592 B | 0.029 ミリ秒 | 0.74 ミリ秒 |
| AlphaZero(Pgx の基準モデル の節で数えた値) | 458,827 | 1,835,308 B | 0.10 ミリ秒 | 2.57 ミリ秒 |
| Pgx の基準モデル(同上) | 1,793,995 | 7,175,980 B | 0.40 ミリ秒 | 10.0 ミリ秒 |
計算の時間と比べる。方策勾配法の MLP の 1 回の更新は、手元の RTX 3070 Ti で のとき 0.208 秒だった(1秒あたりの対局数)。all-reduce は遅い回線でもその 0.4% 以下で、8 台に分けた後の 1 台の計算時間( 秒)と比べても 1.1% である。AlphaZero は 1 回の反復が平均 68.6 秒(L4 で 150 回に 171.6 分)で、その中で 64 回更新する。64 回の all-reduce は遅い回線でも ミリ秒 秒である。データ並列で分けるのは学習の部分なので、比べる相手は反復全体ではなく学習の部分の時間である。学習の部分は測っていないが、下の Amdahl の法則 の見積もり(反復の 8.3%)を使うと約 5.7 秒で、0.16 秒はその約 2.9% である。このページの規模では、通信は速さをほとんど決めない。速さの上限を決めるのは、次の節の「分けられない部分」である。
Amdahl の法則
この節では、計算のうち台に分けられない部分の割合が、速くなる倍率の上限を決めることを示す。1 台での時間 のうち、分けられない部分の割合を とする。残りの を 台で等分でき、通信の時間を無視すると、 なので、式(77) は次になる。
式(78) を Amdahl の法則と呼ぶ。台をいくら増やしても、速さは 倍を超えない。
方策勾配法の MLP の例。式(70) の 1 回の更新の時間 のうち、 は によらない部分である。 局を 台に 局ずつ分けると、各台の計算時間は で、 は台を増やしても減らない。手元の 2 点から求めた 秒、 秒()を使うと で、式(78) の上限は 倍、8 台では 倍である(all-reduce の 0.03 ミリ秒は無視できる)。これは 式(70) が より少ない局数でも成り立つと仮定した外挿で、確かめていない。 の中身は測っていないが、1 局の手を 1 手ずつ進めるたびに GPU に命令を出す時間(GPU のページ の、小さな処理を連続で投げたときの 1 回あたりの時間。手元で 5.7µs)が含まれると推測する。
AlphaZero の例。Pgx の論文の 9×9 の囲碁のように自己対戦が時間の 90% を占めるとき、学習の部分(10%)だけを分けると で、上限は 倍である。自己対戦も分けなければ速くならない。このページの AlphaZero の 1 回の反復で、ネットワークで局面を評価する回数を数えると、自己対戦は 1,024 局を同時に 256 手分進め(終局した対局は新しい対局から打ち直す)、1 手に 33 回(先読み 32 回と根の評価)評価するので 回、学習は 64 回 × 4,096 局面で、逆伝播を順伝播の 2 倍の計算とみなすと 回分である。時間が評価の回数に比例すると仮定すると、自己対戦は を占める(この割合は測っていない。計算による見積もりである)。
台を増やすとき、1 台あたりの局数を変えずに全体の局数を 倍にすれば、 は 1 回の更新に 1 回のままなので、1 秒あたりの対局数は、通信の時間を除けば 倍になる。ただし バッチを大きくしたときの学習率 のとおり、この学習では 1 回の更新の対局を増やしても 1 回で進む量はほとんど増えなかったので、学習が 倍速く進むとは言えない。
強化学習に特有の点
この節では、強化学習ではデータを集める部分(自己対戦)と学習する部分を分けて並列にできること、そのとき古いパラメータで集めたデータを使ってよいかが方法によって違うことを示す。
自己対戦は局ごとに独立
この節では、パラメータを固定すれば自己対戦の局どうしが独立で、そのまま並列にできることを示す。1 局の記録 が起きる確率は、式(7) のとおり、色を決める確率と各手の確率の積である(第2章はランダムな相手との対局で、相手の手の確率は によらない)。両者が同じ で打つ自己対戦では、相手の手の確率も になる。この確率を と書いて区別するが、色を決める確率と各手の確率の積であることは同じである。以下の 式(79) は、 を に替えても同じく成り立つ。同じパラメータ で 局を、局ごとに別の乱数で打つと、 局の記録が同時に起きる確率は各局の確率の積になる。
式(79) は、局 の進み方がほかの局によらないことを表す。したがって、 局を 台に分けて打っても、集めた記録の確率は同じで、台の間の通信は記録を集めるときだけで済む。成り立つための条件は 3 つある。
- 打っているあいだ、パラメータを変えない。
- 台ごとに別の乱数の列を使う。同じ種を使うと同じ対局がくり返され、独立な対局の数が減る。負けたがる AI の
train.pyは、世代 (第4章)の自己対戦で、0 から数えたプロセスの番号 を使って種を にした。 - BatchNorm は、バッチの統計でなく、ためた移動平均を使う(BatchNorm の統計)。
データを集める部分と学習する部分を分ける
この節では、自己対戦をする台と学習をする台を分ける作りを示す。自己対戦の台は何台も動かし、それぞれ受け取ったパラメータで対局して記録を共有の置き場に書く。学習の台は記録を読んでパラメータを更新し、新しいパラメータを置き場に書く。通信は「パラメータと記録のやり取り」だけで、更新のたびに全台をそろえなくてよい。AlphaZero は自己対戦に TPU 5,000 台、学習に 64 台を使った(計算量の目安)。OLIVAW は、Colab のノートブックを 19 人で動かして自己対戦を分担した(原文: "Game generation can be naturally performed in parallel, by running several instances of the self-play notebook and saving the generated datasets on shared memory." — OLIVAW 論文)。
この作りでは、学習の台が 回更新したパラメータ を持つとき( は 更新 の Adam の式と同じく更新の回数)、届く記録は、それより前のパラメータ (。 を遅れと呼ぶ)で打たれたものになる。次の節で、この遅れが方法によって問題になるかどうかを示す。
古いパラメータで集めたデータ
この節では、古いパラメータ で集めた対局を使って を更新してよいかを、方策勾配法と AlphaZero で比べる。
方策勾配法。式(9) の平均は、今のパラメータ で打った対局()についての平均である。 で打った対局に同じ式を当てると、式(12) の和の重みが から に替わる。
式(80) は、 なら一般に 式(12) の と一致しない。方策勾配法は、今の方策で打った対局を前提にした方法(on-policy)である。
重みの違いを補うには、対局ごとに確率の比をかける。以下は第2章の設定(相手はランダム)での式である。自己対戦の対局を使う場合は、相手の手も古い方策で打たれているので、比に相手の手の確率の比も入る。この比を重要度の重み と呼ぶ。式(7) を分子と分母に入れると、 によらない (AI の色と相手の手の確率)が消え、AI の手の確率の比の積だけが残る。
を 手目の比と呼ぶ。相手の打ち方を知らなくても、記録した手について今と古い方策の確率を計算すれば が求まる。式(4) より合法手の確率は正なので分母は 0 にならない。 をかけると、平均は に戻る。
最後の等号は 式(12) による。平均は正しくなるが、式(81) は約 30 個(1 局の AI の手の数)の比の積なので、 と が少し違うだけで、ごく少数の対局の重みが極端に大きくなりうる。そうなると、 局の平均は実質的に少数の対局だけで決まり、ばらつきが大きくなる。その度合いを、 局の重みから求める有効な標本の数で測る。
式(83) は、重みがすべて等しければ 、1 局だけが正で残りが 0 なら 1 になる(コーシー・シュワルツの不等式 より )。名前の理由は次のとおり。局ごとの値 が互いに独立で分散が同じ のとき、重みを定数とみなした重み付きの平均 の分散は で、重みの等しい 局の平均の分散 と同じになる。式(82) の左辺を 局で推定するときは、重みの和ではなく で割るので、この分散の式はそのままは当てはまらないが、少数の重みの大きい対局で値が決まる点は同じである。
手元の CPU で、第2章と同じ学習(負けたがる MLP、相手はランダム、、Adam・学習率 )を 32 回更新し、毎回のパラメータを残した。そのうえで、 回更新した方策を今の方策 、遅れ の方策を とし、 で 4,096 局を打って 式(81) と 式(83) を計算した(othello-lose/parallel_study/stale_weights.py、2026-10-21)。学習中の対局で負けた割合は、1 回目の更新に使った対局(学習前の方策)で 46.3%、32 回目の更新に使った対局で 96.7% だった。
| 今の方策の更新の回数 | 遅れ(更新の回数) | 有効な標本の数(4,096 局のうち) | 有効な標本の割合 | 重みの対数の標準偏差 | 最も大きい重みが重みの和に占める割合 |
|---|---|---|---|---|---|
| 8 | 1 | 3,152 | 77.0% | 0.56 | 0.12% |
| 8 | 2 | 1,750 | 42.7% | 1.10 | 0.45% |
| 8 | 4 | 476 | 11.6% | 1.95 | 1.1% |
| 8 | 8 | 61 | 1.5% | 2.86 | 9.3% |
| 32 | 1 | 3,505 | 85.6% | 0.41 | 0.10% |
| 32 | 2 | 2,122 | 51.8% | 0.85 | 0.44% |
| 32 | 4 | 653 | 15.9% | 1.79 | 0.97% |
| 32 | 8 | 14 | 0.35% | 4.15 | 24.9% |
| 32 | 16 | 1.05 | 0.03% | 12.38 | 97.6% |
(四捨五入。どの行も 1 回だけ打った値)
1 回分の遅れでも有効な標本は 77〜86% に減り、8 回分の遅れでは 1.5% 以下になった。16 回分の遅れでは、4,096 局のうち 1 局の重みが和の 97.6% を占め、平均は実質 1 局で決まった。有効な標本が半分以上残ることを目安にすると、使えるのは遅れ 1 回分(2 回分では 42.7%・51.8% で、半分前後)までである。どの行も 1 回の学習の値である。表に載せていない 32 回目の方策と学習前の方策(遅れ 32)の組では、有効な標本は 1.48 局(4,096 局のうち)だった。
重みを上から切って、ばらつきを抑える方法がある。IMPALA(Espeholt ら、2018、arXiv:1802.01561)の V-trace は、局面の見込みを出す関数 (方策とは別に、見込みとして学習する関数。方策と同じネットワークの別の出力にしてもよい)を使い、 手目の比 を 2 つの上限 で切る。この問題に合わせて書く。 は第1章の記号のとおり AI が 回目に石を打った局面で、終局後を表す の見込みは とする。AI の 手目の得点 を、最後の手 だけ 、ほかは 0 とする()。見込みの差 (TD は temporal difference の略)と、切った比を次で定義する。
手目の見込みの目標 を次で定義する(空の積は 1)。
を 式(85) の に近づけるように学習し、方策は の向きに更新する()。上限を 1 以下にすれば、式(84) の比はどれも 1 以下で、式(85) の積も 1 以下になるので、式(81) の積のように大きくならない(上限を 1 より大きくすると、積は 1 を超えうる)。その代わり、比を切った場合の は今の方策の見込みとは限らず、論文によれば、 と のあいだの方策の見込みになる(このページでは確かめていない)。
今の方策で打った対局()で上限を 1 以上にすると、 はその対局の得点 そのものになり、方策の更新の向きは になる(下の折りたたみ)。これは、第2章の 式(14) の定数のベースライン を、局面ごとに変わる に替えた形で、局面ごとに変わるベースラインでも平均が変わらないことも折りたたみで示す。
詳しくはこちら(今の方策の対局での V-trace の目標と、局面ごとのベースライン)
なら 式(81) の で、上限が 1 以上なら 式(84) の である。式(85) の積はすべて 1 になり、
である。2 つ目の等号は、 の和で隣どうしが打ち消し、 だけが残り、先頭の と打ち消すことによる。3 つ目の等号は、 が でだけ で、 であることによる。
方策の更新の向きの は、 では で 式(86) より 、 では で なので、どの でも である。よって更新の向きは になる。
局面ごとのベースライン を引いても平均が変わらないことを示す。 までの対局の進み方を決めたうえで、 について平均をとる。 は確率 で選ばれ、 は によらないので、式(11) の と同じ変形で
である。1 つ目の等号は (式(11) と同じ)、3 つ目は合法手の確率の和が 1(式(4))であることによる。式(87) は までのどの進み方でも 0 なので、それをさらに平均しても 0 である。したがって の項は平均に寄与せず、更新の向きの平均は の平均、つまり 式(9) の に等しい。
AlphaZero。式(43) の損失は、記録した局面とその目標の組 ごとの値である。組を明示して と書く(パラメータの大きさの項 はどの組でも同じ値で、平均をとっても変わらない)。記録の集まりを とすると、小さくする量はその平均
で、その勾配は組ごとの勾配の平均である。 は和の各項の中にだけあり、どの組が に入るかの確率には入っていない。方策勾配法では、 が 式(8) の和の重み に入っていたので、その微分から 式(11) を通って「 で打った対局の平均」が出てきた。式(88) にはこの段階が無いので、 をどのパラメータで集めても、式(88) の勾配の式は変わらない。古いデータで変わるのは目標の中身である。 は古いネットワークで探索した結果で、 は古いネットワークどうしが打った対局の結果なので、 は古い打ち手どうしの勝ち負けの見込みを学ぶことになる。古すぎるデータは、学習の目標そのものが今の打ち手に合わなくなると推測する(確かめていない)。
このページの AlphaZero は、1 回の反復で集めた約 26 万局面で 64 回更新した(このページの実装)。最後の更新に使う局面は、63 回前のパラメータで打たれたものである。AlphaZero ではこの遅れは 式(88) の勾配の式を変えないが、方策勾配法で同じことをすると、上の表のとおり 8 回分の遅れで有効な標本が 1.5% 以下になる。第2章の MLP(GPU のページのプログラム)、比べるのに使った MLP(train_zoo.py)、AlphaGo 方式の段階 2(方策勾配法)は、どちらも 1 回の更新ごとに新しい対局を打ち、その対局を 1 回の更新だけに使った(train_zoo.py、alphago_train.py)。
モデル並列とパイプライン並列が要るとき
この節では、パラメータを台に分けて持つ方法が要るのは、パラメータと最適化の状態が 1 台の GPU のメモリに載らないときであることと、このページでは要らない理由を示す。FP32 のパラメータを Adam で学習するとき、パラメータ 1 個あたり、値(4 バイト)・勾配(4 バイト)・Adam の (式(30)、8 バイト)で 16 バイトを使う。
式(89) は、AlphaZero のネットワーク(458,827 個)で 7.3 MB、Pgx の基準モデル(1,793,995 個)で 28.7 MB で、手元の RTX 3070 Ti の 8 GB の 0.4% 以下である。これに対し、パラメータ 700 億個のネットワークでは バイト(1.12 TB)で、80 GB の GPU 14 台分になり、1 台には載らない(層の途中の値は含めていない)。
載らないときの分け方は 2 つある。モデル並列は、各層の行列を行や列で分けて台ごとに持ち、層ごとに途中の値をやり取りする。パイプライン並列は、続いた層のまとまりを台ごとに持ち、前の台の出力を次の台へ送る。パイプライン並列では、1 つのバッチを 個の小さなバッチに分けて流す。各台が小さなバッチ 1 つの計算に時間 かかるとする。最初の台は小さなバッチを 1 つずつ続けて計算するので、最後の小さなバッチは時刻 に最初の台に入り、そこから 台を順に通って時刻 に最後の台を出る。これが全体の時間で、その間に各台が計算している時間は である。各台が待っている時間の割合は
で、小さなバッチの数を台の数より十分多くすると小さくなる(順伝播だけを数えた。逆伝播も同じ形で数えられる)。
このページでは、パラメータは 1 台に載るので、どちらも要らない。AlphaZero の学習プログラム(az_train.py)の説明には「手元の GPU(8GB)に収まるネットワーク」とあり、Pgx の例の 128 チャンネルを 64 チャンネルにした。式(89) のとおりパラメータは小さいので、メモリを使っていたのは、1,024 局の探索と 4,096 局面の学習のバッチの途中の値だと推測する(測っていない)。途中の値はバッチの大きさに比例するので、減らすにはバッチを分ける(データ並列、または 1 台で小さなバッチの勾配を何回分か足してから更新する)。後者は、このページの AlphaGo 方式の段階 2 が使っている。alphago_train.py は、128 局の 70 手分を 10 手ずつに分けて勾配を足し合わせ、そのあと 1 回更新する(プログラムのコメントによれば、一度に逆伝播すると T4 のメモリに収まらないため)。各部分を手の総数で割ってから足すので、全体を一度に計算したのと同じ勾配になる。
そのまま並列にできる仕事
この節では、互いに結果を使わない仕事は、通信なしに台の数だけ速くできることを、このページの例で示す。仕事 1 の計算が仕事 2 の結果を使わず、仕事 2 も仕事 1 の結果を使わなければ、2 つを別の台で同時に計算しても、順に計算したのと同じ結果になる。台の間でやり取りするのは、仕事を配ることと結果を集めることだけである。
| 仕事 | 互いに独立な理由 | このページでの実行 |
|---|---|---|
| 別々の実験(学習のしかた・設定・乱数の種が違う学習) | 別のパラメータを別のデータで学習し、途中で何も共有しない | 2026-10-20 に、AlphaZero を Colab の L4、AlphaGo 方式を別の Colab の T4 で同時に学習した |
| 評価の対局 | パラメータを固定した 2 人の対局は、局ごとに独立(式(79) と同じ理由)。組どうしも独立 | eval_all.py は組を順に、1 組の局は GPU でまとめて同時に打った。rr_mlp.py は 253 組を CPU(8 スレッド)で順に打った。arena.py は 1 組の 100 局を 8 プロセスに分けた(league.py から呼ぶ) |
| ブートストラップ | 200 回の引き直しは、それぞれ別の乱数で記録を引き直して 式(63) を当てはめるだけで、互いの結果を使わない | elo_ci_raw.py は 200 回を 1 プロセスで順に計算した(並列にはしていない) |
| 負けたがる AI の自己対戦 | 前の世代の点数表を固定すれば、局ごとに独立。プロセスごとに別の乱数の種 | 1 世代の 96,000 局を 8 プロセスに 12,000 局ずつ分けた |
| 負けたがる AI の当てはめ | 下の 式(91) のとおり、損失が段階ごとの和に分かれ、段階どうしで点数表を共有しない | 段階ごとに別のプロセス(同時に 8 つまで)で当てはめた |
負けたがる AI の当てはめが段階ごとに分かれる理由を式で示す。局面 の点 式(59) は、段階 の点数表 と定数 だけを使う。段階の番号 (。局面 とは別の記号)の点数表と定数をまとめて 、局面 の正解を第4章と同じく と書くと、全局面の 2 乗誤差は段階ごとの和に分かれる。
式(91) の各項は 1 つの だけで決まるので、 についての勾配は段階 の項の勾配だけで、ほかの段階の点数表によらない。13 個の問題を別々に解いても、まとめて解いたのと同じ結果になる。
自己対戦が台の数に比例して速くなるかを、手元の CPU(Core i9-11900K、8 コア 16 スレッド)で測った。世代 5 の点数表・深さ 2 の自己対戦 1,920 局を、1・2・4・8・16 プロセスに等分して打った(othello-lose/parallel_study/selfplay_scaling.py、2026-10-21、各 2 回)。
| プロセスの数 | かかった時間(2 回の平均) | 1 プロセスに比べて速くなった倍率 |
|---|---|---|
| 1 | 17.93 秒 | 1.00 |
| 2 | 9.24 秒 | 1.94 |
| 4 | 4.69 秒 | 3.82 |
| 8 | 2.53 秒 | 7.09 |
| 16 | 2.20 秒 | 8.14 |
(四捨五入)
8 プロセスまでは、ほぼプロセスの数に比例して速くなった。16 プロセスでは 8.14 倍にとどまった。CPU のコアは 8 つで、9 個目以降のプロセスは同じコアを 2 つのスレッドで分け合うためと推測する(確かめていない)。各プロセスの起動と点数表のファイル(16 段階分、約 10.7 MB)の読み込みも、表の時間に入っている。測った直後の 1 分間の平均の負荷は 3.7〜4.9 で、この中には測定そのものの負荷と、手元で動いていたほかのプロセスの負荷が入っている。
並列にしにくい仕事
この節では、前の計算の結果が無いと次の計算を始められない仕事(逐次的な依存)は、そのままでは台に分けられないことを、このページの例で示す。
- 負けたがる AI の世代。世代 の自己対戦には世代 の点数表が要り、世代 の点数表は世代 の対局が無いと当てはめられない。世代の中(局ごと・段階ごと)は分けられるが、世代どうしは順に計算するしかない。6 世代の自己対戦と当てはめの合計は 3,382 秒(約 56 分)だった(
train.log)。 - 1 局の中の手。 手目の局面は、 手目の局面と手から決まるので、1 局の手を同時に進めることはできない。このページでは、代わりに多くの局を同時に進めた(第2章の 局、AlphaZero の 1,024 局)。
- 1 手の中の先読み。先読みの手順 の各シミュレーションは、それより前のシミュレーションで更新した と を使って手を選ぶ。AlphaGo は多数のスレッドで同時に探索するために、通過中の枝を一時的に負けとして数える工夫(virtual loss)を使った(先読みの手順 の折りたたみ)。こうすると、1 本で探索した場合とは違う手順になる。
- αβ 探索の枝刈り。αβ 探索 で枝を省けるのは、先に読んだ手で分かった値を、後の手の読みに使うからである。後の手を先の手と同時に読み始めると、その値がまだ無いので、省けたはずの枝も読む。
αβ 探索で、どれだけ読む量が増えるかを、良い手から順に読めた場合で計算する。打てる手の数 、深さ では、1 本で読むと末端の局面は 個である(αβ 探索 の Knuth と Moore の式)。根の 10 手を 10 台で同時に、先の値を使わずに読むと、各台は深さ 9 の探索を値の範囲を限らずに行うので、各台の末端は深さ 9 の同じ式で 個、10 台の合計は 1,099,990 個(1 本の 5.5 倍)になる。時間は各台の 109,999 個で決まるので、10 台で 倍しか速くならない(読む順番が完全に良く、手の数がどこでも同じという仮定の下の計算)。
Edax は、各局面で最初の手を 1 本で読み、その値が分かってから残りの手を並列に読む方法(Young Brothers Wait Concept。src/ybwc.c の説明)を使う。手元の CPU で、FFO の終盤問題 40〜59 番の 20 問を、スレッドの数 1・2・4・8・16 で読み切らせた(Edax 4.7 の lEdax-x86-64-v3 -solve problem/fforum-40-59.obf -n <スレッド数>、2026-10-21、各 2 回)。第4章の 終盤は最後まで読める の Egaroucid のベンチマークは、同じ 20 問で Edax 4.5.5 が約 局面を調べたとしており、下の表の 1 スレッドの 22.7 億局面と約 12 倍違う。版・スレッドの数・局面の数え方の違いが考えられるが、理由は確かめていない。
| スレッドの数 | かかった時間(2 回の平均) | 速くなった倍率 | 調べた局面の数(2 回の平均) | 1 本のときに比べた局面の数 | 1 スレッドあたりの 1 秒の局面の数 |
|---|---|---|---|---|---|
| 1 | 67.67 秒 | 1.00 | 22.7 億 | 1.00 | 3,360 万 |
| 2 | 38.01 秒 | 1.78 | 25.0 億 | 1.10 | 3,280 万 |
| 4 | 21.81 秒 | 3.10 | 26.2 億 | 1.16 | 3,010 万 |
| 8 | 13.29 秒 | 5.09 | 27.9 億 | 1.23 | 2,620 万 |
| 16 | 11.95 秒 | 5.66 | 32.3 億 | 1.42 | 1,690 万 |
(四捨五入)
速くなった倍率は、スレッドの数 × 1 スレッドあたりの速さの比 ÷ 局面の数の比に等しい。8 スレッドでは (表の丸めた値での計算。丸める前の値では 5.09)で、8 倍に届かない分は、調べる局面が 23% 増えたことと、1 スレッドあたりの速さが 78% に落ちたことに分かれる。局面が増えるのは、上の計算のように、並列に読むと前の手の値を使えない枝が出るためと推測する(どの枝で増えたかは調べていない)。1 スレッドあたりの速さが落ちる理由は測っていないが、スレッドどうしの待ち合わせや、メモリとキャッシュの取り合いと推測する。1 スレッドの値が 2 回とも同じ 22.7 億局面だったのに対し、2 スレッド以上では 2 回で局面の数が違った(例:8 スレッドで 29.3 億と 26.4 億)。並列に読むと、どのスレッドが先に終わるかで省ける枝が変わるためと推測する(確かめていない)。
並列の数と速くなる倍率
この節では、上の 3 つの例を 1 枚の図で比べる。
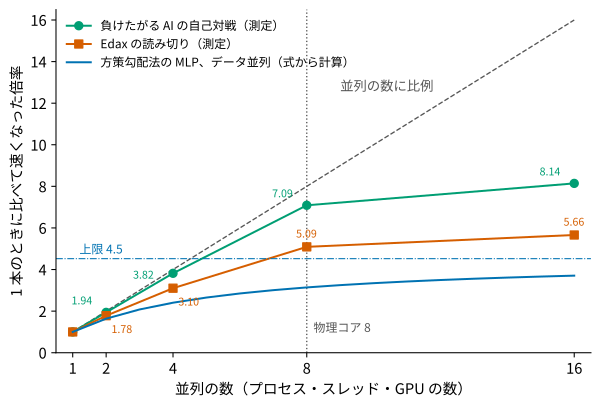
図4 横軸は並列の数、縦軸は 1 本のときに比べて速くなった倍率。灰色の破線は並列の数に比例する場合、灰色の点線は手元の CPU の物理コアの数 8。緑の丸は負けたがる AI の自己対戦(そのまま並列にできる仕事 の表)、橙の四角は Edax の読み切り(並列にしにくい仕事 の表)で、どちらも手元の CPU で測った値。青の実線は、方策勾配法の MLP の 局を GPU に等分した場合の 式(78) の計算(、測っていない)で、青の一点鎖線はその上限 4.5。緑は 4 までほぼ破線に沿い、8 で 7.09 倍、橙は 2 本目から破線を下回り、青は台を増やしても上限 4.5 に近づくだけである。並列にできるかどうかは、仕事どうしの依存と分けられない部分の割合で決まり、台の数だけでは決まらない。物理コアの点線は CPU で測った緑と橙にだけ関係し、GPU の計算の青には関係ない。緑の自己対戦は、プロセスの数ごとに乱数の種が違うので打った対局そのものは違うが、局数と局面の数(92,160)は同じである。
Colab での構成と費用
この節では、Colab で上の分け方のどれができるかと、このページの計算にかかった費用を、確かめた範囲で示す。
| 分け方 | Colab で | 理由 |
|---|---|---|
| データ並列 | 1 つのランタイムでは使えない | 2026-10-20 に借りた A100・L4・T4 のランタイムは、どれも GPU が 1 台だった(nvidia-smi と jax.devices() で確認)。ランタイムどうしを直接つなぐ方法は確かめていない |
| データを集める部分と学習する部分の分担 | 試していない | ランタイムを複数借り、パラメータと記録をファイルでやり取りすれば組めるはず(推測)。置き場には Colab CLI の upload・download か Google Drive が使える |
| そのまま並列(別々の実験) | できる | 2026-10-20 に L4 と T4 を同時に借り、2 つの学習を並行して動かした(colab sessions で 2 つのセッションを確認) |
借りた 3 つの Colab のランタイムはどれも GPU が 1 台だったので、1 つのマシンの中で複数の GPU をつなぐデータ並列をするには、Google Cloud の GCE で複数 GPU の VM(例:A100 を 2 枚積む a2-highgpu-2g)を借りることが考えられる(このページでは試していない)。1 GPU の VM の料金は Gemini のページ の表にあり、GPU を増やすと料金も増えると推測するが、複数 GPU の VM の料金は確かめていない。
Colab の計算ユニット(CU)は、GPU を接続している時間と機種に応じて減る。Gemini のページ の 1 時間あたりの消費(2026-03 に米国で利用者が測った参考値)は、T4 が 1.19、L4 が 1.71、A100 40GB が 5.40 である。この値で見積もると、このページの学習は、AlphaZero(L4 で 171.6 分)が CU、AlphaGo 方式(T4 で 32.5 + 24.0 + 17.9 = 74.4 分)が CU で、合わせて 6.37 CU になる。実際の残高の減りは、評価も含めて 7.25 CU だった(学習の結果)。差の 0.88 CU は、評価と、接続したまま待っていた時間の分と推測する(内訳は確かめていない)。
途中からの再開への備え
この節では、Colab のように途中で止まりうる計算機で長く計算するときの備えを示す。Colab は GPU の確保も連続実行の時間も保証しない(GPU のページ)。このページの学習スクリプトは、AlphaZero は 5 回の反復ごと(L4 で約 6 分ごと)、AlphaGo は 5 分ごとに、パラメータ・最適化の内部状態(Adam の 式(30) の )・学習の記録を 1 つのファイル(latest.pkl)に書き、同じコマンドで起動し直すとそこから続ける。乱数の状態は、AlphaZero は保存し、AlphaGo は保存せずに更新の番号から作り直す。書き込み途中で止まっても壊れないよう、別名で書き終えてから置きかえる。さらに、手元の PC が 10 分ごとにそのファイルを取り寄せるので、VM ごと消えても、失う学習は高々、保存の間隔と取り寄せの間隔を足した時間(AlphaZero で約 16 分、AlphaGo で約 15 分)分で、別の VM で再開できる。
手元の CPU で動かした計算も、止まったら続きから再開できるようにした。負けたがる AI の train.py は、世代ごとに対局(data_<g>.bin)と点数表(w_<g>.bin)をファイルに残し、起動し直すと、ファイルがある世代を飛ばす。league.py と eval_all.py は、1 組を打ち終えるたびに結果をファイルに書き、起動し直すと、書き終えた組を飛ばす。league.py と eval_all.py の 1 組は、そのまま並列にできる仕事 の 1 つ分である。互いに独立な仕事は、終わった分を残しておけば、止まった後に残りだけを計算すればよい。
第6章の確かめ問題
問6-1 方策勾配法の MLP の 局を 4 台の GPU に等分する。式(70) の 秒、 秒を使い、通信を無視したときの速くなる倍率を求めよ。次に、4 台を 1.25 GB/s の回線でつないだときの all-reduce の時間を 式(76) で求め、倍率がどれだけ変わるかを答えよ。
解答(問6-1)
1 台の時間は 秒。4 台では各台の計算が 秒なので、通信を無視すると 式(77) の倍率は 倍である(四捨五入)。分けられない割合 を丸める前の値(0.2212)のまま 式(78) に入れても で同じになる(0.221 に丸めてから入れると 2.41)。
all-reduce の時間は、式(76) に 、 バイト、 バイト毎秒を入れて 秒(0.63 ミリ秒)である。倍率は 倍で、通信で変わるのは約 0.02 である(丸める前の値で 2.405 から 2.387)。この例で倍率を決めているのは、通信ではなく分けられない部分 である。
問6-2 古い方策で打った 4 局の重要度の重み 式(81) が (2, 1, 0.5, 0.5) だった。有効な標本の数 式(83) を求めよ。また、重みが (3.97, 0.01, 0.01, 0.01) のときと (1, 1, 1, 1) のときも求め、値の意味を答えよ。
解答(問6-2)
(2, 1, 0.5, 0.5) では、重みの和は 4、2 乗の和は なので、(四捨五入)である。(3.97, 0.01, 0.01, 0.01) では和は 4、2 乗の和は で 、(1, 1, 1, 1) では である(重要度の重みは確率の比なので 0 にはならず、ほぼ 1 局だけが効く場合も 1 に近づくだけである)。
は、重みをかけた平均が、重みの等しい何局分の平均と同じばらつきになるかを表す(本文の 式(83) の後の説明)。(1, 1, 1, 1) は今の方策で打った場合と同じで 4 局すべてが効き、(3.97, 0.01, 0.01, 0.01) はほぼ 1 局だけで平均が決まる。(2, 1, 0.5, 0.5) は 4 局を打ったが、約 2.9 局分の情報しか無い。古いパラメータで集めたデータ の表で、遅れが 8 回分のとき 4,096 局の が 14〜61 局になったのは、この偏りが極端になった場合である。
確認できていない点
ここでは、このページで確かめていないことを挙げる。
- A100 で ・ にしたときの速さと学習の進み方。A100 は の1回しか走らせていない。
- 1.8倍の内訳(盤面の判定とネットワークの計算のどちらに時間がかかっているか)。
- A100 で に合わせて学習率を上げた場合に、学習が速くなるか。
- 乱数の種を変えたときの結果のばらつき。どの設定も1回ずつしか走らせていない。
- Edax の評価関数の点数表(
eval.dat)の値をどう決めたか(評価関数)。 - 手元の Pgx の基準モデルのファイルが、Pgx の論文の 100 回目の反復のモデルと同じか(Pgx の基準モデル)。
- 人間の値の換算の仮定(人間の値の換算):世界の値が 式(61) と同じ尺度であること、OLIVAW の論文の深さ 10 の Edax とこのページの深さの設定 10 の Edax が同じ意味・同じ強さであること、Borassi の 2019 年の強さが今の世界の値に当たること。OLIVAW の論文の図 5a(深さ 10 の Edax との 100 局)の数値も読み取っていない。O-1000 が、Edax との対局と Borassi との対局で同じ強さであることも仮定している。
- オセロの大会に出ない人と、このページの AI の強さの比較。対局させていない(1000 はどれくらいか)。
- Egaroucid の見積もり(レベル 21 で約 2430)の仮定:2 局 1 組の勝ち負けを 1 局と同じに扱えること(77.7 は大きめに出ている向きという推測も含む)、Egaroucid のベンチマークのレベル 21 とこのページの深さの設定 21 が同じ設定で、Edax 4.6 と 4.7 が同じ強さであること(結論と、ほかの AI との比較)。
- 段位とレーティングがずれる理由(段位の意味 の推測)。
- ブラウザの先読みと評価の実装の一致を、AlphaGo 方式と Pgx の基準モデルで確かめること(ブラウザで対戦するときの先読み)。
- Pgx の基準モデルが人の知識を使わずに学習したか、学習した打ち手に隅などの知識が身についたか(このページの打ち手との対比)。
- Egaroucid の今の版の評価関数の学習データ(2025-11-29 更新の解説は 18 億局面とも 32 億局面以上とも書き、学習データの頁には Edax との対戦棋譜も公開されている。Egaroucid の評価関数が学んだもの)。
- 大きな計算で学習した AlphaZero の方式のオセロ AI と、Edax・Egaroucid を同じ条件で比べた結果(αβ 探索と AlphaZero の方式のどちらが強いか)。
- 負けたがる AI と AVILEN の「最弱オセロ」の対局(未実施。負けたがる AI(Edax にならった作り))。
- 負けたがる AI の点数表の当てはめが 2 乗誤差の最小値まで届いたか。
- 負けたがる AI で、世代 5 が世代 0 に勝ったのが、局面を集めた打ち方と当てはめに使った局面の数のどちらの違いによるか。深さ 8・読み切り 20 が深さ 6・読み切り 18 に勝ったのが、深さと読み切る空きマスの数のどちらの効果か。点数表をすべて 0 にした AI の代わりに、読み切りより前を乱数で打つ版と比べた場合の結果。
- 負ける強さのレーティングの区間と、序盤を重ならないようにして打ち直した場合の値(負ける強さのレーティング)。
- 負けたがる AI の予想の誤差を、当てはめに使っていない対局で測った値(表の誤差は局面ごとに選んだ確かめ用の局面の値)。
- 自己対戦を 16 プロセスにしても 8.14 倍にとどまった理由(そのまま並列にできる仕事)。
- Edax の局面の数が Egaroucid のベンチマークの値と約 12 倍違う理由(並列にしにくい仕事)。
- 複数の GPU でのデータ並列の実測。このページの並列の章の GPU の値(式(76)〜式(78) による速さ、all-reduce の時間)はすべて式からの計算で、回線の速さも公称値である。式(70) が より少ない局数でも成り立つかも確かめていない。
- AlphaZero の 1 回の反復のうち、自己対戦と学習が占める時間(91.7% は評価の回数からの見積もり)。メモリを何が使っていたか(モデル並列とパイプライン並列が要るとき)。
- 重要度の重みの測定(古いパラメータで集めたデータ)は、手元の CPU で 32 回更新した 1 回の学習の値で、乱数の種を変えたくり返しはしていない。V-trace は実装していない。
- Edax のスレッド数を変えた測定と、自己対戦のプロセス数を変えた測定は、手元でほかのプロセスが動いている中で各 2 回測った値である。1 スレッドあたりの速さが落ちた理由(待ち合わせ、キャッシュの取り合いなど)は測っていない。
- Colab の CU の内訳(Colab での構成と費用 の 6.37 CU は参考の消費率からの見積もり)。Colab で自己対戦と学習を別のランタイムに分ける作りと、ランタイムどうしを直接つなぐ方法(試していない)。