概要
グラフニューラルネットワーク(Graph Neural Network、以下 GNN)は、グラフの各頂点にベクトル(数の並び)を持たせ、「各頂点が、隣の頂点のベクトルを集めて自分のベクトルを計算し直す」操作(1回分を層と呼ぶ)を決まった回数くり返し、最後のベクトルから頂点・辺・グラフ全体についての予測を出す関数である。計算し直すときに掛ける数(重み。このページの GNN では層ごとに別の重みを使う)は、正解の分かっている例から勾配降下法で決める。このページは、GNN で何が予測できるか、1回の計算し直しがどんな式か、重みをどう学習するか、どんな限界があるかを、式と小さな実例で示す。
読者は、グラフの用語(頂点・辺・隣接・次数・距離・幅優先探索)は知っているが、ニューラルネットワークとその学習の数学は知らない人を想定する。ニューラルネットワークの部品も、このページの中で定義してから使う。
読む順路は次のとおり。
- GNN で何ができるか:入力と出力の形、使われている例、よくある誤解。
- 記号とニューラルネットワークの部品:以下で使う文字と、全結合層・活性化関数。
- GNN の層:隣の平均をとる層を定義し、数値例で計算する。層を重ねたときにどこまでの頂点の情報が届くかもここで示す。
- 出力と学習:最後のベクトルから予測を作る式、損失、勾配降下法、頂点が多いときの学習の工夫。
- 例:空手クラブの分裂:34 頂点のグラフで、2 頂点だけ正解を教えて残り 32 頂点を当てる学習を実際に動かした結果。
- 層の選択肢:3 で定義した層と同じく隣から集めて計算し直す、よく知られた4つの層(GCN・GraphSAGE・GAT・GIN)と、その比較。
- GNN の限界:区別できないグラフがあること(グラフの頂点を色で分ける手続きとの比較)と、連結なグラフで隣との平均をくり返すと全頂点の値がそろうこと(過平滑化)。
- 確かめ問題、確認できていない点、参考。
GNN で何ができるか
この章では、GNN に何を入れて何を出させるのかを、式を使わずに示す。式による定義は記号の章から始める。
予測する対象
GNN の入力は、1つのグラフと、各頂点に付いたベクトル(以下、頂点の特徴)である。頂点の特徴は、その頂点について分かっている数を並べたもので、例えば分子なら原子の種類を表す数、論文なら本文に出てくる単語の有無を並べたものである。出力は、何について予測するかによって次の3種類がある。
| 予測する対象 | 入力のグラフの例 | 出力の例 |
|---|---|---|
| 頂点ごと | 論文の引用関係(頂点が論文、辺が引用) | 各論文の分野 |
| 辺ごと | 利用者と商品(頂点が利用者と商品、辺が購入) | まだ辺の無い組(利用者, 商品)が将来辺になるかどうか、つまり買いそうな商品 |
| グラフ全体 | 分子(頂点が原子、辺が結合) | その分子の性質(溶けやすさ、毒性の有無など) |
このページでは、辺には特徴が無い(辺があるかないかだけが分かる)場合を扱う。分子の結合の種類のように、辺に付いた特徴も使う層もある。どの場合も、GNN の中で行う計算は同じで、各頂点のベクトルを計算し直すことである。違いは最後に予測を取り出す場所だけで、その式は出力の作り方で示す。
実際に使われている例(原論文)
arXiv の題名・著者・概要で確かめた(2026-10-21。確認できていない点)。
- 分子の性質の予測:Gilmer ほか「Neural Message Passing for Quantum Chemistry」(arXiv:1704.01212、ICML 2017)。既存のモデルを、隣との間で情報を受け渡す形(メッセージパッシング。このページのメッセージパッシング型を、辺の特徴も使えるように広げたもの)にまとめ、分子の性質の予測のベンチマーク(手法を比べるための共通のデータと評価方法)で当時最も良い結果を出した。
- 推薦:Ying ほか「Graph Convolutional Neural Networks for Web-Scale Recommender Systems」(arXiv:1806.01973、KDD 2018)。Pinterest に導入し、ピンとボードを表す 30 億頂点・180 億辺のグラフで学習した。
- 到着時刻の予測:Derrow-Pinion ほか「ETA Prediction with Graph Neural Networks in Google Maps」(arXiv:2108.11482、CIKM 2021)。Google Maps の到着予想時刻の計算に GNN を導入した。
よくある誤解
この節では、GNN について持たれやすい誤解を先に挙げる。中央の列の内容は、右の列の節で式や例で確かめる。
| 誤解 | 実際 | 確かめる節 |
|---|---|---|
| 辺の有無を表す の表(隣接行列)を1列の数の並びにして、数の並びを受け取るよくある機械学習の関数に入れればよい | それをすると、一般には、頂点の番号の付け方を変えただけで出力が変わる。GNN は、番号を付けかえても頂点ごとの出力が同じように並べ替わるだけの計算を使う | 番号の付けかえ |
| 頂点ごとに別々の重み(学習で決める数)を学習する | 全頂点が同じ重みを使う。そのため重みの数は、頂点の特徴の次元が頂点の数によらない限り、頂点の数によらず、大きさの違う別のグラフにも同じ重みを使える。ただし空手クラブの例のように、頂点の特徴を頂点ごとの番号を表すベクトルにすると、1層目は実質的に頂点ごとに別の重みになる | 平均による層 |
| 層を増やすほど遠くまで見えるので良くなる | 遠くまで見えるようになる一方で、計算を隣との平均をとることだけにして何回もくり返すと、連結なグラフでは全頂点の値が1つの値に近づく(このページで証明する)。重みなどを含む場合にどうなるかは、このページでは示していない | 過平滑化 |
| 2つのグラフが同じ形(同型。頂点の番号を付けかえると辺の集合が一致すること)かどうかを必ず見分けられる | 見分けられない組がある。例えば全頂点の特徴が等しいとき、6 頂点の閉路のグラフと三角形 2 つからなるグラフに、このページで扱う GNN は同じ出力を出す | 区別できないグラフ |
記号
この章では、このページ全体で使う記号を決める。章の途中で新しい記号を足すときは、その場で定義する。
グラフ
- グラフを と書く。 は頂点の集合、 は辺の集合である。辺に向きは無いものとし、辺は2頂点の組 で表す。自分自身への辺と、同じ2頂点の間の2本以上の辺は無いものとする。
- 頂点の数を とし、頂点に の番号を付ける。以下、頂点 と書いたら である。
- 頂点 に隣接する頂点の集合を 、次数を とする。
- 自分を含めた隣の集合を 、その大きさを とする。このページの層の多くは、頂点が自分のベクトルも一緒に集めるので、この記号を使う。
- 頂点の数が同じ2つのグラフが同型であるとは、一方の頂点の番号を付けかえると、辺の集合が他方と一致することをいう。
- 隣接行列 は の行列で、 なら 、そうでなければ 0 とする。単位行列を とし、(自分への辺を足した隣接行列)、 を対角成分が の対角行列とする。
頂点のベクトル
- このページでは、ベクトルは横に並べた行ベクトル( の行列)とし、ベクトルに行列を掛けるときは右から掛ける。例えば である。行列どうしの積は普通の行列の積で、左から掛けることもある。全成分が 1 の列ベクトル 、過平滑化の節の ・・ は例外として列ベクトルで、使う場所でもそう断る。 は、1変数の関数を定義するときの実数の変数として、場所ごとに使う。ベクトル のノルム は、成分の2乗の和の平方根である。
- 頂点 の特徴を ( 次元の行ベクトル)とし、 を上から順に積んだ の行列を とする。
- GNN の層の数を とする。頂点 の入力を とし、 について、 番目の層の出力を ( 次元の行ベクトル)と書く。 番目の層は全頂点の から を作り、その層の重み(学習で決める数。全結合層で定義する)にも添字 を付ける。 を積んだ の行列を とする。
- 色は次の量に付け、同じ量にはいつも同じ色を使う。頂点のベクトル は青、隣から集めたベクトル (平均による層で定義する)は橙、学習で決める重みの行列 は緑である。学習で決める数でも、行列でないものには色を付けない。特徴 と は ・ と同じ量だが、入力であることが分かるように色を付けずに書く。図の色は、図ごとの説明に従う。
ニューラルネットワークの部品
この章では、GNN の部品になる「全結合層」と「活性化関数」を定義する。ニューラルネットワークは、このような層をつないだ関数の総称で、GNN もその一種である。GNN の層は、この部品の前に「隣から集める」計算を足したものである。
全結合層
全結合層は、 次元の行ベクトル を、 次元の行ベクトルに変える次の関数である。 は の行列、 は 次元の行ベクトル、 は活性化関数(次の節で定義する)である。
と の成分が学習で決める数で、これをまとめて重みと呼ぶ。 だけを区別してバイアスと呼ぶこともある。 を恒等関数()にしたもの、つまり も全結合層と呼ぶ。全結合層を、活性化関数を挟んで2個以上つないだ関数を多層パーセプトロン(Multi-Layer Perceptron、MLP)と呼ぶ。
活性化関数
活性化関数 は、ベクトルの各成分に別々に当てる1変数の関数である。このページでは主に ReLU を使う。
ベクトルに当てるときは とする。
活性化関数を入れる理由は、入れないと層を何個つないでも1個の全結合層と同じ形の関数にしかならず、表せる関数が増えないからである。 を恒等関数にして、重み の層と重み の層をつなぐと、 となり、行列 とバイアス を持つ1個の層と等しい。1個の層( が恒等関数)は、入力の線形関数に定数を足した関数である。ReLU を挟むと、そうでない関数も表せる。例えば 1 次元で、行列 ・バイアス 0 の層に ReLU を当て、行列 ・バイアス 0 の層をつなぐと になる。 が線形関数に定数を足した形なら、 と での値の和は、 での値の2倍に等しいはずだが、実際は 、 で等しくない。
GNN の層
この章では、このページで最初に扱う GNN の層(隣の平均をとる層)を定義し、それが満たすべき性質と、層を重ねたときにどこまでの頂点の情報が届くかを示す。読む順は、番号の付けかえ(満たすべき性質)、平均による層(定義)、数値例、層を重ねたときに届く範囲である。よく知られたほかの層は、この層との違いを示しながら層の選択肢で扱う。
番号の付けかえ
この節では、GNN の層が満たすべき性質を決める。頂点の番号は人が便宜上付けたもので、同じグラフに別の番号を付けても、各頂点についての予測は変わってはならない。
番号の付けかえを、 から への1対1の対応 で表す。古い番号 の頂点が新しい番号 になる。これを行列で書くため、 の行列 を、()、ほかの成分を 0 と定義する。 を左から掛けると行が並べ替わり、 の 行目は の 行目になる。付けかえた後のグラフの隣接行列 と特徴 は、次のとおりである( は の転置)。
式(3) の左は、成分で書くと ( が 0 でないのは のときだけ)で、古い番号で が隣接することと、新しい番号で が隣接することが同じであることを行列で書いたものである。
グラフと特徴から全頂点の出力( 行の行列)を作る関数 が番号の付けかえと両立する(番号を付けかえると、出力の行も同じように並べ替わるだけである)とは、次が成り立つことである。
式(4) の右辺は、元の番号で計算した出力の行を、新しい番号の順に並べ替えたものである。つまり、どの番号で計算しても、同じ頂点には同じ出力が付く。
隣接行列の 個の成分を1列に並べ、 個の数(頂点ごとの出力)を返す全結合層に入れる方法は、一般に 式(4) を満たさない。全結合層は入力の成分ごとに別の重みを掛けるので、番号を付けかえると同じ辺に別の重みが掛かるからである。例えば で、頂点 1 の出力を(説明のための数 を使って) とし、、ほかの とする。辺が だけのグラフでは頂点 1 の出力は 1 だが、番号 2 と 3 を入れかえる(、、)と辺は になり、頂点 1 の出力は 0 になる。頂点 1 の番号は変わっていないので、式(4) なら出力は等しくなければならない。さらに、頂点の数 が違うグラフには入力の次元が合わないので使えない。次の節の層は、全頂点に同じ重みを使い、隣を区別せずに集めることで 式(4) を満たす。
平均による層
この節では、式(4) を満たす層のうち、このページで土台にする層を定義する。各頂点は、自分と隣の頂点のベクトルの平均をとり、それを全結合層 式(1) に入れる。
は の行列、 は 次元の行ベクトルで、どちらも層ごとに1つずつあり、全頂点で同じものを使う。そのため重みの数は で、頂点の数 によらない。頂点の数が違う別のグラフにも、同じ重みでそのまま 式(5) と 式(6) を計算できる。ただし は特徴の次元なので、特徴の作り方によっては に依存する(空手クラブの例の特徴)。
式(5) と 式(6) を全頂点まとめて行列で書く。平均をとる行列を
と定義すると、 で、これは なら 、そうでなければ 0 である。よって、 を積んだ行列を とすると、 の 行目は (式(5))なので となり、式(6) は次の1行にまとまる。 は全成分が 1 の 次元の列ベクトルで、 は を 行積んだ行列である。
この層が 式(4) を満たすことの証明は、次の折りたたみにある。
詳しくはこちら(式(8) の層が番号の付けかえと両立することの証明)
は各行・各列に 1 がちょうど1つある行列で、 である。 列目の 1 は 行目だけにあるので、 で、これが 1 なのは 、つまり が1対1なので のときだけである。同様に、 行目の 1 は 列目だけにあるので、 で、これが 1 なのは 、つまり のときだけである。
付けかえた後の、自分への辺を足した隣接行列は である。付けかえても各頂点の は変わらず、その値が番号 の位置に移るだけなので、付けかえた後の を並べた対角行列は で(式(3) の後と同じ成分の計算で、)、その逆行列は である( で確かめられる)。よって、真ん中の を消して
である。以下この証明では、添字 を省いて ・・ と書く。式(8) の括弧の中に、付けかえた後の と を入れ、式(9) と を使うと、
となる。 は、 の成分を並べ替えても全部 1 のままだからである。 は成分ごとに当てるので、行を並べ替えてから当てても、当ててから並べ替えても同じである。よって、付けかえた後の層の出力は で、1層について 式(4) が成り立つ。層を重ねた場合は、各層の入力が で並べ替わっていれば出力も で並べ替わることを、1層目から順に当てはめればよい。
数値例
この節では、式(5) と 式(6) を、4 頂点のグラフで1回計算する。辺は 、特徴は 2 次元で 、、、 とする。重みは説明のために次の値に決め、、 とする。
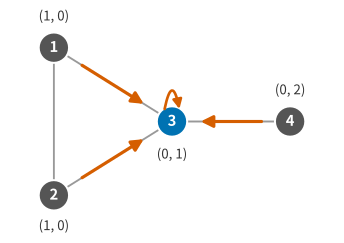
図1 4 頂点の例のグラフ。灰色の線が辺、各頂点の上か下にある組が特徴 である。橙の矢印は、頂点 3(青)が 式(5) で集めるベクトルの出どころで、隣の頂点 1・2・4(灰色)と、頂点 3 自身(頂点 3 の上の輪の矢印)から来る。頂点 1・2・4 も、それぞれの隣から同時に同じ計算をする。
頂点 3 では 、 なので、式(5) から
である。式(12) に 式(11) の重みを掛けると で、ReLU(式(2))で負の成分が 0 になり となる。4 頂点すべての値は次の表のとおりである(列は左から、頂点 、、、、)。
| 頂点 | 自分を含む隣の数 | 集めた平均 | 重みを掛けた値 | 層の出力 |
|---|---|---|---|---|
| 1 | 3 | (2/3, 1/3) | (1/3, −1/3) | (1/3, 0) |
| 2 | 3 | (2/3, 1/3) | (1/3, −1/3) | (1/3, 0) |
| 3 | 4 | (1/2, 3/4) | (−1/4, 1/4) | (0, 1/4) |
| 4 | 2 | (0, 3/2) | (−3/2, 3/2) | (0, 3/2) |
頂点 1 と 2 は、特徴が同じで、隣の集まり と も同じなので、同じ出力になる。
層を重ねたときに届く範囲
この節では、層を 個重ねたとき、頂点 の出力 にどの頂点の特徴が影響しうるかを示す。結論は、 から距離が より大きい頂点の特徴を変えても、 は変わらないことである(距離は辺の本数で数えた最短路の長さ)。
についての帰納法で、「 は、 から距離 以下の頂点の特徴と、グラフの辺と、重みだけで決まる」ことを示す。 では で成り立つ。 で成り立つとする。式(5) と 式(6) より、 は の と と重みで決まり、各 は から距離 以下の頂点 の特徴で決まる。そのような と の距離は、 から までの 1 以下と、 から までの 以下を足して 以下である。
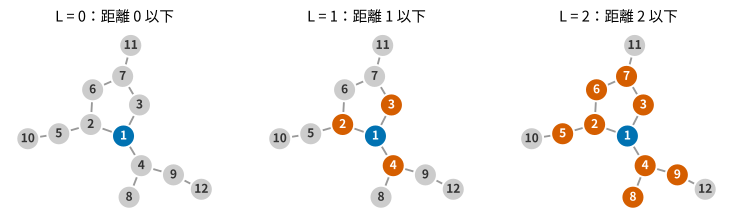
図2 12 頂点のグラフで、頂点 1 の出力 に特徴が影響しうる頂点を、頂点 1 自身(青)とそれ以外(橙)に分けて、 について塗った。薄い灰色は影響しない頂点である。 が 1 増えるごとに、塗られる範囲が距離 1 ずつ広がる。これは頂点 1 から幅優先探索をしたときの、深さ までに訪れる頂点と同じである。
この結果から、層が 個の GNN は、距離が 以上離れた頂点の特徴を使えない(ここでは平均による層について示したが、後の層の選択肢の層も、1層で自分と隣だけを使うので、同じ帰納法で同じことが言える)。遠くの情報が要る問題では層を増やす必要があるが、連結なグラフで隣との平均だけをくり返すと全頂点の値がそろうことを、後の過平滑化で示す。
出力と学習
この章では、最後の層の出力から予測を作る式、予測の悪さを測る損失、損失を小さくするように重みを直す勾配降下法を定義する。読む順は、出力の作り方、損失、勾配降下法、誤差逆伝播法、大きなグラフでの学習である。
出力の作り方
この節では、予測する対象の3種類それぞれについて、 から予測を作る式を示す。
頂点ごとの分類。 頂点を 個のクラス のどれかに分ける問題では、最後の層の次元を にする。最後の層の出力を、確率に変える前の値であることが分かるように とも書き(同じ量なので同じ青)、その成分を次の softmax 関数で確率に変える。
式(13) の は、頂点 がクラス である確率として使う。どれも正で、 について足すと 1 になるからである。予測するクラスは、 が最大の とする。最後の層では を恒等関数にする(ReLU を当てない)。活性化関数は、その後に層が続くとき、後の層と組み合わせて表せる関数を線形でないものに広げるために入れる(活性化関数)が、最後の層の後に層は無いので、この働きが無いからである。ReLU を当てると学習が止まりうるという理由もあり、それは学習を定義した後の誤差逆伝播法の節の終わりに書く。
辺ごとの予測。 方法の一例として、最後の層の を恒等関数にして(ReLU を当てると出力の成分が 0 以上になり、次の内積も 0 以上で となって「辺が無い」を予測できない)、頂点 の間に辺がある(あるいは将来できる)確率を、2つの出力の内積(対応する成分の積の和) をシグモイド関数 に入れた値とする。シグモイド関数は実数を 0 と 1 の間に移す増加関数である。2つのベクトルのノルムを決めたとき、内積は向きがそろうほど大きい。
グラフ全体の予測。 全頂点の出力を足して1つのベクトル にし、それを全結合層に入れる。 は頂点のベクトルではないので色を付けない。
式(15) の和は足す順番によらないので、番号を付けかえても の値そのものが変わらない(頂点ごとの出力は並べ替わるが、グラフ全体の出力は1つなので並べ替わるものが無い)。足す代わりに平均や成分ごとの最大値をとることもある。次に、 に、 を恒等関数にした全結合層 式(1)(理由は頂点ごとの分類と同じ)を当てて 次元にし、式(13) と同じ softmax でグラフのクラスの確率にする。グラフ全体の予測では、GNN の最後の層の後にこの全結合層が続くので、GNN の最後の層には を当ててよい。
損失
この節では、頂点の分類について、予測の悪さを1つの数で表す損失を定義する。正解のクラス が分かっている頂点の集合を (訓練用の頂点)とする。 が の一部だけでもよい。重みの成分をすべて1列に並べたベクトルを と書く。
式(16) を交差エントロピー損失と呼ぶ( は自然対数)。 は正解のクラスに付けた確率で、 なので である。正解に付けた確率が 1 に近いほど は 0 に近づき、0 に近いほど大きくなる。また、 のすべての頂点 についての の積を とすると、対数の和は積の対数なので で、 を小さくすることは を大きくすることと同じである。 は、各頂点のクラスを確率 に従って互いに独立に抽選したとき、訓練用の頂点が全部正解のクラスになる確率である。
辺の予測では、辺がある組(正例)と無い組(負例。辺の無い組から選ぶ。選び方と数はこのページでは扱わない)を集め、正例では 、負例では を平均する(式(14))。グラフの分類では、式(16) の頂点をグラフに置きかえる。
勾配降下法
この節では、式(16) を小さくする重み を探す方法を示す。 を、損失の勾配 ( を の各成分で偏微分した値を、 と同じ順に並べたベクトル)の逆向きに少し動かすことをくり返す。 は1回に動かす大きさを決める数で、学習率と呼ぶ。
式(17) で が小さくなる理由は、1次のテイラー展開にある。以下、 は の近くで2回連続微分できるとする(ReLU を含む は、ReLU の前の値が 0 になる点の近くではこれを満たさない。そのような点での勾配の計算のしかただけを、この節の終わりに書く)。 と勾配は同じ長さのベクトルで、 は2つのベクトルの内積(対応する成分の積の和)である。 とおくと、 の についての1次のテイラー展開の1次の項は なので、 が十分小さいとき
となる。 は、 のとき、絶対値が、ある定数と の積で上から抑えられる項を表す。 なら右辺の第2項が負なので、 を小さくとれば は減る。 が大きすぎると の項が効いて増えることもあるので、 は試して決める。式(18) は多変数のテイラーの定理による(剰余項は、2回微分の行列(ヘッセ行列)が の近くで有界なら、定数と の積で抑えられる)。勾配がどれだけ急に変わりうるかの上限(リプシッツ定数。下の折りたたみで定義する)が分かれば、 が減る の範囲の1つが分かる。ただし 式(17) は、 が十分小さければ1回ごとに を減らすが、 をそれ以上下げられない点に着く保証は無い。式(17) の更新は勾配が 0 になる点に着けばそこで止まり、 が凸関数(どの2点を結ぶ線分の上でも、関数の値が両端の値を結ぶ線分より上に出ない関数)でなければ、そのような点で が最も小さいとは限らない。凸でない の例は、後の空手クラブの例の結果の後で示す。ReLU は で微分できないので、ReLU の前の値のどれかがちょうど 0 になる では、 が微分できないことがある。Python の機械学習ライブラリ PyTorch は、そこでの ReLU の微分を 0 として計算する(PyTorch 2.10 で torch.relu の 0 での勾配が 0 になることを確かめた。2026-10-21)。
詳しくはこちら(減る学習率の範囲)
ある定数 があって、すべての で (勾配がリプシッツ連続)とする。 とおくと、微分積分学の基本定理と合成関数の微分より である。(コーシー・シュワルツの不等式とリプシッツ連続)なので、
である。よって で なら は減る。ReLU を含む GNN の は、ReLU の折れ目で勾配が飛び、重みどうしの積も含むので、一般にはこの条件を満たさない。そのため実際には は試して決める。
誤差逆伝播法
この節では、勾配降下法で使う勾配の求め方を示す。勾配は、合成関数の微分(連鎖律)を出力側から入力側へ順にたどって求める。この計算を誤差逆伝播法と呼び、PyTorch などは、式(5)〜式(16) のような計算を書くと勾配を自動で求める。まず、出力側の端にある についての勾配は次の形になる。
は なら 1、そうでなければ 0 である。式(20) は、 を直接動かせるとしたとき、 を減らす向き(式(20) の逆向き)が、正解のクラスの を上げ、ほかのクラスの を付けた確率に比例して下げる向きであることを表す。実際に動かすのは重み で、 の動きはこの向きと一致するとは限らない。
詳しくはこちら(式(20) の導出)
の は 式(16) に現れないので、偏微分は 0 である。 について、式(13) の対数をとると
である。式(21) を で偏微分すると、第1項は 、第2項は (式(13))なので、 である。式(16) で を含む項は だけなので、これに を掛けて 式(20) を得る。
式(20) から入力側へたどると、重みの勾配が求まる。ここでは 2 層の平均による層(バイアスなし)の場合を示す。この 2 層の GNN は、式(8) でバイアスを 0 にして次のように書ける。 は1層目の ReLU の前の値、(式(8) の前で示したとおり を積んだ行列)、 は を積んだ の行列である。
行列 についての偏微分 は、 と同じ大きさの行列で、 成分が のものとする。式(20) の値を並べた の行列 を とする。 を成分ごとの積、 を、 の成分が正なら 1、そうでなければ 0 を並べた行列とする。重みの勾配は次のとおりである(導出は下の折りたたみ)。
式(23) で が掛かるところに注目する。行列 の 行目を と書く。 は 式(20) より訓練用の頂点の行以外は 0 である。 で、 は のときだけなので、 と は、訓練用の頂点から距離 1 以下の頂点の行だけが 0 でなくなりうる。式(23) が PyTorch の自動の計算と一致することを、空手クラブの例の大きさで確かめた(参考のプログラムの出力 grad_check)。
詳しくはこちら(式(23) の導出)
行列の積の偏微分には次の2つの形を使う。 は一般の行列である。
- 右から掛ける積 では、 なので、合成関数の微分(連鎖律)から 、 である。行列で書くと 、。
- 左から掛ける積 では、 なので、、行列で書くと 。
ReLU は前の値が正なら値をそのまま通し(微分 1)、そうでなければ 0 にする(微分 0)。式(22) に出力側から1段ずつ当てる。
- に右から掛ける積の形を当てる()と、、。
- に左から掛ける積の形を当てる(、)と、。
- ReLU は成分ごとなので、。
- に右から掛ける積の形を当てる()と、。
1〜4 をまとめたもの( は 2・3 の結果)が 式(23) である。
訓練用でない頂点は、次の2つの形で学習に関わる。1つは、訓練用の頂点の出力が、層を重ねたときに届く範囲で示したとおり距離 以下の頂点の特徴から計算されるので、訓練用でない頂点の特徴も重みの勾配に入ること(式(23) の ・・ を通して入る)。もう1つは、訓練用でない頂点の予測も、学習した同じ重みで 式(8) から計算されること。訓練用でない頂点の正解は使わない。使うのはその頂点の特徴とグラフの辺だけである。
出力の作り方で、最後の層に ReLU を当てない理由のもう1つをここで示す。最後の層に ReLU を当てると、ある頂点で ReLU を当てる前の値の全成分が負になったとき、 の全成分が 0 になって となる。このとき ReLU の傾きは 0 なので、重みを少し変えても は 0 のまま変わらず、その頂点の項の勾配は 0 になって、その頂点の損失を減らす向きに重みを動かせなくなる。
大きなグラフでの学習
この節では、頂点の数が多いグラフで 式(17) の1回の計算に要るメモリと計算が大きくなる理由と、その対処を示す。式(8) のように全頂点を一度に計算すると、全頂点の を各層で計算機のメモリに置く必要があり、計算機のメモリには上限があるのに、メモリの量が頂点の数 に比例して増える( を持つための、辺の数に比例する量も要る)。重みの勾配の計算(式(23) の や )に各層の値を使うからである。1回の更新で 式(16) の和を訓練用の頂点の一部(ミニバッチと呼ぶ)だけでとり、その勾配で 式(17) を行う方法もあるが、そうしても、層を重ねたときに届く範囲より、選んだ頂点から距離 以下の頂点はすべて計算に要る。最大次数が のとき、1つの頂点から距離 以下の頂点の数は最大で 個である(幅優先探索で、距離 1 の頂点は 個以下、そこから先は、各頂点から来た辺を除く 本以下の辺で新しい頂点に進むから)。、 では 個で、この上限は について指数的に増える(実際の数は頂点の数 を超えない)。
そこで、各層で隣の頂点を全部使わず、決めた数 個だけをランダムに選んで平均をとる方法がある。Hamilton らが 2017 年の論文で使った方法で、その論文の層は後の GraphSAGE の節で扱う。こうすると1頂点あたりに要る頂点は最大 個に抑えられる。選ぶ隣が毎回変わるので、式(17) で使う勾配は、全部の隣を使ったときの値とずれる。このずれが学習の結果にどう効くかは、このページでは扱わない。
例:空手クラブの分裂
この章では、ここまでの式を実際のグラフで動かし、2 頂点にだけ正解を教えて、残りの頂点のクラスを当てる。前章の誤差逆伝播法で(式(23) の後に)述べた、訓練用でない頂点が学習に関わる仕組みが、この例でどう働くかも示す。読む順は、データと問題、設定、結果、訓練用でない頂点の重みの勾配、ほかの方法との比較である。
データと問題
使うのは、Zachary が 1977 年の論文で記録した、ある大学の空手クラブの会員のうち 34 人の交友関係のグラフである(Python のライブラリ NetworkX の karate_club_graph()。辺に付いた数(weight)は使わない)。頂点が会員、辺がクラブの外でも交流のあった2人の組で、辺は 78 本ある。このクラブは、指導者(以下 Mr. Hi、頂点 1)と運営者(以下 Officer、頂点 34)の対立で2つに分かれ、各会員がどちらに付いたかが記録されている(NetworkX の頂点の属性 club。それぞれ 17 人)。NetworkX は頂点を 0〜33 で数えるので、このページの番号は NetworkX の番号に 1 を足したものである。
問題は、頂点 1 が Mr. Hi 側、頂点 34 が Officer 側であることだけを教え()、残り 32 人がどちらに付いたかを当てることである。クラス 1 を Mr. Hi 側、クラス 2 を Officer 側とする()。
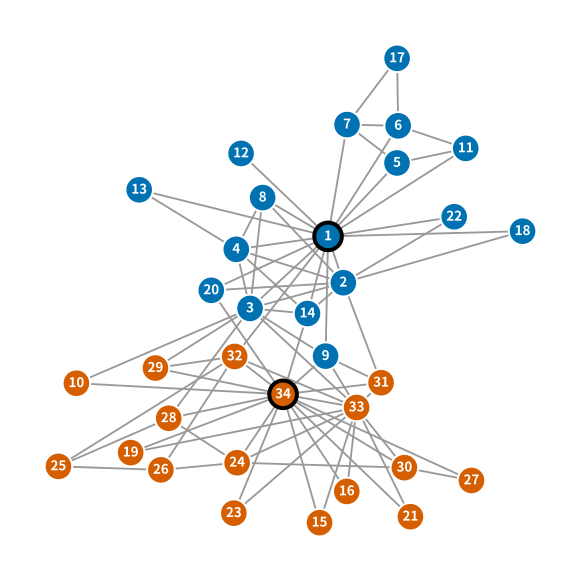
図3 空手クラブのグラフ。色は実際に分かれた先(青が Mr. Hi 側、橙が Officer 側)で、黒い太枠が正解を教えた頂点 1 と 34 である。頂点の配置は NetworkX の spring_layout で計算し、頂点が他の辺の上に乗らないように動かしたもの(座標は参考のプログラムに書いてある)で、学習には使っていない。
設定
この節では、学習させた GNN の形と学習の条件を示す。
- 頂点の特徴:(34×34 の単位行列)。頂点 の特徴は、 番目の成分だけが 1 で残りが 0 の 34 次元のベクトルで、会員についての情報は何も入っていない。頼れるのはグラフの形だけである。この特徴では、1層目の重み の 行目が頂点 の特徴にだけ掛かるので、実質的に頂点ごとに別の重みを持つことになる(訓練用でない頂点の重みの勾配)。
- 層:式(8) の平均による層を 2 個()。次元は 、、。1層目は 、2層目は を恒等関数にする(出力の作り方)。バイアスは使わない。重みの数は である。
- 重みの初期値:各行列の成分を、 以上 以下の一様乱数で決める。 は行列ごとに とする(Glorot と Bengio が 2010 年の論文で提案した範囲)。乱数にするのは、成分をそろえると学習が進まない場合があるからである。例えば の 16 列がすべて等しく、 の 16 行がすべて等しいと、式(22) で1層目の 16 個の成分は常に等しく、式(23) の勾配も 16 列(行)で等しくなる( の 16 列が等しいので の 16 列も等しく、 の行が等しいので の 16 列が等しく、 の列が等しいので の行が等しい)ので、式(17) で更新しても等しいままで、16 個あっても 1 個と同じ働きしかしない。全部 0 のときは、式(23) で から 、 となり、 から 、 となって、重みが少しも動かない(行列のノルムを成分の2乗の和の平方根とすると、積のノルムはノルムの積以下で、 なので、 である。 は について傾きが有界な関数(式(20) より、各成分についての傾きの絶対値は 以下)で、(各因子は 以下)なので、 は の定数倍で抑えられ、 で は微分でき、勾配は ReLU の 0 での微分の決め方によらず 0 である)。
- 学習:式(16) の損失で、式(17) の更新を学習率 で 1000 回くり返す。初期値の乱数の種を 0〜99 に変えて、この学習を 100 通り行った(以下、1 通りを1試行と呼ぶ)。1層目の次元 16・学習率 0.2・1000 回は、100 試行すべてで頂点 1 と 34 が当たり、最後の損失が 0.01 未満になるように試して決めた(実際の最大は次の箇条の 0.0042)(1層目の次元 4・学習率 0.2・200 回では、100 試行のうち 21 試行で頂点 1 と 34 の予測が同じクラスになった)。
- 評価:1000 回の更新の後、訓練用でない 32 頂点のうち、式(13) の確率が大きい方のクラスが実際と一致した頂点の数(以下、当たった数)を数える。頂点 1 と 34 を数えないのは、この2頂点は損失 式(16) を小さくする学習で直接合わせられるからである。実際、100 試行のすべてで、頂点 1 と 34 は正しく予測され、最後の損失は 0.0042 以下だった。
結果
この節では、1 試行の経過と予測を示し、次に 100 試行の分布を示す。学習前(初期値のまま)の当たった数は、100 試行の平均で 32 頂点中 16.19 頂点で、半分の 16 に近い。1 試行の例には、学習前は全員を同じ側と予測している(そのため当たった数は Mr. Hi 側の 16 か Officer 側の 16 になる)試行を選ぶため、学習前に全員を同じ側と予測し、最後に 100 試行で最も多かった結果(31 頂点)になった試行のうち、乱数の種が最も小さいもの(種 8)を選んだ。
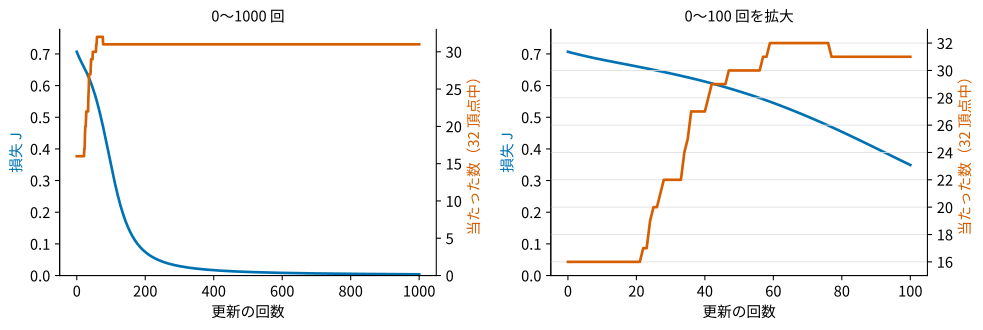
図4 種 8 の試行での、更新の回数に対する損失 (青、左の目盛り、式(16))と、訓練用でない 32 頂点のうち当たった数(橙、右の目盛り)。左は 1000 回すべて、右は 0〜100 回を拡大したもの。損失は 0.707 から 0.0038 まで下がり、当たった数は 16 から 31 に増えた。当たった数は 22 回目から増え始め、47 回目で 30、57 回目で 31 になり、59 回目から 76 回目までは 32(全頂点)だったが、77 回目に 31 に戻り、その後は変わらなかった。
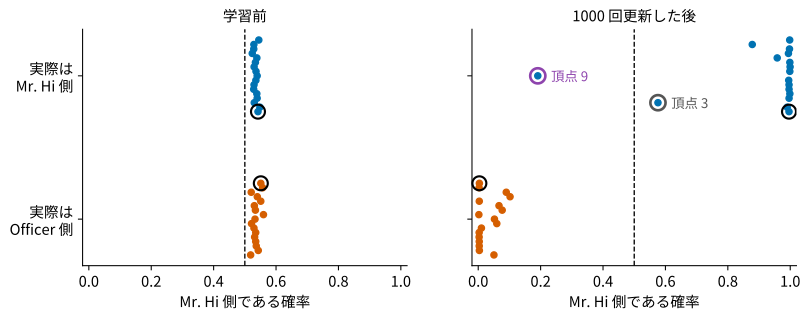
図5 図4 と同じ試行で、各頂点に付けた「Mr. Hi 側である確率」(式(13))。上の段の青が実際に Mr. Hi 側に付いた 17 人、下の段の橙が Officer 側の 17 人で、縦の位置は、点が重ならないように頂点の番号順に等間隔に並べただけである。黒い丸で囲んだ点が、正解を教えた頂点 1(上の段)と 34(下の段)である。点線が 0.5 で、その右なら Mr. Hi 側と予測したことになる。学習前(左)は全員が 0.519〜0.560 の範囲で点線の右にあり、全員を Mr. Hi 側と予測している(当たった 16 頂点は、頂点 1 を除く Mr. Hi 側の 16 頂点)。1000 回の更新の後(右)は、紫の丸の頂点 9(0.191)を除き、上の段は点線の右、下の段は左にある。上の段で点線に最も近いのは灰色の丸の頂点 3(0.576)である。
図4 の試行の予測は、頂点 9 を Officer 側にしたほかは、図3 の色と同じだった。予測を外した頂点 9(図3 の中央付近)は、実際は Mr. Hi 側である。頂点 9 の隣は頂点 1・3・31・33・34 の 5 人で、そのうち 3 人(31・33・34)は実際には Officer 側である(学習ではこの情報は使っていない。これが外れた原因かどうかは調べていない)。また、頂点 9 から頂点 1 と頂点 34 への距離はどちらも 1 なので、後で比べる距離による規則でも決まらない。
100 試行の結果は次の表のとおりである。平均は 32 頂点中 30.97 頂点(96.8%)だった。
| 当たった数 | 32 | 31 | 30 | 29 以下 |
|---|---|---|---|---|
| 試行の数 | 0 | 97 | 3 | 0 |
31 頂点の 97 試行はすべて頂点 9 だけを、30 頂点の 3 試行はすべて頂点 3 と 9 を外した。
この例の は凸関数(勾配降下法)でない。重みが全部 0 の点で勾配が 0(理由は設定の初期値の箇条で示した)なのに、その点の より小さい値(0.0038)を学習でとれるからである(凸関数なら、勾配が 0 の点で最も小さい)。また、この例の は 0 より大きく、最も小さい値をとる点は無い。頂点 1 と 34 を正しく分ける重み(学習で見つかった)で、最後の層の重み を正の数倍すると、最後の層はバイアスが無く が恒等関数なので も同じ数倍になり、その数を大きくすると正解のクラスの確率が 1 に近づいて は 0 に近づくが、0 にはならないからである。種 8 の試行では、1000 回のどの更新でも は前の回より小さくなった(図4)。
訓練用でない頂点の重みの勾配
この節では、式(23) をこの例に当てはめ、訓練用でない頂点に対応する重みも学習で動くことを示す。この例では なので、 は の 行目そのもので、 の 行目は頂点 の特徴にだけ掛かる。以下、これを頂点 の行と呼ぶ。
なので、 である。 の行は、式(23) の後で示したとおり、頂点 1 か 34 から距離 1 以下の頂点の行だけが 0 でなくなりうる。そこにもう一度 が掛かるので、勾配が 0 でなくなりうるのは、頂点 1 か 34 から距離 2 以下の頂点の行である。このグラフでは、訓練用でない 32 頂点のうち 29 頂点が頂点 1 か 34 から距離 1、3 頂点が距離 2 にあり、全頂点の行が学習で動きうる。
式(22) を頂点ごとに書くと、 なので の 行目は 、 は である。つまり は、 から距離 2 以下の頂点の行だけから決まる。どの頂点が当たるかを、この式から導くことはしていない。
また、この特徴は頂点の番号から作るので、番号を付けかえて特徴を作り直すと は ではなく再び になり、式(4) は学習した重みでの予測が番号によらないことを保証しない(100 試行の分布は、初期値が行ごとに同じ分布の乱数なので番号によらない)。全頂点で同じ重みを使うという平均による層の性質は式の上では保たれているが、この例では1層目の重みの数 が頂点の数に比例し、学習した重みはこのグラフにしか使えない。原子の種類のように、どのグラフの頂点にも同じ意味で付く特徴を使えば、重みの数は頂点の数によらず、学習した重みを別のグラフにも使える。
ほかの方法との比較
この節では、同じ問題を2つの別の方法で解いた結果と比べる。1つはグラフを使わない MLP、もう1つはグラフの距離だけを使う規則である。
グラフを使わない MLP。 式(8) の を単位行列 に置きかえると、各頂点は自分のベクトルだけを使う、全結合層 2 個の MLP になる。ほかの設定を同じにした 100 試行で、当たった数の平均は 32 頂点中 16.56 頂点(51.75%)で、ほぼ半分だった。理由は式から分かる。 では頂点 の出力は頂点 の行と だけで決まり、損失 式(16) は頂点 1 と 34 の出力だけで決まるので、頂点 1 と 34 以外の行の勾配は 0 である(式(23) で とした場合)。よって訓練用でない頂点の行は初期値の乱数のまま変わらず、その頂点の予測は、正解と関係なく決まった乱数の行に ReLU を当て、学習した を掛けたもので決まる。
距離による規則。 各頂点を、頂点 1 と頂点 34 のうち距離が短い方と同じ側と予測する規則では、32 頂点のうち 26 頂点で 2 つの距離が異なり、その 26 頂点はすべて当たった。残りの 6 頂点(9・14・20・25・26・32)は 2 つの距離が等しく、この規則では決まらない。等しい頂点を表か裏かで決めると、当たる数の期待値は 頂点である。
GNN(平均 30.97 頂点)は、97 試行で、距離で決まる 26 頂点をすべて当て、距離で決まらない 6 頂点のうち頂点 9 以外の 5 頂点を当てた。この例では、GNN は、グラフを使わないと偶然の水準しか当たらない問題で 30 頂点以上を当て、距離による規則(期待値 29 頂点)より約 2 頂点多く当てた。この差は、距離で決まらない 6 頂点のうち 5 頂点を当てたことから来ている。ただしこれは 34 頂点の1つのグラフでの結果で、GNN が一般にこれらの方法より良いことを示すものではない。
層の選択肢
この章では、平均による層と同じく隣から集めて計算し直す、よく知られた4つの層を、平均による層との違いを示しながら定義し、比較する。どの層も「隣から集める」「集めたものと自分から新しいベクトルを作る」の2段からなり、違いは主に、集めるときに隣に掛ける係数と、自分の扱い方にある(GIN は、集めた後に全結合層を2個以上つなぐ点も違う)。読む順は、メッセージパッシング型、GCN、GraphSAGE、GAT、GIN、比較である。この章では添字 を省き、層の入力を ( 次元)、出力を ( 次元)と書く。重み は、特に断らない限り の行列である。
メッセージパッシング型
この節では、式(5) と 式(6) を一般にした形を示す。 で多重集合(同じ要素が何回現れるかも区別する集合)を表す。 は、自分と隣1つのベクトルから、隣が送る値(メッセージ。ベクトルか、ベクトルと数の組)を作る関数、 は、メッセージの多重集合から1つの値を作る関数(和・平均・最大など)、 は、自分のベクトルと の値から新しいベクトルを作る関数である。
式(24) の形の層をメッセージパッシング型と呼ぶ(辺の特徴を使わない、このページの狭い定義である。辺の特徴も使える広い定義では、辺 に両端の を特徴として付ければ、メッセージを作る関数がそれを使って係数 を掛けられるので(自分の項は から作れる)、GCN も表せる。このページで「式(24) の形」と書くのは、狭い定義のメッセージパッシング型のことである)。平均による層 式(5)〜式(6) は、、 を「和と個数の組」とし、 で を全結合層に入れたものにあたる。・・ が全頂点で同じ関数で、 が多重集合の関数なので、隣をどの順に並べても、頂点にどの番号を付けても結果は同じで、式(4) が成り立つ。
GCN
この節では、Kipf と Welling が 2017 年に発表した Graph Convolutional Network(GCN)の層を示す。式(7) の の代わりに、送る側と受け取る側の両方の の平方根で割った行列を使う。
は対角成分が の対角行列(同様に は対角成分が の対角行列)、 と は と を積んだ行列である。頂点ごとに書くと、 より
である。平均による層との違いは、隣 に掛ける係数が ではなく であることで、隣 の が より大きければ、平均による層より寄与が小さくなる。図1 のグラフでは、頂点 4()が頂点 3()から受け取る係数は、平均による層では 、GCN では (四捨五入)である。係数の和は 1 とは限らない(頂点 4 では )。 は対称行列()で、この性質は過平滑化の証明で使う。
空手クラブの例(例:空手クラブの分裂)で、式(8) の を に置きかえ、ほかを同じにした 100 試行では、当たった数の平均は 32 頂点中 30.94 頂点(96.7%)で、31 頂点が 94 試行、30 頂点が 6 試行だった。平均による層の 30.97 頂点とほぼ同じである。
GCN の係数は隣 の次数 を使うので、 だけからは決まらず、式(24) の形(メッセージが2つの頂点のベクトルだけで決まる形)に入らない。例えば全頂点の特徴が同じとき、辺 だけのグラフの頂点 1 と、道 1−2−3 の頂点 1 は、どちらも隣が1つで、自分と隣のベクトルが等しい。自分のベクトルと隣のベクトルの多重集合が2つの頂点で等しいので、式(24) の形の層は1層目でこの2つに同じ出力を出すが、GCN では隣の頂点 2 の が 2 と 3 で違うので、式(26) の係数が と になり、 なら を当てる前の値が異なる( が恒等関数なら出力も異なる)。
GraphSAGE
この節では、Hamilton らが 2017 年に発表した GraphSAGE の層(平均を使う版)を示す。2つの行ベクトルを横につないだ1つの行ベクトルを と書く。自分のベクトルと隣の平均を混ぜずにつなぎ、全結合層に入れる。
ここでは隣のある頂点()だけを考え、原論文が出力に行う処理(ノルムを 1 にそろえる)は省く。 は の行列で、上の 行が自分のベクトルに、下の 行が隣の平均に掛かる。平均による層では自分も隣も同じ重みが掛かるのに対し、式(27) では別の重みが掛かるので、自分の情報と隣の情報を区別して使える。この論文は、大きなグラフで隣を決めた数だけ選ぶ方法(大きなグラフでの学習)も使った。
GAT
この節では、Veličković らが 2018 年に発表した Graph Attention Network(GAT)の層を示す。隣ごとの係数を、2つの頂点のベクトルから計算する。係数の計算にも学習する重みを使うので、どの隣を重く見るかも学習で決まる。
まず、各 について点数 を計算する。 は 次元の行ベクトルで、学習で決める数(重みの1つ)である。負の側の傾き 0.2 は GAT の原論文の設定である。 とする。
次に、式(13) と同じ softmax で、 の中で和が 1 になる係数に変え、それを使って足す。
すべての が等しければ となり、式(29) はバイアスを 0 にした平均による層と同じになる。原論文は、この計算を別の重みで何組か並べて行い、結果をつなぐ(最後の層では平均する)が、ここでは1組だけを示す。
式(29) は 式(24) の形に書ける。(ベクトルと数の組)とし、 を組の成分ごとの和として、隣 について和 を作る。自分の分 は だけから計算できるので、 で を計算すれば 式(29) に等しい。
GIN
この節では、Xu らが 2019 年に発表した Graph Isomorphism Network(GIN)の層を示す。平均ではなく和で集め、自分のベクトルには 倍の係数を付け、MLP(全結合層をつないだもの)に入れる。 は決めた数か、学習で決める数(重みの1つ)である。
自分に 倍の係数を付けるのは、自分と隣を区別するためである。 だと括弧の中は自分と隣の単純な和で、例えば異なる2つのベクトル について、隣が1つの頂点で、自分が ・隣が の場合と、自分が ・隣が の場合が、どちらも になる。和を使う理由は、GNN の限界の章の和と平均の違いで示す。
比較
この節では、ここまでの5つの層を、式から読める性質で比べる。列は左から、層、定義の式、隣 のベクトルに掛ける係数、係数を学習で決めるか、自分のベクトルの扱い、集め方、式(24) の形に入るか、である。
| 層 | 式 | 隣に掛ける係数 | 係数を学習するか | 自分のベクトルの扱い | 集め方 | メッセージパッシング型に入るか |
|---|---|---|---|---|---|---|
| 平均 | 式(5)・式(6) | しない | 隣と同じ係数・同じ重み | 平均 | 入る | |
| GCN | 式(25)・式(26) | しない | 係数 、隣と同じ重み | 係数付きの和 | 入らない( を使う) | |
| GraphSAGE | 式(27) | しない | 隣と別の重み(行列の上半分) | 平均 | 入る | |
| GAT | 式(28)・式(29) | する | 隣と同じ式の係数 、同じ重み | 和が 1 の係数付きの和 | 入る | |
| GIN | 式(30) | しない(自分の係数の は学習することがある) | 係数 、和の後は隣と同じ MLP | 和 | 入る |
GNN の限界
この章では、GNN では原理的に区別できない場合があることと、連結なグラフで隣との平均をくり返すと頂点の値の差が 0 に近づくことを示す。読む順は、区別の上限を与える WL の色分け、それが上限であることの証明、区別できないグラフの例、和と平均の違い、過平滑化である。
WL の色分け
この節では、グラフの頂点を色で分ける手続き(Weisfeiler–Leman の色分け、以下 WL)を定義する。ここで扱うのは頂点1つずつに色を付ける1次元の WL で、頂点の組に色を付ける高次の WL もある。各頂点の色を、「自分の色」と「隣の色の多重集合」の組で、くり返し細かくしていく手続きである。GNN の層と比べるので、くり返しの回数を層と同じ文字 で数える。頂点 の 回目の色を とし、初めの色を特徴そのものとする。
式(31) の色は組の入れ子だが、実装では、同じ組に同じ整数を割り当てて色を整数にする。2つのグラフを比べるときは、この割り当ての表を2つのグラフで共有する。2つのグラフ 、 に同時に 式(31) を当て、全頂点の特徴が等しいとき、ある で色の多重集合 と が異なれば、2つのグラフは同型でない。同型なら、同型の対応で結ばれる頂点の色が についての帰納法で等しくなるからである(特徴が頂点ごとに違うときは、同型の対応で特徴も一致する場合について同じことが言える)。逆に、すべての で多重集合が等しくても、同型とは限らない。その例を区別できないグラフで示す。
WL による区別の上限
この節では、式(24) の形の層を重ねた GNN が、WL で同じ色になる頂点には必ず同じベクトルを付けることを示す。2つの頂点は同じグラフにあっても、別のグラフにあってもよい。
主張。 式(24) の形の層を 個重ねた GNN で、 ならば である。
証明。 についての帰納法による。 では 、 なので成り立つ。 で成り立つとし、 とする。式(31) より、 で、かつ隣の色の多重集合が等しい。多重集合が等しいので、 から への1対1の対応 で、 となるものがある。帰納法の仮定より 、 である。よって がすべての で成り立ち、式(24) の に入る多重集合が等しい。 の2つの入力が等しいので、 である。∎
この主張から、2つのグラフの色の多重集合が で等しければ、色の等しい頂点どうしを1対1に対応させられ、対応する頂点の出力が等しいので、頂点の出力の多重集合も等しく、式(15) の和 も等しい。つまり、WL で区別できない2つのグラフは、式(24) の形の層と 式(15) の和を使う GNN では、重みをどう選んでも同じ出力になる。
GCN の場合。 式(24) の形に入らない GCN でも、WL の回数を 1 つ進めれば同じことが言える。主張は「 ならば、GCN の 層目の出力が等しく、」で、 についての帰納法で示す。 では、 なら 式(31) より で、隣の色の多重集合の大きさ(次数)も等しい。 で成り立つとし、 とする。式(31) より で、 から への1対1の対応 で となるものがある。帰納法の仮定を と各 に当てると(式(26) の和のうち の項は の の項に対応させる)、 層目の出力と がそれぞれ等しいので、式(26) の和の項が と で対応して等しく、 層目の出力が等しい。 は から仮定で既に分かっている。∎ よって、層が 個の GCN では、2つのグラフの WL の色の多重集合が 回目で等しければ、式(15) の和も等しい。
区別できないグラフ
この節では、WL でも GNN でも区別できない、同型でない2つのグラフを示す。6 頂点の閉路のグラフ(以下、閉路のグラフ)と、三角形 2 つからなるグラフ(以下、三角形のグラフ)を考える。どちらも 6 頂点・6 辺で、全頂点の次数が 2 である。三角形のグラフには三角形(長さ 3 の閉路)があり閉路のグラフには無いので、2つは同型でない。
全頂点の特徴を同じベクトルにすると、WL の色は全頂点で等しいままである。 回目に全頂点の色が同じ値 なら、どの頂点も隣が 2 つなので、 回目の色は全頂点で になるからである。2つのグラフの色の多重集合は、どの でも「同じ色が 6 個」で等しい。よって前節の主張から、式(24) の形の GNN も GCN も、2つのグラフに同じ出力を出す。
三角形があるかどうかも、連結かどうか(閉路のグラフは連結、三角形のグラフは連結でない)も、競技プログラミングなら幅優先探索や辺ごとの共通の隣の数で分かる性質だが、隣の色の多重集合しか見ない WL と、それより細かく区別できない GNN では区別できない。
和と平均の違い
この節では、式(30) の GIN が平均ではなく和を使う理由を示す。WL による区別の上限の主張は「WL で同じ色なら GNN でも同じ」で、逆が成り立つかは と の選び方による。集めたものを平均にすると( 自体が平均の場合も、平均による層のように が和と個数を返し で割る場合も同じ)、WL で区別できるものも区別できなくなる場合がある。
全頂点の特徴が (1 次元)のとき、隣が1つの頂点と隣が2つの頂点を考える。隣のベクトルの多重集合は と で異なり、WL の色も1回目で異なる。しかし平均をとるとどちらも で、式(5) の平均(自分を含む)でも で同じになる。和なら と で異なる。平均は割合しか残さず、個数を捨てるからである。最大値も同じ理由で個数を捨てる。
詳しくはこちら(和を使うと WL と同じだけ区別できるという結果)
Xu らの論文(2019、GIN の原論文)は次のことを示した。頂点の特徴がとりうる値が有限個か可算個のとき、各層の と が単射(異なる入力には異なる出力を返す)で、グラフ全体をまとめる関数(式(15) の和の代わりのもの)も単射なら、式(24) の形の GNN は WL と同じだけグラフを区別できる(WL が色の多重集合で区別する2つのグラフには、層を十分重ねれば異なる出力を出せる)。また、とりうる値が有限個か可算個で、大きさに上限のある多重集合については、各要素に適当な関数 を当てて足す の形で単射な関数を作れる。GIN の 式(30) の MLP は、このような関数を近似するために置いたものである(MLP が有界閉集合の上の連続関数をいくらでも近く近似できるという結果(普遍近似定理)を使う)。このページではこれらを証明しない。ここで示したのは、平均と最大値が単射でない例だけである。
過平滑化
この節では、連結なグラフで隣との平均をくり返すと全頂点の値がそろうことを示す。隣との平均をくり返して全頂点の値が1つの値に近づくことを、このページでは過平滑化と呼ぶ(連結でないグラフでは、 が連結成分ごとの区画に分かれるので、下の証明を連結成分ごとに当てはめると、成分ごとに、その成分の値を に比例する割合で平均した値に近づく)。重みと活性化関数を除き、式(7) の を何回も掛ける部分だけを取り出して調べる。頂点ごとの値を並べた 次元の列ベクトル に を 回掛けると、グラフが連結なら次の値に近づく。
式(32) の右辺は、全成分が同じ値( の成分を に比例する割合で平均した値)のベクトルである。つまり、平均をとる操作を何回もくり返すと、初めの値がどうであっても、全頂点が同じ値に近づく。
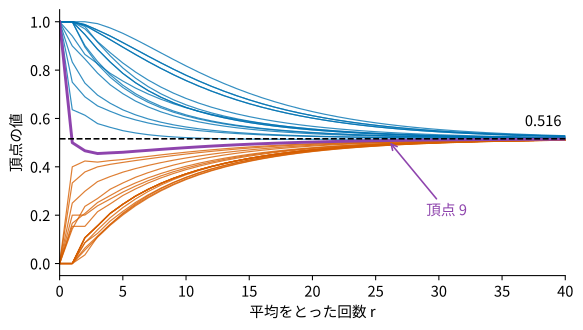
図6 空手クラブのグラフで、Mr. Hi 側の 17 頂点に 1、Officer 側の 17 頂点に 0 を置いた に、 を 回掛けた値。線 1 本が頂点 1 つで、色は実際に付いた側(青が Mr. Hi 側、橙が Officer 側)である。図6 は過平滑化を見せるための計算で、全頂点の正解を初めの値に使っており、空手クラブの学習の課題とは別である。 が増えると全部の線が点線の値 0.516(式(32) の値。、Mr. Hi 側の の和が 98 で、 を四捨五入)に集まる。紫の太線は Mr. Hi 側の頂点 9 で、自分を含む 6 頂点のうち 3 頂点が 0 なので で 0.5 になり、 で 0.466・0.455(四捨五入)と点線から離れたあと、点線より下から 0.516 に近づく。
図6 で、全頂点の値の最大と最小の差は、 で 0.964、 で 0.470、 で 0.019 である(四捨五入)。 までのどの でも、Mr. Hi 側の最小値( ではどの でも頂点 9 の値)は Officer 側の最大値より大きく、ある値を境に2つの側を分けられる。しかしその差は で 0.100、 で 0.019、 で 0.00075 と小さくなり、式(32) より 0 に近づく。差が小さくても、重みで引き伸ばせば2つの側を分けられる場合はある。重みや ReLU を挟んだ GNN で値がそろうことがどの程度問題になるかは、このページでは示していない(確認できていない点)。
式(32) の証明では、自分への辺を足した を使うことで、2部グラフ(頂点を2組に分けて、辺がすべて組の間にあるようにできるグラフ)でも収束することが言える。自分への辺が無い で平均すると、例えば辺が1本だけのグラフ(頂点 1 と 2)では、平均する行列が で、掛けるたびに2つの値が入れ替わるだけで、1つの値に近づかない。下の証明では、この違いが固有値 の部分に現れる。
詳しくはこちら(式(32) の証明)
GCN の 式(25) の を使う。 なので、
である(掛け合わせると間の が消える)。 は実対称行列なので、実対称行列の固有値分解の定理(スペクトル定理)より、互いに直交するノルム 1 の固有ベクトル (列ベクトル)と実数の固有値 があり、 と書ける。これを 回掛けると、 は で 1、 で 0 なので交差する項が消え、 となる。 は固有値 1 の固有ベクトルである。 で、 の 成分は の大きさ なので 、よって だからである。以下、固有値がすべて で、 の固有ベクトルが の定数倍に限ることを示す。
()とし、 とおく。両辺に左から を掛けると で、、 なので、 である( は実対称行列なので、 は実ベクトルにとれる)。左から を掛けて
を得る。次の2つの等式を使う。 を対角成分が の対角行列とすると である。 では各辺 が と の2回現れるので で、 では各辺 が と を1回ずつ足すので である。よって
である。同様に で、
である。式(34) と 式(35) より なので である。等号は、すべての辺で のときで、グラフが連結なら(任意の2頂点を道で結び、道の辺ごとに値が等しいことをたどれるので) の成分が全部等しいとき、つまり が の定数倍のときに限る。式(34) と 式(36) より なので である。
実対称行列では、固有値 が の中に現れる回数は、 の固有ベクトル全体(と 0)がなす空間の次元に等しい(スペクトル定理)。 の固有ベクトルは の定数倍に限るのでこの次元は 1 で、 はちょうど1回現れる。よって 、 とでき、 では で である。 なので となり、式(33) に入れると
である。 なので、式(37) は 式(32) と同じである。∎
GCN の を 回掛けた場合は、同じ計算で となり、頂点 の値は に比例する。この場合も、頂点の値の違いは次数の違いだけになる。
確かめ問題
この章では、平均による層と和と平均の違いの内容を、手で計算して確かめる問題を2つ出す。解答は各問題の直後の折りたたみにある。
問題1。 数値例のグラフで、2層目にも同じ重み 式(11) とバイアス 0、ReLU を使う。頂点 4 の2層目の出力 を求めよ。
問題2。 中心の頂点 1 と、頂点 1 にだけつながる頂点 2・3・4 からなるグラフ(星形)で、全頂点の特徴を とする。平均による層 式(5)〜式(6) を何層重ねても、頂点 1 と頂点 2 の出力が等しいことを示せ。また、式(5) の平均を和 に置きかえると、1層目の集めた値が異なることを確かめよ。
解答(問題2)
についての帰納法で、「 層目の出力が全頂点で同じベクトル 」を示す。 では全頂点の特徴が なので成り立つ。 で成り立てば、式(5) で頂点 1 は 個、頂点 2 は 個の の平均をとるので、どちらも である(頂点 3・4 も同じ)。式(6) は全頂点で同じ重みを使うので、 も全頂点で等しい。よって何層重ねても頂点 1 と 2 の出力は等しい。
和にすると、1層目の集めた値は、頂点 1 で 、頂点 2 で で、異なる。平均では個数(次数)の情報が消えるが、和では残る(和と平均の違い)。
確認できていない点
- 空手クラブの例の数値は、このページで決めた1つの設定(層の数 2、1層目の次元 16、学習率 0.2、1000 回、初期値の乱数の種 0〜99)だけで測った。設定を変えたときの結果や、平均による層と GCN のどちらが一般に良いかは調べていない。
- 実際に使われている例の3つの論文は、arXiv の題名・著者・概要しか確かめておらず、本文の手法の詳細は読んでいない。
- 重みと ReLU を含む GNN で値がそろう(過平滑化する)条件は、このページでは証明していない。証明したのは 式(32) の、 だけをくり返し掛けた場合である。
- 大きなグラフでの学習の、隣を選ぶ方法で勾配がずれることの影響は調べていない。
- GIN が WL と同じだけ区別できるという結果(和と平均の違いの折りたたみ)は、原論文の主張を書いただけで、このページでは証明していない。
参考
- Kipf, Welling「Semi-Supervised Classification with Graph Convolutional Networks」(ICLR 2017): https://arxiv.org/abs/1609.02907
- Hamilton, Ying, Leskovec「Inductive Representation Learning on Large Graphs」(NeurIPS 2017、GraphSAGE): https://arxiv.org/abs/1706.02216
- Veličković ほか「Graph Attention Networks」(ICLR 2018): https://arxiv.org/abs/1710.10903
- Xu, Hu, Leskovec, Jegelka「How Powerful are Graph Neural Networks?」(ICLR 2019、GIN): https://arxiv.org/abs/1810.00826
- Gilmer ほか「Neural Message Passing for Quantum Chemistry」(ICML 2017): https://arxiv.org/abs/1704.01212
- Ying ほか「Graph Convolutional Neural Networks for Web-Scale Recommender Systems」(KDD 2018): https://arxiv.org/abs/1806.01973
- Derrow-Pinion ほか「ETA Prediction with Graph Neural Networks in Google Maps」(CIKM 2021): https://arxiv.org/abs/2108.11482
- Glorot, Bengio「Understanding the difficulty of training deep feedforward neural networks」(AISTATS 2010):重みの初期値の範囲
- Weisfeiler, Leman「The reduction of a graph to canonical form and the algebra which appears therein」(1968):Weisfeiler–Leman の名前の由来の論文。機械学習の文献でこの色分けの出典として挙げられるが、この手続きそのものがこの論文にあるかは確かめていない
- Zachary「An Information Flow Model for Conflict and Fission in Small Groups」(Journal of Anthropological Research、1977):空手クラブのデータの出典
- 図と数値を作ったプログラム:wiki のデータリポジトリの
グラフニューラルネットワーク/figures.py。乱数の種を固定してあり、python3 figures.py <図の保存先>で、図を保存し、空手クラブ・GCN・過平滑化の数値と、勾配の式の確かめ(grad_check)を JSON で出す。図の保存には hamko-admin のagents/skills/math-tex-explainer/svgfig.pyを使う。